Claude Opus 5.5 너프설 팩트체크: 정말 성능이 떨어졌을까
Claude Opus 5.5가 출시된 직후 X와 Reddit, GitHub에는 “처음보다 답이 나빠졌다”, “연산량을 줄인 것 아니냐”, “낮은 모델로 몰래 바뀐 것 같다”는 주장이 등장했다. 매일 같은 저장소에서 Claude Code를 쓰는 사람에게 갑작스러운 누락과 반복 수정은 단순한 기분 문제가 아니다. 다만 품질 저하를 느꼈다는 사실과 Opus 5.5 모델 자체가 출시 후 하향 조정됐다는 주장은 구분해야 한다.
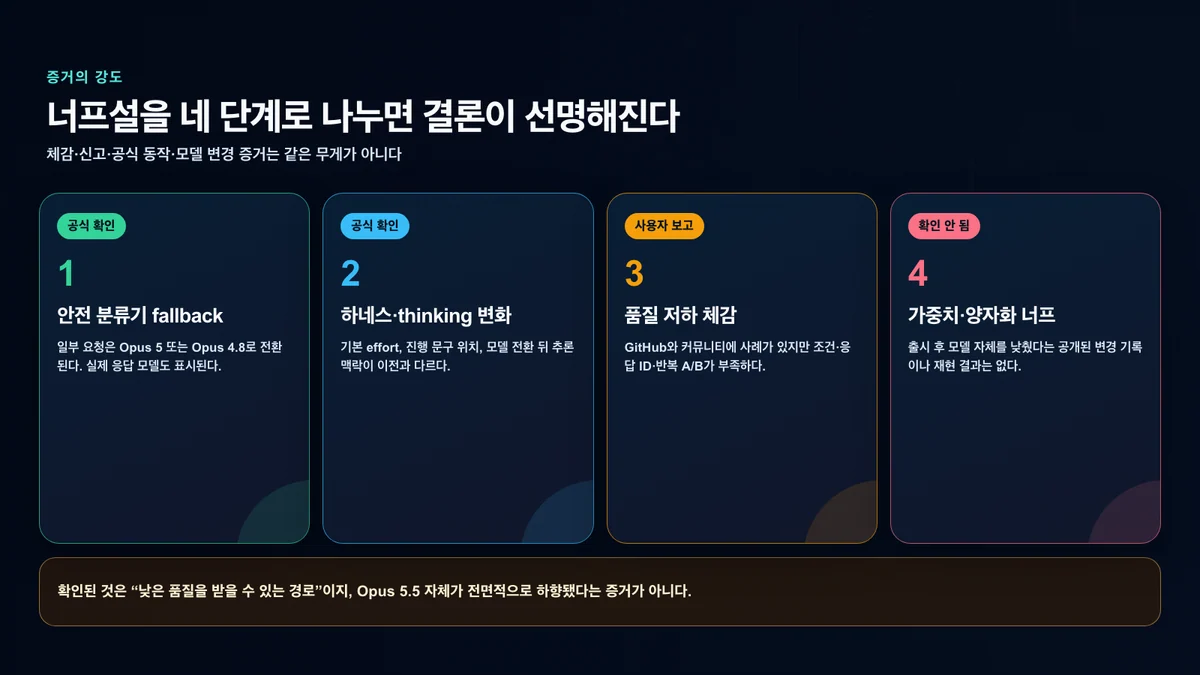
현재 공개된 근거를 종합하면 Opus 5.5의 가중치나 양자화 수준이 출시 뒤 전면적으로 낮아졌다고 입증할 자료는 없다. 반면 Anthropic이 공식 확인한 자동 fallback, 기본 effort 변화, thinking 표시 방식, 긴 대화의 컨텍스트와 모델 전환 문제는 실제로 “너프된 것 같은 경험”을 만들 수 있다. 과거에는 모델 가중치 변경이 아닌 인프라 버그가 응답 품질을 낮춘 사례도 있었다. 따라서 이번 논쟁의 정확한 결론은 “체감은 무시할 수 없지만 원인은 아직 모델 너프로 확인되지 않았다”다.
세 줄 요약
- X·Reddit·GitHub에는 품질 저하 신고가 있지만, 동일 입력을 같은 조건에서 반복한 A/B 자료는 아직 부족하다.
- Claude 앱과 Claude Code에서는 일부 요청이 Opus 5 또는 Opus 4.8로 자동 전환될 수 있고, 파일·메모리·웹 검색 결과도 분류 대상이다.
- Opus 5.5의 기본 effort는
medium이다. 기본값이high였던 Opus 5와 설정을 생략한 채 비교하면 같은 조건이 아니다.
‘너프’라는 말에는 서로 다른 세 가지 주장이 섞여 있다
첫 번째는 모델 가중치, 양자화 수준 또는 추론 예산을 제공사가 조용히 낮췄다는 주장이다. 이것이 가장 강한 의미의 모델 너프다. 이 주장을 확인하려면 고정된 모델 스냅샷, 동일한 하네스, 반복 평가와 변경 전후 로그가 필요하다. 현재 공개된 신고에는 이 수준의 자료가 없다.
두 번째는 사용자가 Opus 5.5를 골랐지만 특정 요청을 실제로는 Opus 5나 Opus 4.8이 처리한 경우다. 이는 추측이 아니라 Anthropic이 문서화한 fallback이다. 결과가 약하게 느껴질 수 있지만, Opus 5.5 자체의 성능을 낮춘 것과는 다른 현상이다.
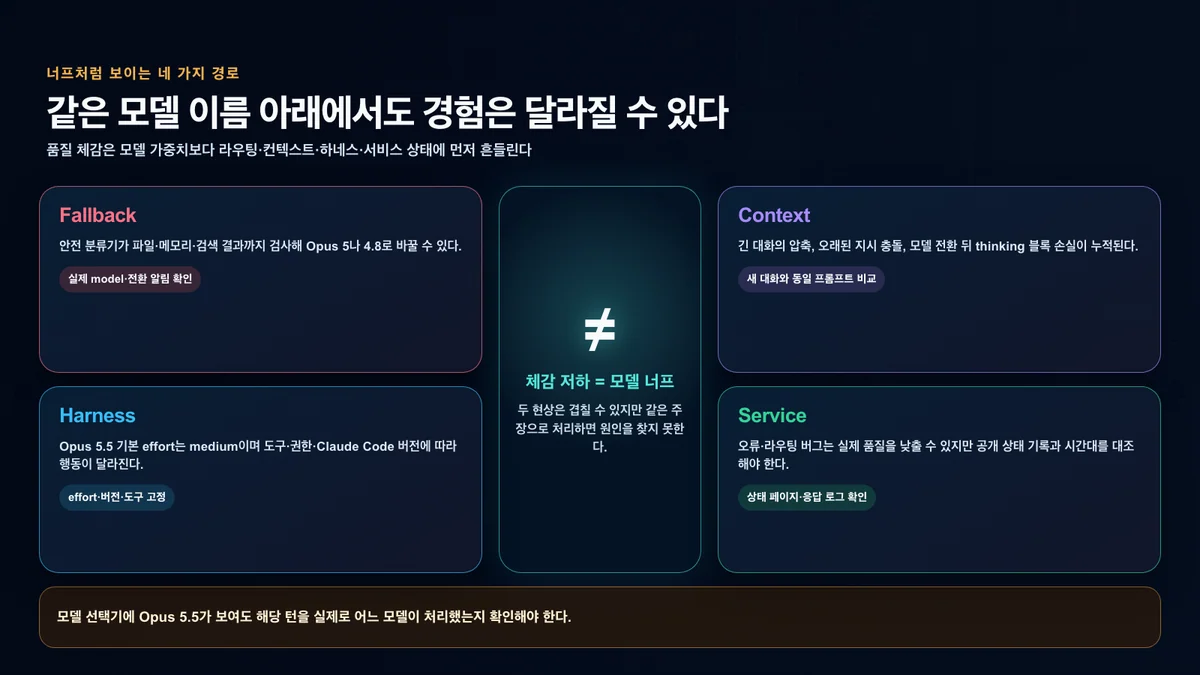
세 번째는 모델 밖의 실행 환경이 바뀐 경우다. effort 기본값, Claude Code 버전, 도구 권한, 컨텍스트 압축, 메모리, 프롬프트 캐시, 서비스 장애와 라우팅 버그가 여기에 포함된다. 사용자는 완성된 응답만 보기 때문에 세 가지 원인을 모두 “모델이 멍청해졌다”로 느낄 수 있다.
X에서 확인되는 것은 출시 사실과 초기 기대다
Anthropic은 2026년 9월 22일 X에서 Opus 5.5 출시를 알렸다. 이 게시물은 출시 시점과 공식 제품의 존재를 확인하는 1차 자료지만, 출시 후 품질이 계속 동일하게 유지됐는지까지 증명하지는 않는다.
출시 직후에는 Opus 5보다 크게 좋아졌다는 긍정 반응도 나왔다. 이런 반응은 초기 기대와 체감을 보여 주지만 독립 벤치마크는 아니다. 반대로 “너프하지 말라”는 X 게시물도 빠르게 확산했다. 아직 하향 조정이 확인되기 전부터 과거 경험에 근거한 불신이 먼저 나타난 셈이다.
X 반응을 읽을 때는 게시 시각과 근거를 함께 봐야 한다. “처음에는 훌륭했지만 지금은 나빠졌다”는 문장만으로는 대화 길이, 실제 응답 모델, effort, Claude Code 버전과 입력이 확인되지 않는다. 강한 체감 자료일 수는 있어도 서버 측 모델 변경을 입증하는 로그는 아니다.
Reddit의 첫 너프 글은 출시 직후 풍자와 함께 등장했다
r/ClaudeCode의 ‘Opus 5.5 nerfed?’ 글은 처음에는 매우 좋았지만 곧 수정 작업이 늘었다고 주장한다. 그러나 댓글에서는 게시물이 출시 후 매우 짧은 시간 안에 올라왔다며 성급한 판단이나 반복되는 출시 의례에 가깝다는 반응도 이어졌다. 한 번의 나쁜 세션과 장기적인 성능 하락을 구분해야 한다는 점을 커뮤니티 자체가 보여 준 사례다.
‘너프하지 말라’는 별도 토론은 더 중요한 배경을 드러낸다. 이용자들은 과거 모델에서 느낀 변화 때문에 새 모델도 곧 낮아질 것이라고 예상했다. 동일 테스트를 매일 실행해 장기 변화를 추적하자는 제안도 나왔지만, 아직은 검증 계획이지 결론이 아니다. Hacker News 출시 토론에서도 높은 초기 평가와 향후 너프 우려가 동시에 나타났다.
이 자료들은 ‘너프설이 왜 빨리 확산했는가’를 설명하는 데 유용하다. 하지만 댓글 수, 공감 수와 강한 표현은 가중치 변경의 기술적 증거가 아니다.
GitHub 이슈는 실제 신고지만 전면 너프의 증명은 아니다
Anthropic의 Claude Code 저장소에는 9월 23일 ‘Opus 5.5 performance degradation’ 이슈 #96205가 등록됐다. 작성자는 Windows와 Claude Code 2.1.280 환경에서 하루 동안 품질이 크게 나빠졌다고 설명했고, 이슈에는 bug, platform:windows, area:model 라벨이 붙었다.
이 신고를 무시할 이유는 없다. 특정 환경에서 회귀가 발생했을 가능성, 다른 모델이 응답했을 가능성 또는 인프라 문제가 있었을 가능성을 조사할 출발점이다. 다만 이슈에는 재현 프롬프트, 응답 ID, 실제 응답 모델, effort 값, 토큰 사용량, 같은 조건의 반복 결과가 없다. 오류 로그도 비어 있고 비교 대상 출력도 제공되지 않았다. 따라서 “문제가 없었다”는 증거도 아니지만 “모델 전체가 너프됐다”는 증거도 아니다.
가장 강한 공식 설명은 자동 fallback이다
Anthropic 도움말에 따르면 Opus 5와 5.5는 모든 사용자 요청에 안전 분류기를 적용한다. 검사 범위는 방금 입력한 문장만이 아니다. Claude가 읽는 메모리, 커넥터 콘텐츠, 웹 검색 결과와 첨부 파일도 포함된다.
분류 결과에 따라 다음과 같은 전환이 가능하다.
- 일부 고위험 사이버 보안 요청은 Opus 4.8로 전환될 수 있다.
- 바이러스학, 독성학과 분자 설계 같은 일부 이중용도 생명과학 요청은 Opus 5로 전환될 수 있다.
- 특정 프런티어 LLM 개발 작업은 Opus 5로 전환될 수 있다.
- 내부 추론을 그대로 추출하려는 요청은 다른 모델로 넘기지 않고 차단될 수 있다.
Claude 웹·모바일·데스크톱과 Claude Code에서는 자동 모델 전환이 기본 활성화될 수 있다. 전환이 발생하면 알림이 표시되고 답한 모델의 이름도 바뀐다. 이후 모델 선택기가 낮은 모델에 머무를 수 있으며, 기존 대화에 원인 요청이 남아 있으면 Opus 5.5를 다시 선택해도 같은 fallback이 반복될 수 있다. 설정의 Switch models when a message is flagged를 끄면 자동 전환 대신 해당 요청이 멈춘다.
이 기능은 “몰래 가중치를 낮췄다”는 주장과 다르다. 다만 사용자가 알림이나 응답 모델 표시를 놓치면 Opus 5.5의 품질이 갑자기 낮아졌다고 해석하기 쉽다.
API에서는 실제로 답한 모델을 로그로 확인할 수 있다
Claude API의 거부와 fallback 문서는 관찰 방법을 더 구체적으로 설명한다. API의 자동 fallback은 기본값이 아니며 개발자가 구성해야 한다. 전환을 사용한 경우에는 다음 세 곳을 함께 확인해야 한다.
- 응답 최상위
model: 최종 답변을 만든 실제 모델 fallback콘텐츠 블록: 어느 모델에서 어느 모델로 넘어갔는지 표시usage.iterations: 각 시도와fallback_message, 모델별 토큰 사용량 기록
안전 분류기의 거절만 fallback을 유발한다. rate limit, overload와 서버 오류는 자동으로 낮은 모델에 넘기는 직접 원인이 아니다. 한 번 fallback된 대화는 약 1시간 동안 같은 낮은 모델로 바로 라우팅되는 sticky routing의 영향을 받을 수도 있다. 이때 현재 턴에 새 fallback 블록이 없더라도 usage.iterations와 최상위 model로 실제 처리 모델을 확인할 수 있다.
기본 effort 차이는 같은 모델 비교를 어긋나게 만든다
Opus 5.5 변경 문서는 기본 effort가 medium이라고 명시한다. Opus 5에서 effort를 생략하면 기본값은 high였다. 두 모델 모두 설정을 쓰지 않고 실행한 뒤 Opus 5.5가 덜 깊게 검토한다고 느꼈다면, 실제로는 서로 다른 추론 조건을 비교했을 수 있다.
Opus 5.5는 adaptive thinking이 항상 켜져 있고 완전히 끌 수 없다. 같은 effort에서도 전작보다 더 많이 생각하는 경향이 있어 max_tokens가 지나치게 낮으면 답에 쓸 공간이 줄어들 수 있다. 공정한 비교를 하려면 medium, high, xhigh 같은 값을 명시하고 출력 한도까지 같게 맞춰야 한다.
이 차이는 특히 Claude Code와 자체 API 도구에서 중요하다. 모델 ID만 바꾸고 예전 설정을 그대로 유지하면 강제 도구 호출 오류, 진행 표시 공백과 출력 예산 부족을 모델 품질 문제로 오해할 수 있다.
thinking 표시 변화는 멈춘 것처럼 보이게 할 수 있다
Opus 5.5에서는 도구 호출 사이의 짧은 진행 문구가 일반 텍스트가 아니라 thinking 블록으로 돌아온다. 기본 display: "omitted"에서는 그 문구가 빈 내용처럼 보일 수 있다. 도구가 계속 실행 중이어도 앱 화면은 한동안 조용해져, 사용자는 모델이 멈췄거나 이전보다 덜 적극적이라고 느낄 수 있다.
또 Opus 5.5의 thinking 블록은 모델과 대화에 결합돼 있다. Opus 5.5에서 다른 모델로 전환하면 일부 모델은 이전 thinking 블록을 읽지 못한다. 공식 문서상 Fable 5.1과 Mythos 5.1을 제외한 fallback 모델에서는 Opus 5.5 thinking 블록이 제거될 수 있다. 요청 자체는 성공하므로 표면에는 오류가 없지만, 긴 작업의 계획 연속성이 약해진 것처럼 보일 수 있다.
따라서 “처음에는 계획을 잘 지켰는데 갑자기 앞의 결정을 잊었다”는 현상은 모델 너프 외에도 전환, 컨텍스트 압축과 thinking 연속성에서 원인을 찾아야 한다.
긴 대화는 새 대화와 다른 시험 환경이다
수십 차례 수정한 Claude Code 세션에는 오래된 요구사항, 폐기된 파일 경로, 실패한 도구 결과와 압축된 요약이 함께 남는다. 새 모델로 바꿔도 이 기록은 그대로다. 프롬프트 한 줄이 같아도 실제 입력 컨텍스트는 출시 첫날의 새 대화와 전혀 다를 수 있다.
한국 이용자가 먼저 해볼 수 있는 확인은 단순하다.
- 문제가 난 대화는 보존하고 동일 요청을 새 대화에서 실행한다.
- 모델 선택기와 해당 응답에 표시된 모델이 모두 Opus 5.5인지 확인한다.
- 자동 모델 전환 알림과 Claude Code의
Config > MODEL & OUTPUT설정을 확인한다. - effort를 명시하고 Claude Code 버전, 도구와 권한을 기록한다.
- 파일·메모리·웹 검색 결과에 안전 분류기를 자극할 내용이 있는지 점검한다.
새 대화에서는 정상이고 긴 대화에서만 반복된다면, 그것은 중요한 품질 문제지만 모델 가중치 너프보다 컨텍스트와 실행 환경을 먼저 의심할 근거가 된다.
과거에는 인프라 버그가 실제 품질을 낮춘 적이 있다
Anthropic은 2025년 9월 세 가지 품질 저하 문제의 사후 분석을 공개했다. 당시 컨텍스트 길이에 따른 잘못된 서버 라우팅, TPU 출력 손상과 컴파일 문제가 겹치면서 일부 요청의 응답 품질이 실제로 떨어졌다. 이용자 신고가 먼저 늘었지만 내부 자동 평가가 이를 빠르게 식별하지 못한 부분도 인정했다.
회사는 수요, 시간대나 서버 부하 때문에 의도적으로 모델 품질을 낮추지 않는다고 밝혔다. 이 설명은 ‘고의적인 너프’ 주장에 반대되는 공식 입장이다. 동시에 그 사후 분석은 모델 가중치를 건드리지 않아도 사용자가 겪는 품질이 낮아질 수 있고, 초기 내부 지표가 놓칠 수 있음을 보여 준다.
그러므로 “가중치 너프 증거가 없다”와 “서비스 품질 문제도 없었다”는 같은 문장이 아니다. Opus 5.5의 지속적인 회귀를 주장하려면 상태 페이지, 응답 ID, 지역·플랫폼과 반복 평가를 함께 모아야 한다.
20~30회 A/B 검증은 이렇게 해야 한다
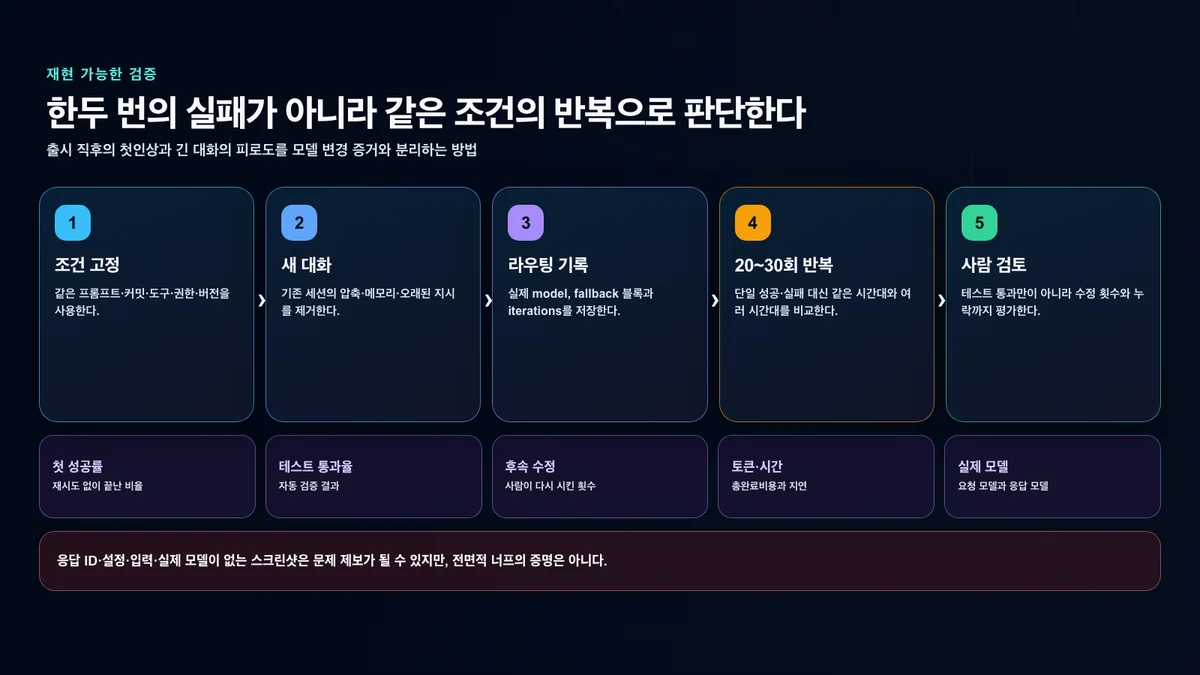
한 번 잘못 만든 코드나 한 장의 스크린샷만으로는 무작위 편차와 구조적 변화를 나누기 어렵다. 개인도 다음 방식으로 훨씬 강한 자료를 만들 수 있다.
- 정답이나 테스트를 확인할 수 있는 과제 10개 이상을 정한다.
- 같은 프롬프트, 저장소 커밋, Claude Code 버전, 도구와 권한을 고정한다.
- 새 대화에서 effort와 출력 한도를 명시한다.
- 각 실행의 날짜·시각, 응답 ID, 요청 모델과 실제 응답 모델을 기록한다.
- 같은 조건을 20~30회 반복하고 서로 다른 시간대에서도 재실행한다.
- 첫 시도 성공률, 테스트 통과율, 누락, 후속 수정 횟수, 총토큰과 완료 시간을 비교한다.
API 사용자는 model, fallback 블록과 usage.iterations를 저장해야 한다. 구독형 Claude 앱 이용자는 동일한 수준의 서버 로그를 얻기 어렵기 때문에 모델 전환 알림, 응답 표시, 새 대화 비교와 화면 기록이 중요하다. 회사 기밀이나 개인정보가 들어간 전체 프롬프트를 공개할 필요는 없지만, 제3자가 조건을 이해할 수 있는 비식별 요약은 필요하다.
현재 판정
2026년 9월 27일 기준 공개 자료가 지지하는 결론은 다음과 같다.
- 확인됨: 일부 Opus 5.5 요청은 안전 분류기에 따라 Opus 5 또는 Opus 4.8로 fallback될 수 있다.
- 확인됨: Opus 5.5의 기본 effort는
medium이며 Opus 5의high와 다르다. - 확인됨: thinking 표시와 모델 전환 뒤 추론 맥락 처리 방식이 바뀌었다.
- 확인됨: GitHub, X, Reddit과 Hacker News에 품질 저하 체감과 향후 너프 우려가 존재한다.
- 미확인: Anthropic이 출시 후 Opus 5.5의 가중치, 양자화 또는 전반적 연산량을 낮췄다는 주장.
따라서 이번 너프설을 완전히 거짓이라고 단정하는 것도, 사용자 체감만으로 모델 자체가 하향됐다고 확정하는 것도 이르다. 가장 먼저 실제 응답 모델과 effort를 확인하고, 새 대화에서 같은 조건을 반복해야 한다. 그 뒤에도 통계적으로 일관된 하락이 남는다면 응답 ID와 환경 정보를 갖춘 회귀 신고가 다음 단계다.
출처와 이용 고지
- Anthropic, Claude Opus 5.5 공식 발표
- Anthropic 도움말, Opus 5·5.5 대화에서 모델이 전환되는 이유
- Claude Platform, 거부와 fallback
- Claude Platform, Opus 5.5 변경 사항
- Anthropic, 2025년 세 가지 품질 문제 사후 분석
- GitHub, Claude Code 이슈 #96205
- Reddit, Opus 5.5 nerfed?
- Reddit, Dear Anthropic please do not nerf
- Hacker News, Claude Opus 5.5 출시 토론
- Anthropic 공식 X 출시 게시물
Anthropic과 Claude 명칭 및 상표는 각 권리자에게 속한다. 쥬곰닷컴은 Anthropic의 후원·승인을 받은 공식 사이트가 아니다. 이 글은 공식 문서, 단일 사용자 신고와 커뮤니티 반응의 증거 수준을 구분했으며 X 캡처, 공식 차트와 제3자 사진을 복제하지 않았다.