JEV를 Codex에 연결하는 방법: GPT는 실행하고 JEV는 판단한다
Codex는 코드를 읽고 쓰며 터미널, 브라우저와 외부 도구를 다루는 범용 코딩 에이전트다. 반면 TypeSafe AI의 JEV는 긴 답변을 만들어 내는 챗봇이 아니라, 주어진 상태를 보고 정해진 선택지·순서가 있는 점수·예일 확률을 돌려주는 판단 모델이다. 둘을 연결하는 목적은 Codex를 JEV로 바꾸는 것이 아니다. Codex가 계속 작업을 지휘하되, 분류나 라우팅처럼 범위가 좁은 결정을 JEV에 한 번 묻는 것이다.
이 차이를 놓치면 설치 방향부터 틀어진다. JEV는 Codex의 모델 선택기에서 GPT나 DeepSeek 대신 고르는 모델이 아니다. TypeSafe의 코딩 에이전트 설명도 JEV가 텍스트 생성, 코드 작성, 대화와 도구 호출을 담당하지 않는다고 선을 긋는다. 실제 연결 지점은 모델 선택기가 아니라 MCP 도구 또는 애플리케이션 API 호출이다.
결론부터 말하면, Codex가 증거를 모으고 실행하며 JEV는 잘 정의된 한 가지 판단만 보조하는 구조가 가장 안전하다. JEV의 확률은 유용한 신호지만 권한, 보안 테스트와 사람의 승인을 대신할 수 없다.
세 줄 요약
- JEV를 연결해도 Codex의 기본 GPT·DeepSeek 모델, 대화, 파일과 도구 환경은 그대로 유지된다.
- 공식 TypeSafe 스킬은 사용법을 알려주는 지식 계층이고, 대화 중 직접 호출하려면 별도 MCP 서버나 애플리케이션 코드가 필요하다.
- Choice·Score·Noul은 라우팅과 위험 평가에 적합하지만 계산, 날짜 비교, 자유형 생성과 자동 배포 승인은 Codex·코드·사람이 맡아야 한다.
JEV는 어떤 모델인가
TypeSafe의 소개 문서는 JEV를 자사의 첫 System One 모델로 설명한다. 일반 대형언어모델처럼 문장을 자유롭게 이어 쓰기보다, 동일한 state를 놓고 이름이 붙은 질문을 평가해 코드가 바로 읽을 수 있는 값을 반환한다.
지원하는 판단 형식은 세 가지다.
Choice: 명시된 선택지 중 하나를 고른다.Score: 낮음에서 높음처럼 순서가 정의된 단계 중 하나를 고른다.Noul: 한 명제가 참일 확률, 즉 예일 확률을 0부터 1 사이로 반환한다.
여러 질문을 같은 요청에 넣을 수도 있다. 예를 들어 하나의 코드 변경 상태를 두고 다음 단계, 위험 수준, 지금 배포해도 되는가를 각각 독립 질문으로 보낼 수 있다. 이때 한 질문 안에 세 판단을 모두 숨기지 않는 것이 중요하다. TypeSafe는 복합 결정을 원자적인 질문으로 나누고, 결과 조합은 애플리케이션 코드가 맡도록 권장한다.
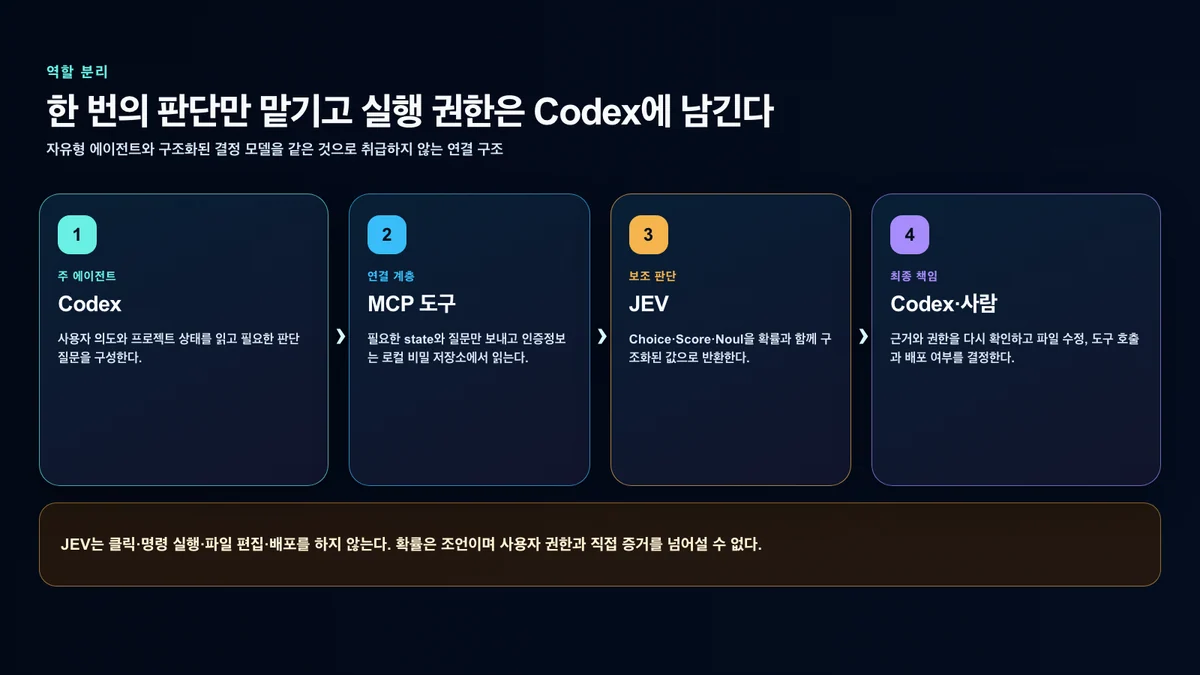
JEV를 연결해도 Codex의 모델은 바뀌지 않는다
전체 흐름은 다음과 같다.
- 사용자가 Codex에 작업을 요청한다.
- Codex가 저장소, 테스트와 운영 조건을 읽는다.
- 선택이 필요한 좁은 지점에서 필요한 정보만 MCP 도구에 넘긴다.
- MCP 서버가 JEV API를 호출하고 구조화된 결과를 받는다.
- Codex가 결과를 직접 증거와 비교한다.
- 파일 편집, 명령 실행, 배포 여부는 Codex와 사용자가 결정한다.
JEV는 클릭하지 않고, 터미널 명령을 실행하지 않으며, 파일을 수정하거나 배포하지도 않는다. 이런 역할 분리는 기능 부족이 아니라 안전장치다. 판단을 잘하는 모델에 실행 권한까지 자동으로 넘기지 않기 때문에, 오판 하나가 곧바로 외부 변경으로 이어지는 경로를 줄일 수 있다.
연결 방법은 두 가지다
1. TypeSafe 공식 에이전트 스킬로 사용법을 알려주기
TypeSafe는 Codex 같은 코딩 에이전트가 올바른 API 패턴을 알 수 있도록 공식 에이전트 스킬을 제공한다. 일반 설치 명령은 다음과 같다.
npx skills add typesafe-ai/skills --skill typesafe-ai이 방법은 질문 구조, 응답 처리, 임계값과 평가 패턴을 에이전트에 알려준다. 그러나 스킬만 설치했다고 Codex 안에 JEV 호출 버튼이나 MCP 도구가 생기는 것은 아니다. 스킬은 지식과 작업 지침이고, 실제 네트워크 요청은 애플리케이션 코드 또는 별도의 도구 연결이 해야 한다.
JEV를 사용하는 기능을 코드로 개발하려는 팀에는 이 경로가 적합하다. Codex가 API 클라이언트, 평가 코드와 테스트를 작성할 때 공식 패턴을 참고하게 할 수 있기 때문이다.
2. 커스텀 MCP 플러그인으로 Codex가 직접 호출하게 하기
대화 중 Codex가 JEV를 실제로 호출하게 하려면 MCP 서버가 필요하다. 이번 검증 환경에서는 개인용 JEV Decision Helper 플러그인이 stdio 방식 MCP 서버를 띄우고, 다음 두 도구만 노출하도록 구성했다.
status: API 키가 구성돼 있는지만 확인한다. 키 값을 보여 주지 않고 과금 요청도 만들지 않는다.decide:state와 Choice·Score·Noul 질문을 검증한 뒤 JEV에 전달한다.
이 플러그인은 TypeSafe가 배포한 공식 Codex MCP 플러그인이 아니다. TypeSafe의 공개 API와 문서를 사용하는 별도의 로컬 연결 계층이다. 따라서 같은 구조를 도입하려면 조직이 MCP 래퍼 코드를 직접 검토하고 유지하거나, 신뢰할 수 있는 구현을 선택해야 한다.
OpenAI의 플러그인 문서에 따르면 Codex 플러그인은 스킬과 MCP 설정을 함께 묶을 수 있다. MCP 서버는 필요한 입력 스키마를 명확히 제한하고, 비밀 값을 플러그인 파일이나 배포 압축 파일에 넣지 않아야 한다. stdio 프로세스에는 꼭 필요한 환경 변수만 전달하는 편이 안전하다.
실제로 어떤 요청이 오가는가
JEV API 문서는 POST https://api.typesafe.ai/v1/systemone 엔드포인트에 Bearer 인증과 JSON 본문을 사용한다. 핵심 입력은 세 부분이다.
model: 새 안정 버전을 따라가려면jev-latest, 고정된 운영 동작이 필요하면 버전 IDstate: 판단에 필요한 사실만 담은 문자열, 객체 또는 배열questions: 이름이 붙은 독립 질문 모음
예를 들어 배포 후보의 상태는 다음 정도로 좁힐 수 있다.
{
  "model": "jev-latest",
  "state": {
    "change": "로그인 미들웨어와 데이터베이스 마이그레이션 변경",
    "automated_tests_passed": 42,
    "security_integration_tests_failed": 1,
    "rollback_plan": true,
    "deployment_started": false
  },
  "questions": {
    "allow_deploy_now": {
      "type": "noul",
      "instructions": "주어진 상태만 보고 지금 배포를 시작해도 되는 명제의 확률을 평가한다."
    }
  }
}
실제 MCP 도구에서는 Choice의 허용 선택지, Score의 단계와 각 판단 기준도 함께 검증해야 한다. 자연어 지시만 믿고 허용하지 않은 문자열을 후속 코드가 실행하게 만들면 구조화된 출력의 장점이 사라진다.
Choice·Score·Noul을 구분해서 써야 한다
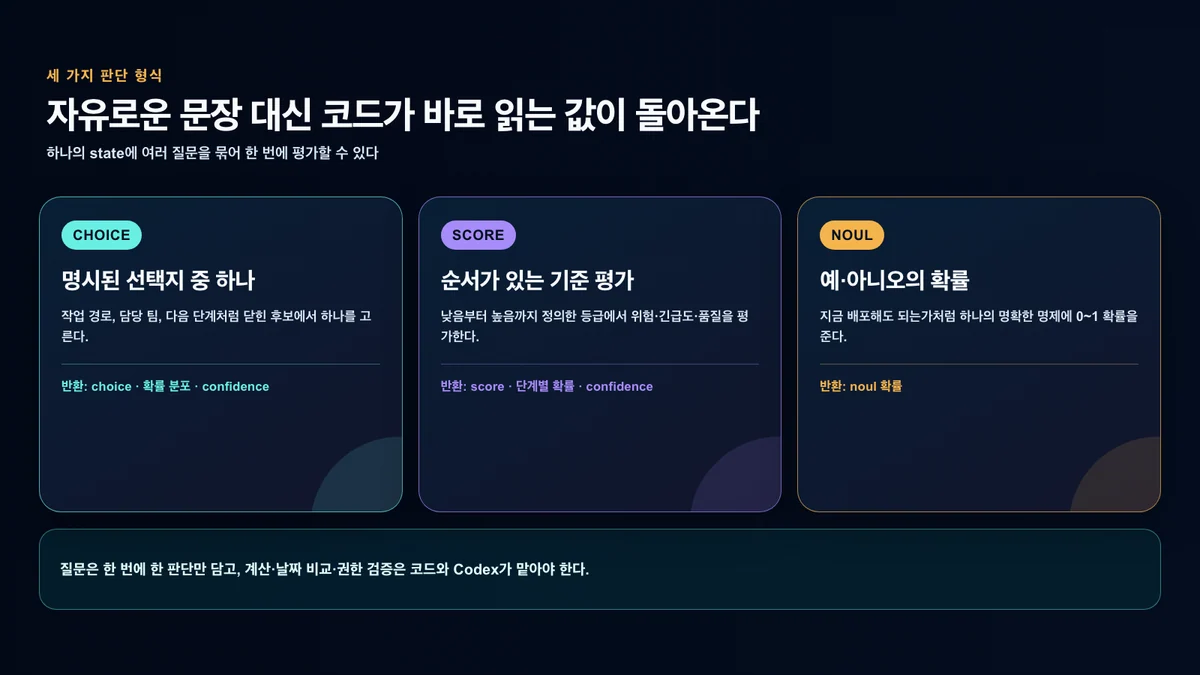
Choice: 정해진 후보 중 다음 경로를 고를 때
fix_and_retest, request_human_review, deploy_with_monitoring처럼 애플리케이션이 미리 정의한 선택지 중 하나를 고르게 한다. 결과에는 선택된 값, 각 선택지의 확률 분포와 confidence가 포함된다.
사용하기 좋은 예시는 다음과 같다.
- 버그를 프런트엔드·백엔드·인프라 팀 중 어디로 라우팅할지
- 코드 변경을 바로 수정할지, 사람에게 보낼지, 추가 증거를 모을지
- 고객 문의를 어느 지원 큐로 보낼지
Score: 순서가 있는 기준을 평가할 때
0=낮음, 1=보통, 2=높음, 3=매우 높음처럼 순서가 있는 단계를 사용한다. 결과에는 선택된 점수, 단계별 확률과 confidence가 들어간다. 숫자는 계산 결과가 아니라 미리 정의한 서열의 라벨이라는 점이 중요하다.
위험도, 긴급도와 검토 우선순위에 적합하지만, 결제 금액 합산이나 날짜 차이 계산에 쓰면 안 된다. 정확한 산술과 시간 비교는 코드가 해야 한다.
Noul: 하나의 명제가 참일 확률이 필요할 때
이 변경은 지금 배포해도 안전하다처럼 예·아니오로 답할 수 있는 한 문장을 평가한다. 반환되는 noul은 0부터 1 사이의 예 확률이다. Noul에는 Choice와 Score처럼 별도의 confidence 필드가 없다.
Choice 안의 특정 선택지 확률과 Noul 값을 산술적으로 같은 종류의 점수처럼 합치면 안 된다. 질문 구조와 보정 방식이 다르므로 각 형식은 독립적으로 검증해야 한다.
실제 Codex 연결 시험
이번 연결 시험에서는 실제 비밀번호, API 키나 고객 데이터를 보내지 않았다. JEV에는 다음과 같은 비식별 상태만 전달했다.
- 로그인 세션 미들웨어와 데이터베이스 마이그레이션이 바뀜
- 자동 테스트 42개 통과
- 보안 통합 테스트 1개 실패
- 롤백 계획 존재
- 배포는 아직 시작하지 않음
한 요청에 세 개의 독립 질문을 넣었고 jev-latest가 가리키는 JEV 1.13.0이 다음처럼 응답했다.
- 다음 단계 Choice:
수정 후 재시험, 선택 확률 98%, confidence 0.97 - 위험 수준 Score: 4단계 중
2=높음, 해당 단계 확률 100%, confidence 1.0 - 지금 즉시 배포 가능 Noul:
0.03
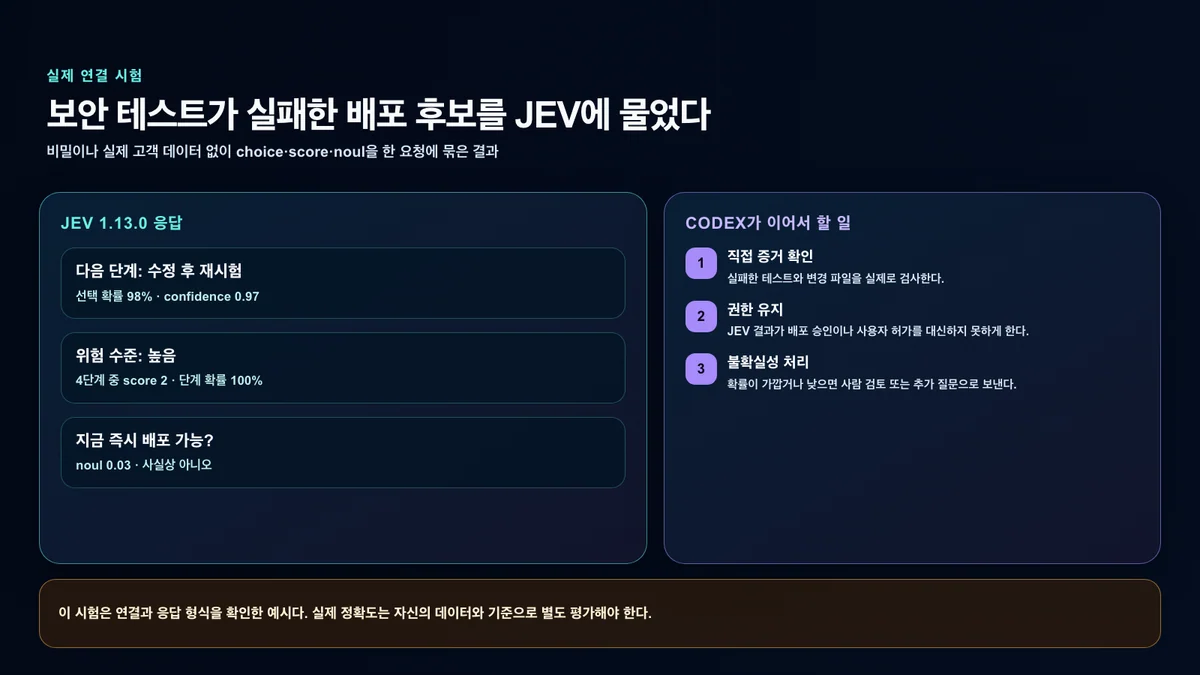
이 결과는 상식적인 방향과 일치하지만 정확도 벤치마크는 아니다. 한 사례는 연결, 스키마와 응답 형식이 정상이라는 것만 보여 준다. 실제 자동화에 쓰려면 자체 데이터에서 오탐·미탐, 클래스별 편향과 임계값을 따로 측정해야 한다.
Codex가 이어서 해야 할 일도 남아 있다. 실패한 테스트 로그를 직접 읽고, 변경 파일을 검사하며, 필요하면 수정 후 테스트를 다시 돌려야 한다. JEV의 0.03이 기술적 배포 차단이나 사용자의 승인 절차를 대체하지 않는다.
confidence와 확률을 운영 규칙으로 바꾸는 법
TypeSafe의 confidence 문서는 높은 confidence면 자동 처리, 중간이면 추가 정보나 확인, 낮으면 사람 검토로 보내는 구조를 제안한다. 그러나 모든 업무에 통하는 임계값은 없다.
안전한 설계 순서는 다음과 같다.
- 과거 사례를 정답이 포함된 평가셋으로 만든다.
- 업무별로 오탐과 미탐의 비용을 정한다.
- 낮은 위험 작업과 배포·권한·개인정보 같은 높은 위험 작업의 임계값을 다르게 둔다.
- 임계값 근처 결과는 자동 실행하지 않고 사람 검토로 보낸다.
- 질문 문구, 모델 버전, 입력 요약, 결과와 최종 사람 판단을 감사 로그로 남긴다.
- 모델이나 질문을 바꾸면 임계값을 다시 검증한다.
예를 들어 문서 태그 분류는 confidence 0.80 이상에서 자동 처리할 수 있지만, 운영 배포는 0.99여도 자동 승인하지 않는 정책이 합리적일 수 있다. 확신이 높다와 실행 권한이 있다는 완전히 다른 조건이다.
한국 사용자가 특히 확인할 점
JEV 1.13 모델 문서에 따르면 영어가 주 학습 언어이며 정확도가 가장 좋다. 한국어를 포함한 CJK 언어도 처리할 수 있지만, 국내 행정 용어, 존댓말, 학교·공공기관 문서와 고유명사에서는 자체 평가가 필요하다.
실무에서는 다음 세 방법이 현실적이다.
- 한국어 원문을 그대로 쓰는 평가와, 핵심 사실을 구조화한 영어 질문 평가를 나란히 비교한다.
- 한글 자유 서술을 길게 보내기보다 필요한 사실을 짧은 필드로 정리한다.
- 영어 성능이 더 좋다는 이유만으로 개인정보가 포함된 원문 전체를 외부 번역·판단 서비스에 보내지 않는다.
개인정보보호법 적용 대상 데이터나 미공개 소스코드를 보낼 때는 TypeSafe의 최신 약관, 저장·학습 사용, 처리 위치, 삭제와 기업 계약 조건을 별도로 확인해야 한다. 기사 작성 시점의 모델 문서와 가격표만으로 조직의 법적 요구사항이 자동 충족되지는 않는다.
API 키와 플러그인 보안
API 키는 소스코드, .mcp.json, 기사, 로그와 Git 저장소에 넣으면 안 된다. 이번 검증 환경은 키를 Codex의 별도 비밀 파일에 보관하고, 소유자만 읽을 수 있는 파일 권한이 아니면 MCP 서버가 요청을 거부하도록 구성했다. 상태 확인 도구는 키의 존재 여부만 반환하며 값은 읽어 주지 않는다.
추가로 지킬 원칙은 다음과 같다.
- MCP 프로세스에 전체 셸 환경을 넘기지 않고 필요한 변수만 전달한다.
state에 관련 없는 대화 기록, 비밀번호, 토큰과 고객 원문을 넣지 않는다.- 응답 로그에서는 인증 헤더와 요청 식별자를 마스킹한다.
- JEV 도구가 반환한 문자열을 셸 명령이나 파일 경로로 직접 실행하지 않는다.
- 플러그인 변경 뒤에는 Codex를 새로 시작하거나 새 대화에서 도구 스키마가 다시 로드됐는지 확인한다.
- 먼저 과금이 없는 상태 확인을 하고, 비식별 합성 데이터로 최소 호출을 시험한다.
잘 맞는 작업과 피해야 할 작업
JEV가 잘 맞는 곳은 출력 형식과 판단 기준을 사전에 정의할 수 있는 영역이다.
- 이슈 라우팅과 담당자 분류
- 보안·품질·긴급도 점수화
- 리뷰 필요 여부 판단
- 여러 복구 경로 중 다음 단계 선택
- 자동화 가드레일의 보조 신호
- 대량 사례의 우선순위 정렬 전 단계
반대로 다음 작업은 Codex, 결정적 코드나 전문 검토자가 맡아야 한다.
- 코드 작성과 자유형 설명 생성
- 정확한 계산, 문자열 카운팅과 날짜 비교
- 여러 단계를 건너뛰는 복잡한 간접 추론
- 이미지·음성·영상 자체의 판독
- 권한 부여와 법적·의료적 최종 판단
- 배포, 삭제, 결제와 외부 메시지 전송
JEV 1.13 한계 문서는 문자 그대로 읽는 경향, 관련 없는 큰 state에서의 성능 저하, 상충하는 instructions와 criteria, 적대적 콘텐츠와 프롬프트 인젝션의 영향을 명시한다. 이미지나 음성을 다뤄야 한다면 다른 도구가 먼저 텍스트나 구조화 필드로 변환하고, 그 변환도 검증해야 한다.
컨텍스트, 모델 버전과 가격
TypeSafe 모델 문서에 따르면 2026년 9월 27일 기준 안정 모델은 jev-1.13.0이며 jev-latest가 이 버전을 가리킨다. 전체 요청의 컨텍스트 상한은 64K이고, state와 가장 긴 단일 질문의 합은 32K다. 텍스트 입력만 지원한다.
입력 가격은 10억 토큰당 42달러, 즉 100만 토큰당 0.042달러이며 출력 토큰은 무료다. 이 가격은 매우 낮지만 불필요한 데이터를 보내도 된다는 뜻은 아니다. 입력이 길수록 정확도, 개인정보와 디버깅 위험이 커질 수 있다. 호출 한도는 변할 수 있으므로 운영 전 현재 제한을 확인하고, 직접 HTTP 호출한다면 429와 529 오류에 지수 백오프를 구현해야 한다.
개발 중에는 jev-latest가 편하지만, 검증된 임계값으로 자동화하는 운영 환경은 jev-1.13.0처럼 버전을 고정하는 편이 안전하다. alias가 새 버전으로 이동하면 같은 질문의 분포와 confidence가 달라질 수 있기 때문이다.
설치 후 검증 체크리스트
- TypeSafe API 키를 발급받고 운영체제의 비밀 저장소 또는 권한이 제한된 파일에 넣는다.
- 공식 에이전트 스킬과 실제 MCP 호출 계층이 서로 다른 역할임을 확인한다.
- MCP에는
status와decide처럼 목적이 좁고 입력 스키마가 명확한 도구만 노출한다. - 새 Codex 세션에서 도구가 표시되는지 확인한다.
status로 키의 구성 여부만 확인하고 값은 출력하지 않는다.- 비식별 합성 데이터로 Choice·Score·Noul 응답 스키마를 시험한다.
- 오류·시간 초과·429·529에서 자동 실행이 안전한 쪽으로 중단되는지 확인한다.
- 질문과 임계값을 한 파일에 모아 코드 리뷰 대상으로 만든다.
- 자체 평가셋으로 언어·업무별 오탐과 미탐을 측정한다.
- 배포·삭제·권한 변경은 JEV 결과와 별개로 사용자 승인과 직접 검증을 요구한다.
결론
JEV와 Codex의 조합은 두 모델을 경쟁시키는 구성이 아니다. Codex는 사용자 의도를 이해하고, 코드를 다루고, 도구를 실행하며 결과에 책임지는 주 에이전트로 남는다. JEV는 그 흐름 안에서 후보 선택, 등급 평가와 예·아니오 확률이라는 세 가지 좁은 판단을 빠르게 돌려준다.
가장 좋은 시작은 자동 배포가 아니라 사람에게 보낼지, 어떤 팀으로 라우팅할지, 추가 검증이 필요한지 같은 되돌릴 수 있는 작업이다. 질문을 원자적으로 만들고, state를 최소화하며, confidence와 확률을 자체 데이터로 보정하고, 실행 권한을 분리하면 JEV는 Codex 자동화의 판단 경계를 더 명확하게 만들 수 있다.
상표와 독립 편집 고지
JEV와 TypeSafe 관련 명칭은 TypeSafe AI, Codex와 GPT 관련 명칭은 OpenAI 및 각 권리자에게 속한다. 이 글은 각 회사의 후원·승인·제휴를 받은 공식 문서가 아니다. 기사 이미지는 실제 제품 화면, 회사 로고, 제3자 사진이나 공식 도표를 복제하지 않았다.
공식 출처
- TypeSafe AI: JEV 소개와 Choice·Score·Noul
- TypeSafe AI: Coding agents에서 JEV의 역할
- TypeSafe AI: API 엔드포인트와 응답 형식
- TypeSafe AI: 모델·컨텍스트·가격
- TypeSafe AI: Confidence 활용
- TypeSafe AI: JEV 1.13의 알려진 한계
- TypeSafe AI: 공식 에이전트 스킬
- OpenAI Developers: Codex 플러그인 구조
- OpenAI Developers: Docs MCP