OpenAI ‘Bel’ 10조 파라미터설—GPT-7·AGI 루머, 확인된 것과 아닌 것
Bel이라는 이름이 OpenAI의 다음 초대형 모델을 가리킨다는 주장이 X와 AI 커뮤니티에서 퍼지고 있다. 가장 눈에 띄는 표현은 10조 개가 넘는 총 파라미터, Doug의 후속 사전학습, GPT-7의 기반, AGI 문턱이다. 숫자와 이름만 보면 이미 완성된 차세대 모델처럼 들린다.
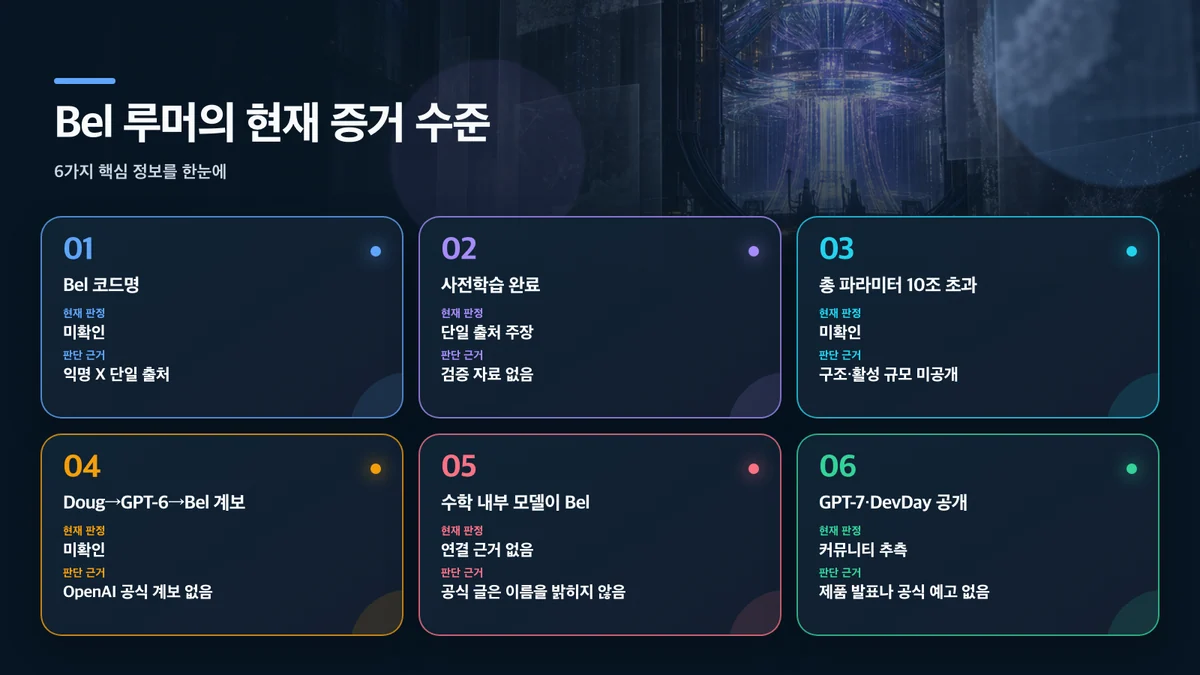
하지만 2026년 9월 25일 현재 OpenAI는 Bel이라는 모델을 발표하지 않았다. OpenAI 공식 모델 카탈로그, 제품 발표, 연구 자료 어디에도 Bel 또는 이를 GPT-7로 규정하는 설명이 없다. 추적 가능한 핵심 증거는 익명 X 계정의 게시물 한 건이고, 뒤따른 게시물 상당수는 그 내용을 다시 전달하거나 확대 해석한 것이다.
이 글은 루머를 사실처럼 확정하지 않는다. 최초 X 원문, 재확산 경로, OpenAI의 공식 Astra·수학 연구 자료와 DevDay 안내를 나눠 확인한다. 모델의 존재부터 크기와 출시 시점까지 모두 증거 수준에 맞춰 읽어야 한다.
세 줄 요약
- Bel의 존재, 사전학습 완료와 10조 총 파라미터 주장은 현재 익명 X 계정 하나로 거슬러 올라가며 OpenAI가 확인하지 않았다.
- OpenAI가 Astra보다 강력한 내부 모델을 수학 연구에 사용한 것은 사실이지만, 공식 자료는 그 모델을 Bel이라고 부르지 않는다.
- 최초 게시물에는 GPT-7이나 DevDay 출시가 없으며, 두 표현은 커뮤니티 확산 과정에서 붙은 추측이다.
Bel 루머의 현재 증거 수준
최초 추적 가능한 X 게시물은 무엇을 주장했나
X 계정 @synthwavedd는 8월 25일 OpenAI가 Bel이라는 코드명의 다음 사전학습을 끝냈다고 주장했다. 게시물은 Bel을 Doug의 후속으로 묘사하고, Doug가 추가 강화학습을 거쳐 Astra와 GPT-6의 기반이 될 것이라고 설명했다. 이어 Bel은 10조 개가 넘는 총 파라미터를 가졌고 GPT-4.5와 비슷한 크기이며, GPT-6 이후 세대 또는 AGI 문턱에 해당하는 모델의 기반이 될 수 있다고 주장했다.
구체적인 고유명사와 큰 숫자가 들어 있지만 검증 가능한 근거는 붙어 있지 않다. 문서, 모델 카드, 학습 로그, 코드, 데이터센터 기록, 익명 내부자의 소속과 접근 범위, 독립 취재 확인이 없다. 계정의 과거 적중률만으로 이번 주장을 사실로 바꿀 수도 없다.
따라서 이 게시물로 확인되는 사실은 누군가 Bel이라는 이름과 10조 총 파라미터 주장을 공개했다는 것뿐이다. OpenAI가 실제로 Bel을 학습했고 학습이 끝났다는 사실은 확인되지 않았다.
게시물이 여러 개여도 출처는 하나일 수 있다
@Adidotdev는 다음 날 OpenAI가 Astra 다음 모델을 이미 완성했다는 취지로 주장을 다시 소개했다. 그러나 별도의 출처 표시 게시물은 정보의 출발점이 @synthwavedd임을 밝힌다. 같은 내용을 더 단정적인 문장으로 전달했을 뿐, 독립적으로 입수한 두 번째 자료는 아니다.
@kimmonismus의 게시물도 본문에서 최초 계정을 출처로 적고 Bel·10조 파라미터·경쟁사의 계산 자원에 관한 주장을 재전달한다. 이 역시 별개의 유출이 아니다. yumeacademy의 게시물은 Bel을 더욱 극적인 표현과 추가 수치로 설명하지만, 그 수치를 입증하는 OpenAI 문서는 제시하지 않는다.
검색 결과가 많아지면 서로 다른 사람들이 같은 정보를 확인한 것처럼 보일 수 있다. 그러나 인용 관계를 역추적하면 기사, Reddit 글과 X 게시물이 한 계정으로 모이는 경우가 많다. 반복 횟수는 독립적인 증거의 수가 아니다.
원래 게시물은 Bel을 GPT-7이라고 하지 않았다
Bel과 GPT-7을 같은 모델로 취급하는 제목이 확산됐지만 최초 게시물의 표현은 다르다. 게시자는 Bel을 GPT-6 이후의 기반이 될 가능성이 있는 사전학습 모델로 추정했을 뿐 GPT-7이라는 제품명을 쓰지 않았다.
연구 코드명, 사전학습 체크포인트와 출시 제품은 일대일로 대응하지 않을 수 있다. 하나의 기반 모델이 여러 제품으로 나뉠 수도 있고, 강화학습·안전 조정 과정에서 이름과 용도가 바뀌거나 공개되지 않을 수도 있다. Bel이 존재한다고 가정해도 그것이 곧 GPT-7이며 가까운 시일에 ChatGPT에서 출시된다는 결론은 나오지 않는다.
10조 총 파라미터는 무엇을 의미하나
최초 게시물은 10T+ total parameters라고 표현했다. 여기서 10T는 학습에 사용한 토큰 수가 아니라 모델이 가진 전체 매개변수 수라는 주장이다. 그러나 총 파라미터만으로 한 번의 추론에 실제로 사용되는 계산량을 알 수 없다.
혼합 전문가 모델이라면 전체 파라미터 중 일부만 토큰마다 활성화될 수 있다. 반대로 조밀 모델이라면 훨씬 많은 가중치를 매번 계산해야 한다. 활성 파라미터, 전문가 수와 라우팅 방식, 정밀도, 학습 데이터, 학습 계산량, 컨텍스트 길이, 추론 인프라가 공개되지 않은 상태에서 10조라는 숫자를 속도·비용·성능으로 환산할 수 없다.
OpenAI는 GPT-4.5의 정확한 파라미터 수를 공식적으로 공개하지 않았다. 따라서 GPT-4.5와 비슷한 크기라는 비교도 외부에서 검증할 기준값이 없다. 더 큰 모델이 더 많은 지식을 담을 가능성은 있지만, 데이터 품질·사후학습·추론 방식·도구 사용과 평가 설계가 최종 능력을 함께 결정한다.
파라미터 수만으로 AGI를 선언할 수 없는 이유
AGI 문턱은 측정 가능한 단일 규격이 아니다. 모델이 벤치마크 몇 개에서 높은 점수를 받더라도 장기 계획, 새로운 환경에서의 일반화, 사실성, 자율적 오류 복구, 안전성과 실제 업무 비용은 별도로 측정해야 한다.
특히 파라미터 수는 다음을 알려 주지 않는다.
- 한 요청에서 활성화되는 계산량과 응답 지연
- 학습 데이터의 범위·품질·중복과 오염 여부
- 강화학습과 안전 조정 뒤 능력이 얼마나 유지되는지
- 도구·브라우저·코드 실행·다중 에이전트를 포함한 실제 성공률
- 환각, 보류, 재시도와 사람 검토를 포함한 작업당 비용
따라서 10조라는 주장이 사실이어도 AGI 도달, GPT-7 명칭, 즉시 출시 또는 모든 평가에서의 우위를 자동으로 뜻하지 않는다.
OpenAI 공식 자료가 보여 주는 현재 기준선
OpenAI 공식 모델 카탈로그에는 현재 GPT-6 Astra, GPT-6 Sol, GPT-6 Luna 등 공개 모델이 안내돼 있지만 Bel은 없다. 검색되지 않는다고 내부 연구 모델이 절대 존재하지 않는다고 단정할 수는 없다. 다만 일반 이용자가 구매하거나 API에서 호출할 수 있는 공식 제품은 아니라는 점은 분명하다.
GPT-6 Astra 공식 발표는 Astra를 사전학습·강화학습·정렬 연구의 결과로 설명한다. 그러나 Doug나 Bel이라는 내부 계보를 공개하지 않는다. 익명 게시물의 서사와 공식 설명 사이에 직접 연결되는 문서가 없는 상태다.
이 구분은 중요하다. 공식 자료에 없는 이름을 유출로 확인된 모델이라고 부르는 것과 확인되지 않은 코드명 주장이라고 부르는 것은 전혀 다른 보도다.
Astra보다 강한 내부 수학 모델이 Bel일까
OpenAI는 9월 8일 Navier–Stokes 해법 연구에서 GPT-6 Astra보다 상당히 강력한 내부 모델을 사용했다고 밝혔다. 공개 내용에 따르면 연구팀은 8월 28일부터 이전에 사전학습된 모델에 대규모 강화학습을 적용했고, 약 10,000개의 동시 에이전트를 운영했다. 문제 해결에는 88시간과 약 270만 개 메시지, 약 1,300억 개 출력 토큰이 사용됐으며, Astra를 이용한 Lean 검증에 17시간이 더 들었다.
이것은 OpenAI가 공개 제품보다 강한 내부 시스템을 실제로 운용한다는 공식 증거다. 최초 Bel 게시물이 나온 8월 25일과 내부 모델 강화학습 시작일인 8월 28일이 가깝다는 점도 커뮤니티의 관심을 끈다.
그러나 일정의 근접성은 모델 식별자가 아니다. 공식 글은 이전에 사전학습된 모델이라고만 표현하고 Bel, Doug, 10조 파라미터나 GPT-7을 언급하지 않는다. 여러 내부 체크포인트가 동시에 존재할 수도 있다. 따라서 Bel이 Navier–Stokes 문제를 풀었다고 쓰는 것은 공개 증거를 넘어선 결론이다.
OpenAI가 8월 1일 공개한 수학·이론 컴퓨터과학의 10가지 진전은 당시 시스템을 Astra의 내부 버전이라고 명확히 불렀다. OpenAI가 공개할 수 있는 경우에는 모델 계열을 구분해 적었다는 점도 Bel 연결을 신중하게 봐야 하는 이유다.
roon의 발언에는 Bel이 없다
OpenAI 연구자로 알려진 roon은 중요한 문제의 해결책을 연구소가 오래 숨겨서는 안 되며, 한두 달이면 여러 주체가 비슷한 능력을 갖게 될 수 있다는 취지의 글을 올렸다. 이후 일부 Reddit 제목과 댓글이 이를 Bel급 능력 또는 차세대 모델 공개 신호와 연결했다.
원문에는 Bel, GPT-7, 10조 파라미터, 출시일이 없다. 모델에 관한 암시로 읽는 것은 가능하지만 특정 모델을 확인한 증거로 인용할 수는 없다. OpenAI 직원이 Bel 출시를 예고했다는 문장은 원문이 말한 범위를 벗어난다.
DevDay에서 공개될까
OpenAI DevDay 2026 공식 안내에 따르면 행사는 9월 29일 열린다. 대형 개발자 행사를 앞둔 시점이라 Bel, GPT-7과 새로운 API 발표를 연결하는 예상이 나오는 것은 자연스럽다.
그러나 공식 일정에는 Bel이 없다. DevDay 개최가 확정됐다는 사실과 Bel이 그 자리에서 공개된다는 주장은 별개다. 내부 사전학습이 끝났다는 루머가 사실이더라도, 강화학습·안전 평가·서빙 최적화·제품 정책과 가격 책정에는 추가 시간이 필요할 수 있다.
무엇이 나오면 Bel을 사실로 볼 수 있나
신뢰도를 크게 높일 수 있는 자료는 다음과 같다.
- OpenAI 발표문, 모델 카탈로그, 시스템 카드 또는 공식 연구 논문의 Bel 명시
- 모델 식별자, 제공 지역, 가격과 접근 방법이 포함된 API 문서
- 총 파라미터와 활성 파라미터, 구조를 구분한 기술 설명
- 서로 연결되지 않은 복수의 신뢰할 만한 취재원이 확인한 내부 자료
- 사전 등록된 평가 또는 재현 가능한 독립 벤치마크
- 출시 제품과 연구 체크포인트의 관계에 대한 OpenAI의 설명
코드 문자열이나 클라우드 설정에 Bel이 등장하더라도 그것만으로 최종 제품명과 출시를 확정할 수는 없다. 반대로 공식 문서가 나오면 지금의 증거 판단은 즉시 갱신해야 한다.
한국 이용자가 주의해서 볼 부분
Bel이 실제 제품으로 발표될 경우 국내 이용자는 파라미터 숫자보다 접근 조건을 먼저 확인해야 한다. ChatGPT 구독에 포함되는지, Codex와 API에서 쓸 수 있는지, 한국 계정에 언제 배포되는지, 데이터 처리 지역과 보존 정책이 무엇인지가 실제 사용성을 결정한다.
초대형 모델이라면 장문 컨텍스트의 가중 사용량, 속도 모드, 주간 한도, 요청당 가격도 중요하다. 미국 달러 가격을 단순 환산한 금액과 한국 결제액은 부가세·환율·카드 수수료 때문에 다를 수 있다. 10조 파라미터가 공식 확인돼도 개인 구독에서 그 전체 모델을 동일한 품질과 속도로 제공한다는 의미는 아니다.
한국어 능력도 영어 벤치마크만으로 판단하기 어렵다. 국내 법령·기관명, 한영 혼합 문서, 존댓말, 표와 보고서 형식, 긴 문서의 누락률을 별도로 시험해야 한다.
자주 묻는 질문
Bel은 OpenAI가 발표한 신모델인가
아니다. 9월 25일 현재 공식 모델 카탈로그와 OpenAI 발표에는 Bel이 없다. 익명 X 계정이 주장한 코드명이다.
Bel이 GPT-7인가
확인되지 않았다. 최초 게시물은 GPT-7이라는 표현을 쓰지 않았고, Bel을 GPT-6 이후 기반이 될 가능성이 있는 모델로 추정했다.
10조 파라미터는 학습 토큰 10조 개라는 뜻인가
원문은 total parameters라고 주장했다. 학습 토큰 수와는 다른 개념이다. 다만 이 수치 자체도 공식 확인되지 않았다.
OpenAI의 내부 수학 모델이 Bel인가
알 수 없다. Astra보다 강력한 내부 모델이 사용된 것은 OpenAI 공식 자료로 확인되지만, 해당 자료는 모델 이름을 Bel이라고 밝히지 않았다.
roon이 Bel 출시를 예고했나
아니다. 원문은 연구 능력의 빠른 확산에 관한 의견이며 Bel이나 출시 일정을 언급하지 않는다.
9월 29일 DevDay에서 공개되나
DevDay 개최는 공식이지만 Bel 발표는 예고되지 않았다. 현재로서는 커뮤니티 예상이다.
결론
Bel 루머는 흥미로운 내부 계보, 10조 총 파라미터와 AGI라는 강한 표현을 갖고 있다. OpenAI가 공개 모델보다 강한 내부 시스템을 운용한다는 공식 사실도 루머가 그럴듯하게 들리는 배경이 된다.
하지만 증거 사슬을 따라가면 핵심 주장은 익명 X 게시물 한 건으로 돌아간다. 재확산 게시물은 독립 확인이 아니고, 공식 수학 연구와 roon의 발언은 Bel이라는 이름을 사용하지 않는다. GPT-7과 DevDay 공개설은 원래 주장에 없던 해석이다.
현재 가장 정확한 결론은 OpenAI의 차세대 사전학습 모델을 Bel이라고 부른다는 미확인 주장이 있다이다. 모델의 존재, 10조 파라미터, 제품 계보와 출시 일정은 OpenAI의 기술 문서나 복수의 독립적인 검증이 나오기 전까지 사실로 단정할 수 없다.
출처와 이용 고지
- OpenAI 공식 모델 카탈로그
- OpenAI, GPT-6 Astra 공식 발표
- OpenAI, Navier–Stokes 해법 연구
- OpenAI, 수학·이론 컴퓨터과학의 10가지 진전
- OpenAI DevDay 2026 공식 안내
- @synthwavedd의 Bel 주장 X 게시물
- Adit_Yah의 재전달 X 게시물
- Adit_Yah의 최초 출처 표시
- kimmonismus의 출처 표시가 포함된 X 게시물
- yumeacademy의 확대 해석 사례
- roon의 능력 확산 관련 X 게시물
- Mukhtada의 Bel 증거 사슬 분석
- Traictory의 10조 파라미터설 검토
- Skala Blog의 Bel 루머 검증
OpenAI, ChatGPT, GPT와 관련 상표는 각 권리자에게 속한다. 이 글은 OpenAI의 후원이나 승인을 받은 공식 콘텐츠가 아니다. X 게시물은 원문 임베드 또는 링크로 표시했으며 게시물 화면을 이미지로 복제하지 않았다. 본문 이미지는 로고·제품 화면·실존 인물·제3자 사진을 사용하지 않은 독립 편집 이미지다. 미확인 주장, 2차 확산과 OpenAI 공식 자료를 서로 구분해 자체 문장으로 분석했다.