SynthID Bio AI 단백질 워터마크는 어떻게 작동하나
SynthID Bio는 AI가 만든 단백질 서열과 예측 3차원 구조에 탐지 가능한 출처 신호를 넣는 개념증명이다. 서열 방식은 VEGF-A SARS-CoV-2 spike RBD PD-L1의 3개 표적 단백질에 대한 결합체를 습식 실험했다. 이 글은 확인된 사실, 발표 주체의 주장, 아직 검증되지 않은 부분을 분리해 실제 의사결정에 필요한 기준을 정리한다.
한 줄 결론 기능을 유지한 출처 표시의 가능성을 보인 개념증명이다
SynthID Bio는 AI가 만든 단백질 서열과 예측 3차원 구조에 탐지 가능한 신호를 넣는 두 방법의 묶음이다. 연구진은 물리적으로 합성한 결합 단백질에서도 기능을 유지하면서 서열 워터마크를 찾을 수 있었다고 보고했다.
그러나 모든 단백질과 실험실, 변형 조건에서 통하는 국제 표준은 아니다. 자발적 적용 모델의 결과에 출처 단서를 더하는 초기 기술로 보는 편이 정확하다.
텍스트 워터마크와 달리 생물 기능을 보존해야 한다
문장의 단어 선택을 조금 바꾸는 것과 단백질의 아미노산을 바꾸는 것은 위험이 다르다. 한 치환이 접힘, 안정성, 결합 친화도, 면역 반응과 발현량을 바꿀 수 있다.
따라서 탐지가 잘 되는지만으로는 쓸 수 없다. 같은 기능을 유지하고 다양한 자연스러운 서열을 만들며, 실제 합성과 습식 실험에서도 성능이 떨어지지 않는지 확인해야 한다.
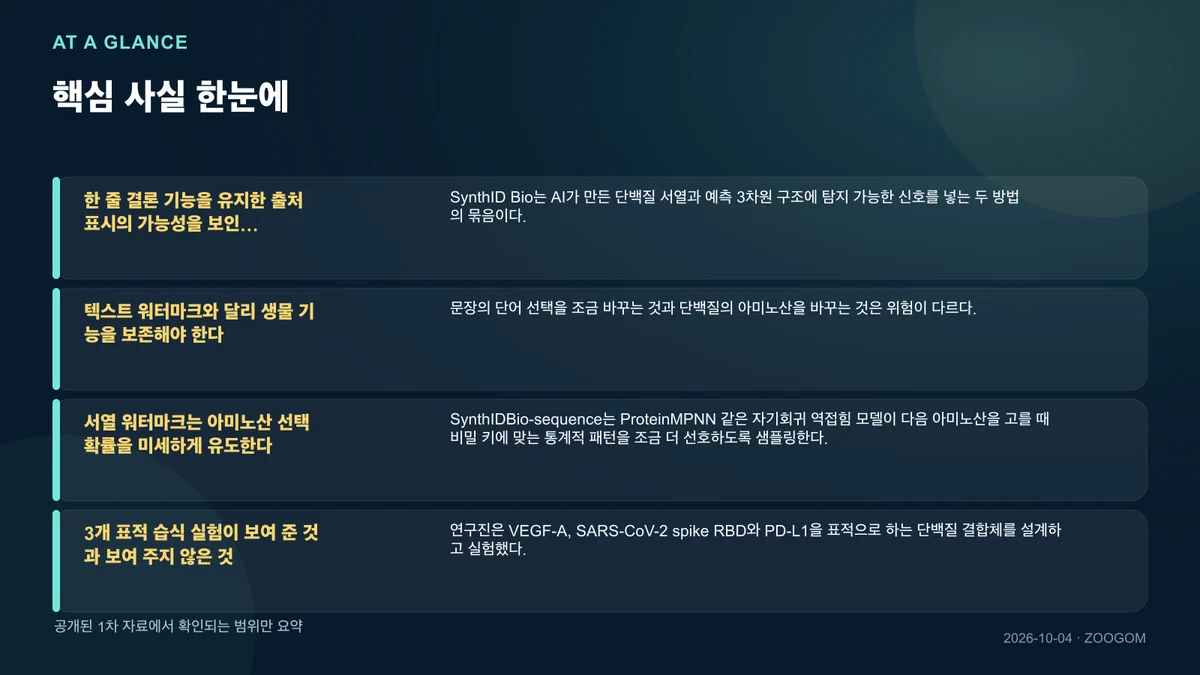
서열 워터마크는 아미노산 선택 확률을 미세하게 유도한다
SynthIDBio-sequence는 ProteinMPNN 같은 자기회귀 역접힘 모델이 다음 아미노산을 고를 때 비밀 키에 맞는 통계적 패턴을 조금 더 선호하도록 샘플링한다. 여러 위치에 분산된 신호를 탐지기가 합쳐 판정한다.
별도의 태그 서열을 끝에 붙이는 방식이 아니다. 그래서 육안으로는 자연 서열과 구별하기 어렵지만, 큰 돌연변이와 재설계가 쌓이면 신호가 약해질 가능성도 평가해야 한다.
3개 표적 습식 실험이 보여 준 것과 보여 주지 않은 것
연구진은 VEGF-A, SARS-CoV-2 spike RBD와 PD-L1을 표적으로 하는 단백질 결합체를 설계하고 실험했다. 워터마크와 비워터마크 설계가 비슷한 적중률, 결합 친화도와 자연 서열 다양성을 보였다고 보고했다.
이는 특정 설계 파이프라인과 3개 표적의 결과다. 효소, 막단백질, 항체 전체, 치료제의 독성·면역원성과 장기 안정성까지 검증했다는 뜻은 아니다.
구조 워터마크는 좌표를 나중에 흔드는 방식이 아니다
SynthIDBio-structure는 AlphaFold 3 호환 모델의 확산 모듈 일부를 미세조정해 예측 과정에서 3차원 좌표에 신호가 자연스럽게 생기도록 한다. 별도 PointNet 계열 탐지기가 구조에서 신호를 판별한다.
공식 설명은 예측 정확도와 주요 구조 분포를 유지하고 디지털 노이즈나 작은 좌표 변경에도 거의 완벽한 탐지 성능을 보였다고 한다. 이 표현은 연구 평가 조건 안의 결과다.
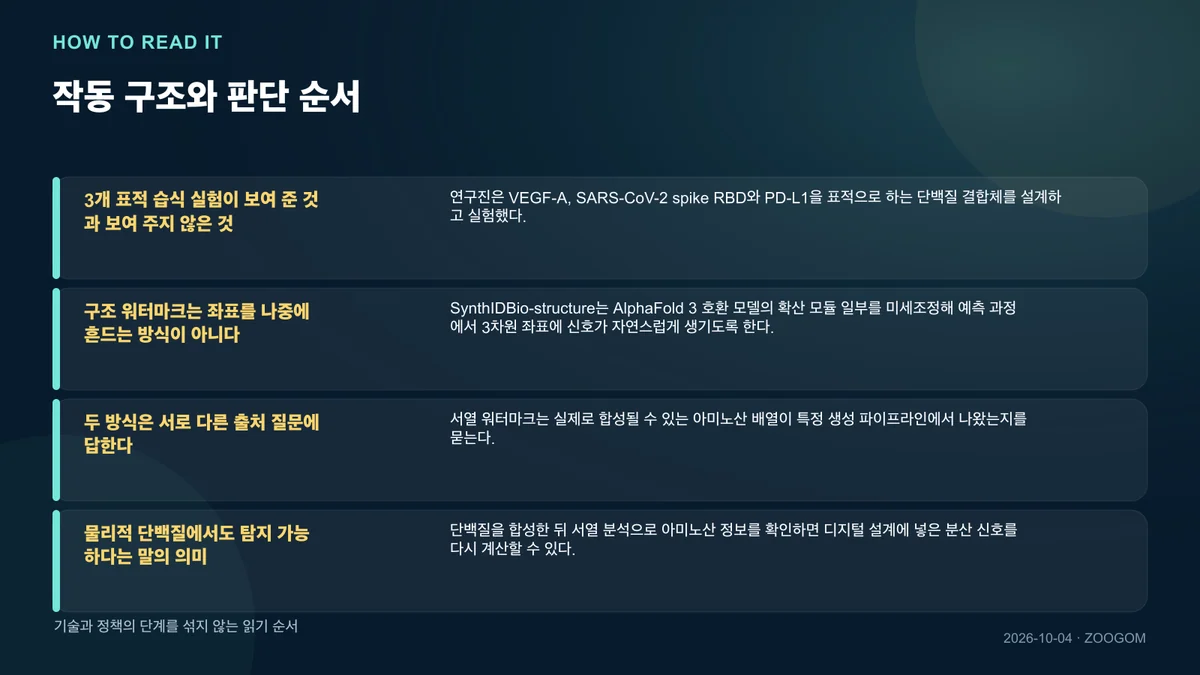
두 방식은 서로 다른 출처 질문에 답한다
서열 워터마크는 실제로 합성될 수 있는 아미노산 배열이 특정 생성 파이프라인에서 나왔는지를 묻는다. 구조 워터마크는 데이터베이스에 올라간 예측 좌표가 해당 모델에서 생성됐는지를 묻는다.
하나가 다른 하나를 자동 인증하지 않는다. 서열만 남고 구조 파일이 바뀌거나, 구조는 유지되지만 서열을 다시 설계하는 흐름이 있기 때문에 데이터 유형별 검증이 필요하다.
물리적 단백질에서도 탐지 가능하다는 말의 의미
단백질을 합성한 뒤 서열 분석으로 아미노산 정보를 확인하면 디지털 설계에 넣은 분산 신호를 다시 계산할 수 있다. 물질 안에 전파 송신기나 눈에 보이는 표식이 들어간다는 뜻은 아니다.
샘플의 이력과 시퀀싱 품질, 변형 여부가 결과에 영향을 준다. 탐지 점수는 출처를 뒷받침하는 신호이지 누가 언제 어떤 목적으로 합성했는지를 독자적으로 증명하는 법적 신원증명서는 아니다.
바이오 보안에는 유용하지만 위험 서열 스크리닝을 대체하지 못한다
워터마크가 있으면 합성 업체나 데이터베이스가 AI 생성 가능성을 추가 신호로 활용할 수 있다. 잘못 표시된 예측 구조가 실험 구조처럼 퍼지는 문제를 줄이는 데도 도움이 될 수 있다.
하지만 악의적 설계자가 워터마크 기능을 끄거나 다른 모델을 쓰면 신호가 없다. 위험성 평가는 서열과 기능, 주문자 확인, 실험실 안전과 접근 통제를 계속 사용해야 한다.
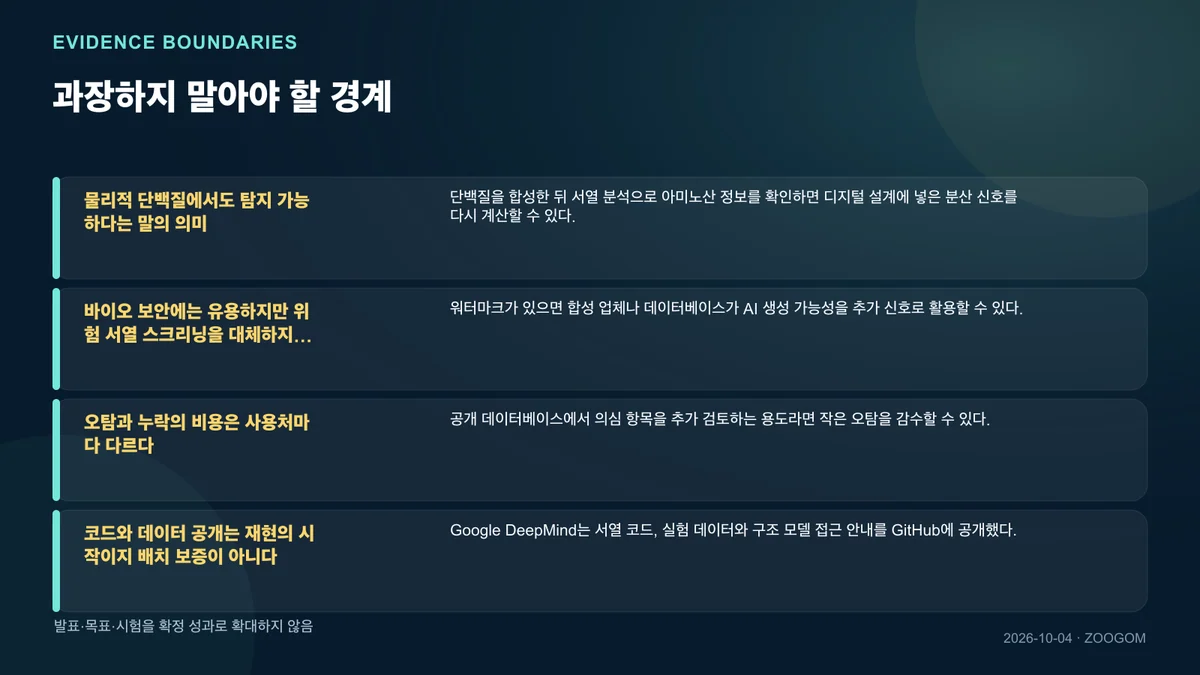
오탐과 누락의 비용은 사용처마다 다르다
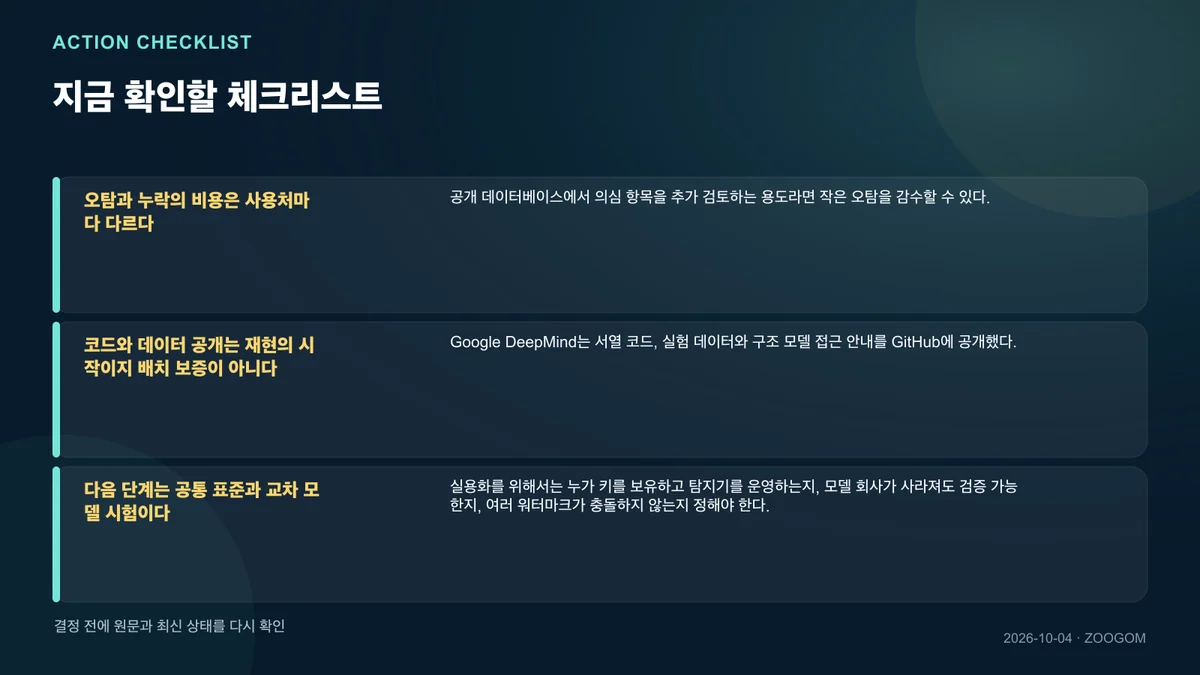
공개 데이터베이스에서 의심 항목을 추가 검토하는 용도라면 작은 오탐을 감수할 수 있다. 반면 주문을 거부하거나 연구자에게 제재를 가하는 자동 결정이라면 독립 확인과 이의제기가 필요하다.
탐지 임계값, 키 관리, 모델 버전과 신뢰구간을 함께 공개해야 한다. “거의 완벽”이라는 평균 성능만으로 개별 샘플의 확정 판정을 내리면 안 된다.
코드와 데이터 공개는 재현의 시작이지 배치 보증이 아니다
Google DeepMind는 서열 코드, 실험 데이터와 구조 모델 접근 안내를 GitHub에 공개했다. Nature 논문에는 데이터·코드 가용성과 Alphabet의 연구비 지원도 적혀 있다.
외부 연구자가 다른 단백질 계열, 공격적 변형, 서열 절단과 재설계에서 탐지를 반복해야 일반화 범위를 알 수 있다. 공개 저장소가 있다는 사실과 독립 재현이 끝났다는 사실은 다르다.
다음 단계는 공통 표준과 교차 모델 시험이다
실용화를 위해서는 누가 키를 보유하고 탐지기를 운영하는지, 모델 회사가 사라져도 검증 가능한지, 여러 워터마크가 충돌하지 않는지 정해야 한다. 생물 데이터베이스와 DNA 합성업체의 기존 절차에 어떻게 연결할지도 필요하다.
현재 성과는 단백질의 기능과 출처 신호가 양립할 수 있다는 강한 초기 증거다. 동시에 워터마크가 없는 결과를 안전하다고 보거나, 워터마크가 있는 결과를 위험하다고 보는 이분법은 피해야 한다.
저작권·상표 및 이미지 고지
회사명과 제품명은 각 권리자의 상표일 수 있다. 별도 표시가 없는 시각 자료는 AI로 생성한 개념 배경 또는 자체 제작한 편집 디자인·정보 그래픽이다. 인용문이나 외부 자산을 사용하는 경우 해당 위치 또는 출처 목록에 저작자·출처·이용 조건을 표시한다.
출처와 앞으로 확인할 사항
아래 링크는 사실 확인에 사용한 1차·공식 자료다. 링크는 출처이며 이미지나 문장을 전재했다는 뜻이 아니다.