Claude Opus 5.5 너프설 10월 업데이트: 데이터는 무엇을 말하나
9월 30일부터 10월 2일 사이 X와 Reddit에는 Claude Opus 5.5가 출시 직후보다 짧게 답하고, 요구사항을 빼먹고, 코딩 작업에서 되돌림이 늘었다는 신고가 빠르게 쌓였다. 매일 같은 저장소에서 Claude Code를 쓰는 사람에게 이런 변화는 통계표가 없어도 현실적인 비용이다. 그러나 품질이 나빠졌다고 느낀 사건과 Anthropic이 Opus 5.5 자체를 전면 하향했다는 설명은 아직 같은 결론이 아니다.
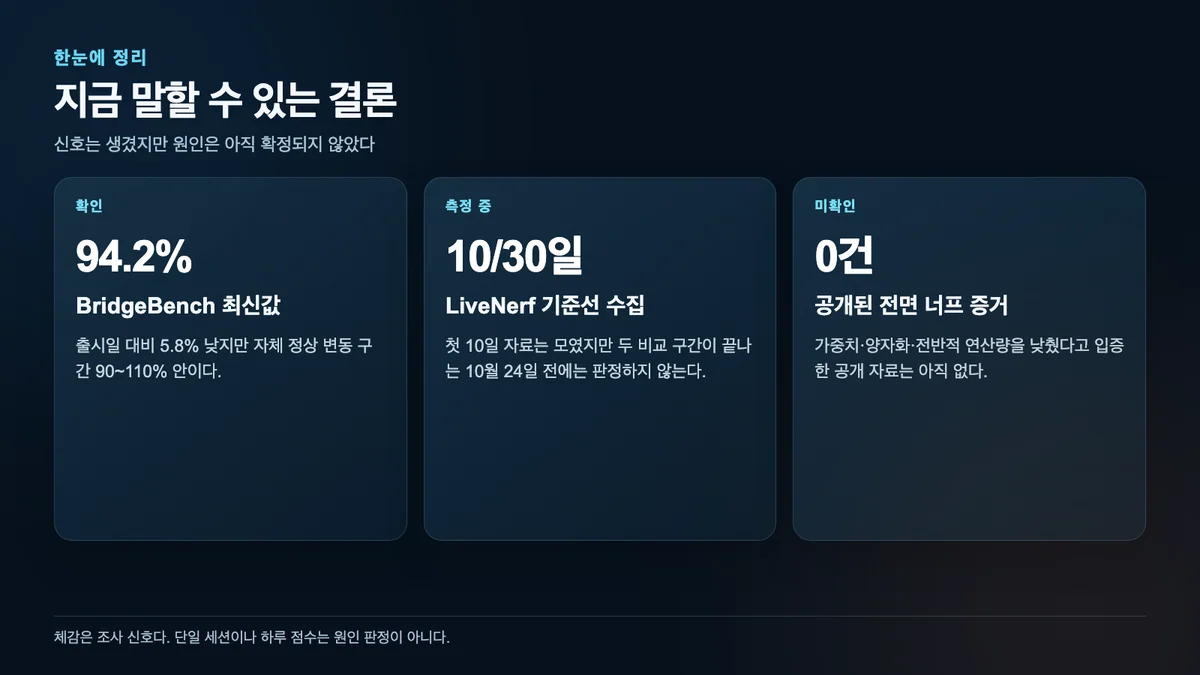
2026년 10월 3일 현재 가장 정확한 판정은 이렇다. 체감 신고는 조사할 만한 신호로 커졌고, 독립 추적기에도 흔들림이 보인다. 하지만 BridgeBench의 최신 94.2%는 그 서비스가 정한 정상 변동 범위 안이며, LiveNerf는 이제 기준선만 완성했다. 가중치·양자화·전반적인 추론 예산이 낮아졌다고 입증한 공개 자료는 없다. 이 글은 9월 27일 팩트체크를 덮어쓰지 않는 별도 업데이트이며, 동일 조건의 자체 벤치마크를 수행했다고 주장하지 않는다.
한눈에 보는 10월 3일 판정
- 확인된 신호: 9월 말부터 품질 저하 체감 신고가 늘었고, BridgeBench의 10월 2일 값은 출시 기준의 94.2%였다.
- 아직 진행 중인 측정: LiveNerf는 10일 기준선을 끝냈다. 사전 등록된 규칙상 다음 두 개의 10일 구간이 모두 끝나기 전에는 하락을 선언하지 않는다.
- 확인되지 않은 주장: Opus 5.5의 모델 가중치, 양자화 수준이나 전체 사용자에게 배정되는 연산량을 출시 뒤 낮췄다는 공개 증거는 없다.
- 가장 중요한 구분: 고정된 모델 ID는 기반 모델 버전에 관한 약속이다. Claude 앱의 라우팅, 안전 fallback, Claude Code 실행 환경과 긴 대화의 요약까지 불변이라는 뜻은 아니다.
한국 이용자에게 실용적인 결론은 “지금 당장 너프로 확정”도 “모든 신고가 착각”도 아니다. 구독형 Claude Code에서 문제가 반복된다면 새 세션·고정 effort·고정 CLI로 재현 자료를 남기고, 10월 하순의 반복 측정 결과를 기다리는 편이 합리적이다.
무엇을 너프라고 부르는지 먼저 나눠야 한다
논쟁에서는 서로 다른 네 현상이 하나의 단어로 묶인다. 첫째는 같은 모델 이름 뒤의 가중치나 양자화를 실제로 바꾸는 모델 교체다. 둘째는 기본 effort나 출력 한도처럼 추론 조건을 바꾸는 설정 변화다. 셋째는 안전 분류기, 용량 관리나 제품 정책에 따른 라우팅 변화다. 넷째는 Claude Code 버전, 도구 권한, 긴 대화 요약과 장애 같은 하네스·서비스 변화다.
사용자는 최종 응답만 보기 때문에 네 원인 모두 “어제보다 멍청하다”로 보일 수 있다. 그렇다고 체감이 틀렸다는 뜻은 아니다. 원인을 특정하려면 모델 ID, 실제 응답 모델, effort, 대화 길이, 도구와 버전, 시간대가 함께 기록돼야 한다. 이 구분을 빼고 점수 하나나 게시물 하나로 전면 너프를 단정하면 원인 진단이 불가능해진다.
11일 동안 논쟁이 커진 순서
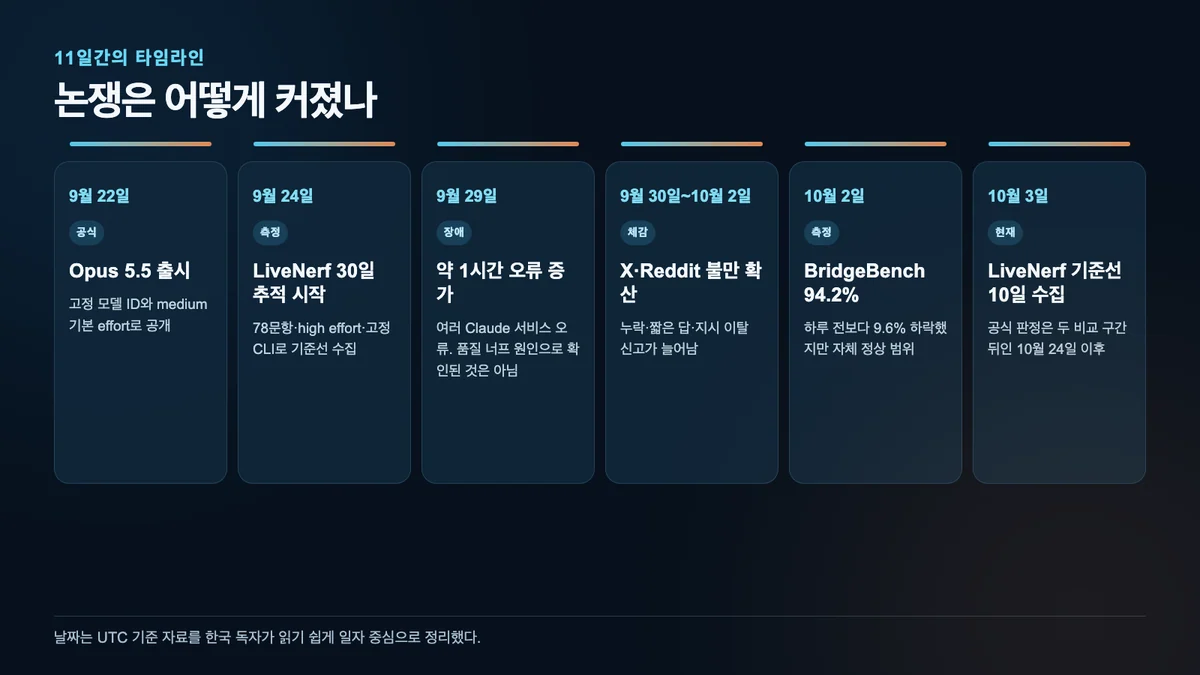
Anthropic의 Opus 5.5 공식 발표는 9월 22일 공개 시점과 제품 포지셔닝을 확인해 준다. LiveNerf는 9월 24일부터 하루 한 차례 추적을 시작했다. 9월 29일에는 Claude 여러 서비스에서 약 한 시간 동안 오류가 증가했고, 다음 날부터 X와 Reddit의 체감 불만이 더 눈에 띄게 늘었다. 10월 2일 BridgeBench는 94.2%를 표시했으며, 10월 3일 LiveNerf는 첫 10일 기준선 수집을 마쳤다.
이 시간 순서는 조사 가설을 만드는 데 유용하지만 인과관계는 아니다. 특히 Claude 공식 상태 페이지의 9월 29일 사건은 오류율 증가 기록이다. 그것만으로 9월 30일 이후의 짧은 답변이나 지시 누락을 설명할 수 없다. 9월 30일, 10월 2일과 10월 3일에는 별도 사건이 게시되지 않았다는 점도 함께 봐야 한다. 상태 페이지가 조용하다는 사실 역시 품질 문제가 없었다는 보증은 아니다.
LiveNerf는 무엇을 고정했고 무엇을 아직 말하지 못하나
LiveNerf 공개 저장소는 지금까지 나온 자료 중 가장 구조적인 장기 검증이다. GPQA Diamond, MMLU-Pro, 경쟁 수학과 AIME 2025·2026의 2,336문항을 먼저 네 번씩 살펴본 뒤, Opus 5.5가 항상 맞히거나 항상 틀리지 않는 78문항만 주 평가판으로 고정했다. 구성은 MMLU-Pro 59개, GPQA 12개, 경쟁 수학 4개, AIME 3개다.
평가는 Claude Code 2.1.280, high effort, 짧은 고정 시스템 프롬프트, 빈 작업 폴더와 단일 턴을 사용한다. 도구, MCP 서버, 설정, 훅, 메모리와 프로젝트 지침을 불러오지 않는다. 같은 문항을 자기 기준선과 짝지어 비교하고, Opus 5도 대조군으로 돌린다. 10월 3일까지 누락 없이 10일이 끝났고, 하루 78개의 주 평가 표본을 기준으로 보면 780개의 기준선 표본이다. 저장소가 말하는 하루 90회에는 대조군 호출도 포함된다.
중요한 점은 아직 결과 구간이 아니라 기준 구간이라는 사실이다. 사전 등록 규칙은 다음 10일과 그다음 10일에서 모두 99% 구간이 0을 벗어나고, 변화가 최소 3점이며, 같은 변화가 대조군에 나타나지 않아야 변화를 선언한다. 따라서 최초 공식 판정은 10월 24일경에나 가능하다. 기준선을 보고 하락이나 회복을 말하는 것은 자를 만들면서 길이 변화를 선언하는 것과 같다.
7.5점 검출력과 78문항의 한계
LiveNerf가 예측한 최소 검출 가능 변화는 10일 구간당 약 7.5점이다. 작고 점진적인 2~5점 변화가 실제로 있어도 이 설계가 놓칠 수 있다. 검증 단계에서 Opus 5로 바꾼 결과도 99% 기준에서는 Opus 5.5와 구분되지 않았다. 즉 이 장비는 큰 이동을 확인하는 데 유용하지만, 모든 종류의 모델 교체를 알아내는 감지기가 아니다.
문항 품질도 완벽하지 않다. 78개와 이후 제외된 2개를 사람이 다시 검토했을 때 답안 키가 잘못됐을 가능성이 있는 문항 8개, 애매한 문항 30개가 보고됐다. 프로젝트는 이를 삭제하지 않고 사전 등록된 민감도 분석으로 따로 계산한다. 이는 숨길 결함이 아니라 결과 해석에 붙어야 할 오차 요인이다.
무엇보다 측정 대상은 한 기기·한 위치에서 Claude Max 구독과 headless Claude Code로 제공되는 Opus 5.5다. 원시 API, claude.ai 일반 채팅, 긴 컨텍스트, 웹 검색, MCP, 실제 저장소 수정과 다중 턴 에이전트 작업은 직접 재지 않는다. 한국 구독 이용자의 체감과 가깝다는 장점이 있지만 “모든 제품 표면에서 같은 하락”으로 일반화할 수 없다.
BridgeBench 94.2%가 확정 너프를 뜻하지 않는 이유
BridgeBench의 Opus 5.5 이력은 10월 1일 103.8%, 10월 2일 94.2%를 표시했다. 한 번의 검사 사이 9.6%포인트가 움직였고 최신값은 출시 기준보다 5.8% 낮다. 조사할 이유가 되는 변동이다. 다만 이 페이지 자체가 90~110%를 정상 변동 구간으로 정의하므로, 94.2%를 “BridgeBench가 확인한 너프”라고 소개하면 원 자료의 판정을 뒤집게 된다.
BridgeBench 방법 설명에 따르면 이 수치는 과제 성능만이 아니라 토큰과 비용 요소를 합친 독자적인 power 지수다. 페이지의 0.6·0.2·0.2 가중치는 설명용 예시이며, 실제 과제·범주·가중치는 비공개다. 지금까지 공개된 시험도 네 번뿐이어서 외부 연구자가 같은 입력과 채점으로 재현하거나 어느 구성 요소가 하루 변화를 만들었는지 분해하기 어렵다.
BridgeMind의 X 게시물도 94.2% 하락을 알리면서 정상 변동 범위 안이라고 설명했다. 숫자는 숨길 필요가 없지만, 그 숫자에 붙은 범위와 표본 수를 떼어내면 안 된다. 현재 BridgeBench는 경보등이지 원인 판정서가 아니다.
ModelSentiment 65는 성능 점수가 아니다
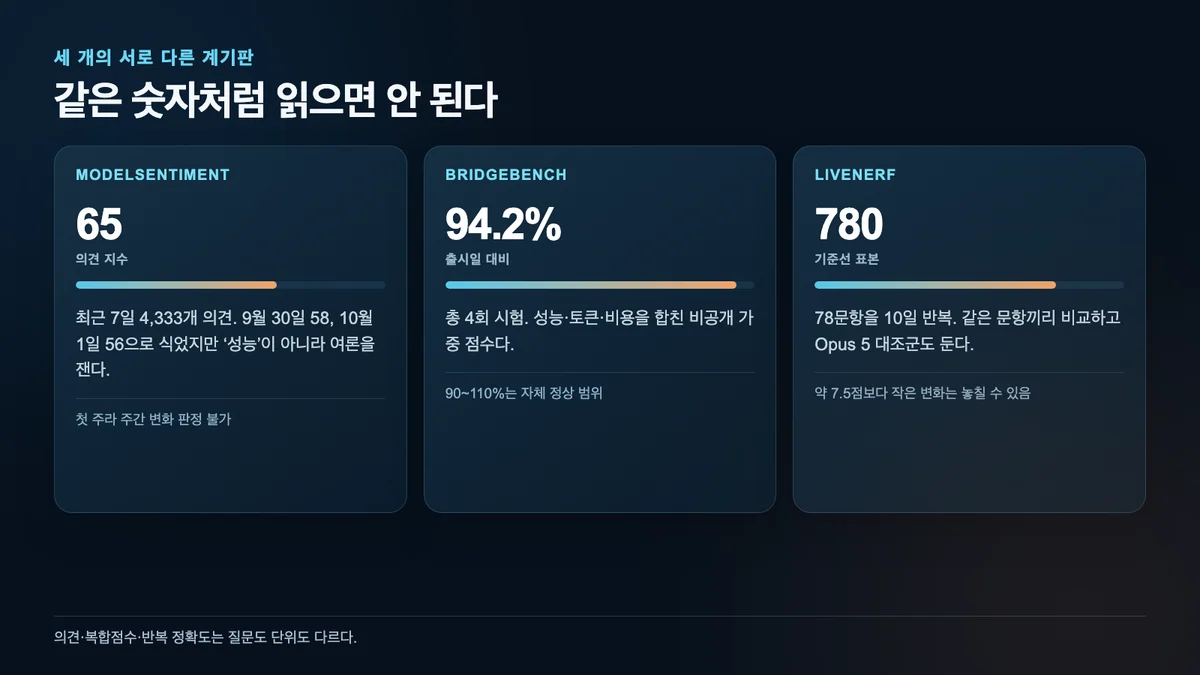
ModelSentiment의 Opus 5.5 페이지는 10월 3일 08:16 UTC 기준 최근 7일 의견 4,333개와 스레드 1,301개를 바탕으로 지수 65, 신뢰 구간 62~68을 표시했다. 일별 값은 9월 30일 58, 10월 1일 56으로 식었다가 10월 3일 진행 중 표본에서 73으로 반등했다. 출시 첫 주라 전주 대비 변화는 아직 계산할 수 없다.
이 지표의 이름 그대로 측정 대상은 Reddit의 의견이다. 모델 정답률이나 코드 테스트 통과율이 아니다. 불만이 늘어난 시점을 찾고 어떤 실패 유형을 시험 과제로 만들지 정하는 데는 유용하지만, 게시물의 부정적 어조·커뮤니티 구성·화제 집중의 영향을 받는다. 여론 65, 복합 power 94.2%, 반복 정답 표본 780을 한 그래프의 같은 단위처럼 비교하면 안 된다.
X와 Reddit은 체감의 위치를 알려 준다
LiveNerf Day 8 Reddit 토론은 당시 공개 논의로 가는 맥락 링크로만 남겼다. 현재 직접 원문을 안정적으로 불러오지 못했으므로 이 스레드를 본문의 수치·판정 근거나 원문 표현 대조 자료로 사용하지 않았다. 기준선 상태와 판정 시점은 공개된 LiveNerf 저장소에서 확인했으며, 체감 신고는 검증할 증상 후보이지 모델 변경의 증명이 아니다.
Claude Code 이슈 #96205는 Windows와 Claude Code 2.1.280에서 발생한 구체적인 품질 저하 신고다. 플랫폼·버전·피드백 ID가 있어 막연한 불평보다 조사 가치가 높다. 그러나 재현 프롬프트와 고정된 비교 출력, 반복 횟수, 실제 응답 모델과 effort가 없어 전면적인 A/B 결과로 취급할 수는 없다.
독립적인 LiveNerf 방법 검토는 동결 평가판의 장점과 검출력·귀속 한계를 함께 설명한다. 체감 신고는 “어디를 측정할지”를 알려 주고, 반복 평가는 “얼마나 움직였는지”를 확인한다. 둘 중 하나를 다른 하나의 대체물로 쓰는 것이 이번 논쟁의 가장 큰 오류다.
고정 모델 ID가 반박하는 것과 반박하지 못하는 것
Claude 모델 ID와 버전 정책은 Claude 4.6 이후 날짜가 없는 모델 ID가 과거의 가변 convenience alias와 다르다고 설명한다. claude-opus-5-5 같은 ID는 그 ID가 유지되는 동안 고정된 기반 모델 버전을 가리킨다. 이 약속은 동일 ID 뒤에 다른 가중치를 조용히 끼우는 강한 형태의 너프 주장과 맞지 않는다.
하지만 여기서 “사용 경험 전체가 고정된다”로 뛰어넘으면 안 된다. API 게이트웨이, 제품 라우터, 안전 분류기, Claude Code 버전, 도구 정책, 시스템 프롬프트, 캐시와 장애는 모델 ID 밖에 있다. 고정 ID는 기반 모델을 특정하는 강한 단서이지, 한 세션에서 최종 결과를 만든 모든 계층의 해시가 아니다. 전면 너프가 아직 입증되지 않았다는 결론과 일부 사용자 경험이 실제로 나빠질 수 있다는 결론은 동시에 참일 수 있다.
medium 기본값과 thinking 변화도 비교 조건을 바꾼다
Opus 5.5 변경 사항에 따르면 기본 effort는 medium이고 adaptive thinking은 항상 켜진다. Opus 5의 기본값은 high였다. 두 모델 모두 설정을 생략한 채 비교하면 같은 조건이 아니다. Claude Code 업데이트나 SDK 기본값까지 달라졌다면 모델만 바꾼 실험도 아니다.
thinking 블록과 도구 호출 사이 진행 표시 방식도 바뀌었다. 사용자는 화면이 조용해진 것을 덜 생각한다고 느낄 수 있고, 낮은 출력 한도에서는 생각에 쓴 토큰과 최종 답변 공간의 균형이 달라질 수 있다. 모델 품질을 비교하려면 medium, high 또는 xhigh를 명시하고 출력 상한을 고정해야 한다. 응답 길이만으로 추론량을 대신 판단하지 않는 것도 중요하다.
fallback은 모델 너프와 다른 현상이다
Anthropic의 모델 전환 도움말은 특정 안전 분류 상황에서 Claude 앱과 Claude Code가 Opus 5 또는 Opus 4.8로 전환될 수 있다고 설명한다. 공식 제품 표면에서는 전환 사실과 답한 모델을 표시해야 하고, API에서는 fallback이 기본값이 아니라 선택 구성이다.
이는 Opus 5.5의 가중치가 내려갔다는 주장의 증거가 아니다. 그러나 사용자가 알림을 놓쳤거나 대화가 전환된 모델에 머물렀다면 체감은 매우 비슷할 수 있다. 재현 기록에는 선택한 모델뿐 아니라 응답에 표시된 모델과 fallback 알림을 함께 남겨야 한다. 안전 관련 내용이 파일, 메모리, 검색 결과에서 들어왔을 가능성도 살펴야 한다.
긴 대화의 자동 요약은 새 세션과 같은 시험이 아니다
Claude 유료 플랜의 컨텍스트 설명은 지원되는 환경의 최대 100만 토큰 컨텍스트와 한계에 가까워질 때의 자동 요약을 설명한다. 긴 Claude Code 세션에는 폐기된 요구사항, 실패한 도구 결과, 오래된 파일 경로와 압축된 결정이 누적된다. 오늘의 한 줄 프롬프트가 어제와 같아도 실제 입력 전체는 같지 않다.
문제가 난 세션을 보존한 뒤 같은 저장소 커밋에서 새 세션을 열어 비교하는 이유가 여기에 있다. 새 세션은 정상이고 긴 세션만 실패한다면 사용자가 겪은 품질 문제는 여전히 실제다. 다만 원인 후보는 전면 모델 너프보다 컨텍스트 관리와 하네스 쪽으로 이동한다. 반대로 새 세션에서도 고정 조건 아래 반복 하락이 남으면 더 강한 회귀 신호가 된다.
한국 이용자가 30분 안에 할 수 있는 진단
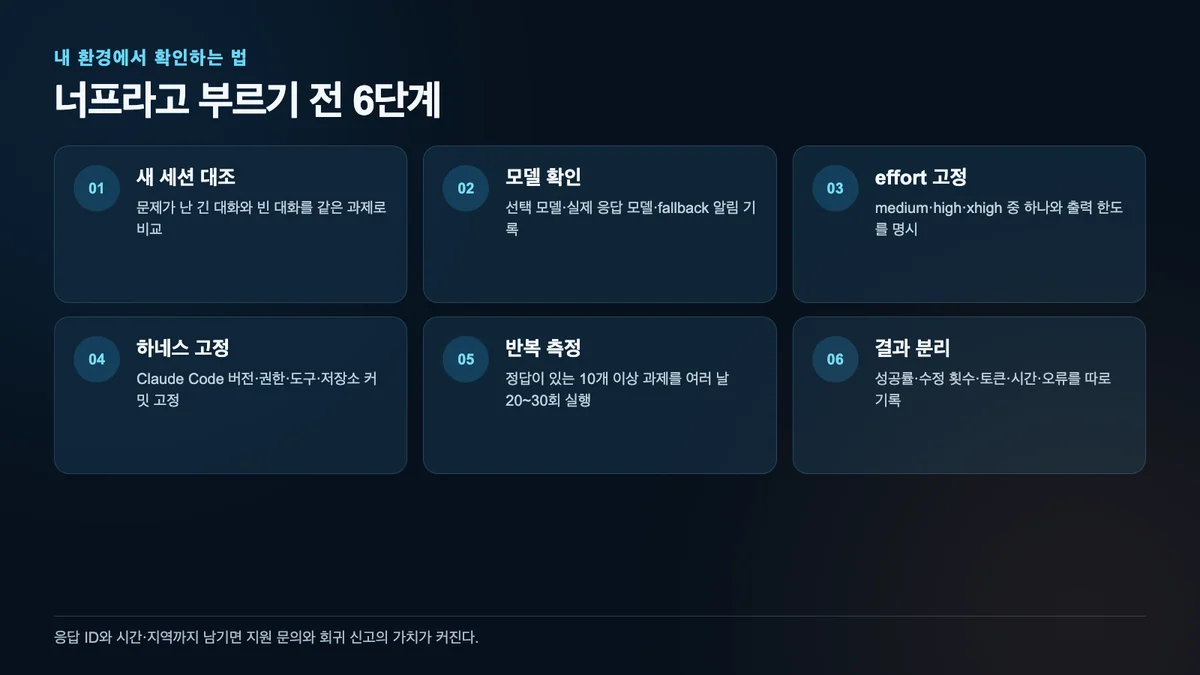
- 실패한 대화는 지우지 말고, 동일 과제를 빈 대화에서 다시 실행한다.
- 모델 선택기, 응답 표시와 전환 알림을 캡처해 실제로 답한 모델을 확인한다.
- effort와 출력 상한을 명시한다. 이전 모델과 비교할 때도 같은 값을 쓴다.
- Claude Code 버전, 저장소 커밋, 도구, 권한, MCP와 프로젝트 지침을 고정한다.
- 정답이나 테스트가 있는 과제 10개 이상을 골라 여러 시간대에 20~30회 반복한다.
- 첫 시도 성공률, 수정 횟수, 누락, 토큰, 완료 시간과 하드 오류를 한 점수로 합치지 말고 따로 기록한다.
구독형 제품에서는 API와 같은 서버 로그를 모두 얻기 어렵다. 그래서 응답 ID, 날짜·시각, 지역, 앱·CLI 버전, 표시 모델과 최소 재현 절차가 더 중요하다. 회사 저장소나 개인정보가 포함된 프롬프트를 그대로 공개할 필요는 없다. 재현에 필요한 구조만 비식별화해 지원 문의와 이슈에 제공하면 된다.
다음 판정을 바꿀 수 있는 증거
10월 24일 이후 LiveNerf의 두 비교 구간이 같은 방향으로 사전 등록 기준을 넘고 대조군은 움직이지 않는다면, 구독형 Claude Code 경로에서 Opus 5.5의 측정 가능한 하락이 있었다는 강한 근거가 된다. API에서 고정 모델 ID와 고정 요청 조건으로 여러 지역이 같은 회귀를 재현하면 적용 범위가 더 넓어진다. Anthropic이 장애 사후 분석이나 제공 계층 변경을 공개한다면 원인 귀속도 달라진다.
반대로 LiveNerf가 기준선 범위에 머물고 BridgeBench가 정상 구간에서 오르내린다면, 현재의 신고는 특정 워크로드·세션·라우팅 또는 하네스 문제로 좁혀질 가능성이 커진다. 어느 결과든 체감 신고를 무시할 이유는 없다. 좋은 결론은 신고를 지우는 것이 아니라, 실패가 재현되는 층을 정확히 찾는 것이다.
10월 3일 최종 결론
체감 급락 신고는 실제 조사 신호이고, 일부 측정값도 흔들렸다. 그러나 Claude Opus 5.5가 전면적으로 너프됐다는 주장은 아직 입증되지 않았다. BridgeBench 94.2%는 자체 정상 범위 안이다. ModelSentiment 65는 여론 지수다. LiveNerf의 780개 주 기준선 표본은 비교의 출발점이지 하락 결과가 아니다.
따라서 지금은 “확정 너프”라는 제목보다 모델 ID와 제품 경로를 분리하고, 10월 하순 판정을 기다리며, 자신의 실패 사례를 재현 가능한 데이터로 바꾸는 편이 정확하다. 이 글의 판단은 2026년 10월 3일 스냅샷이며 이후 자료에 따라 갱신될 수 있다.
출처와 편집 고지
- 공식 출시: Anthropic, Claude Opus 5.5
- 모델 버전: Claude Platform, model IDs and versions
- 모델 동작: Claude Platform, what’s new in Opus 5.5
- 모델 전환: Anthropic Help Center, why Claude switched models
- 컨텍스트: Anthropic Help Center, paid-plan context window
- 서비스 기록: Claude Status
- 반복 추적: LiveNerf
- 복합 지수: BridgeBench Opus 5.5 history
- 방법론: BridgeBench, how Nerf Bench works
- 의견 지수: ModelSentiment, Claude Opus 5.5
- 커뮤니티 맥락 링크(판정 비의존): Reddit, LiveNerf Day 8 update
- 제품 신고: GitHub, Claude Code issue #96205
- 당일 공지: BridgeMind의 X 게시물
- 독립 검토: Stackness, frozen eval panel and LiveNerf
Anthropic과 Claude 명칭 및 상표는 각 권리자에게 속한다. 쥬곰닷컴은 Anthropic, LiveNerf, BridgeBench 또는 ModelSentiment의 후원·승인을 받은 공식 사이트가 아니다. 수치와 게시물은 사실 확인 경로로만 연결했으며 원문 표현, 게시물 화면, 프로필 이미지, 표와 차트는 복제하지 않았다. 접근이 막힌 Reddit 링크는 결론에 의존하지 않는 커뮤니티 맥락으로만 분류했다. 본문과 인포그래픽은 공개 자료를 서로 다른 증거 수준으로 재구성한 독립 편집물이다.