GPT-6.1 Sol 기능과 API 가격 Astra 비교와 선택 가이드
GPT-6.1 Sol을 볼 때 중요한 질문은 가장 강한 모델인가보다, 내 업무에 필요한 결과를 어떤 비용으로 얻을 수 있는가다. OpenAI는 복잡한 개발과 전문 업무에서 Astra에 가까운 성능을 낮은 비용으로 제공하는 위치로 설명한다. 이 표현은 회사의 제품 설명이며, 모든 작업에서 같은 결과가 나온다는 보장은 아니다.
이 글은 2026년 9월 30일 공식 모델 문서를 기준으로 기능, API 요금과 선택 방법을 정리한다. 비용 예시는 직접 계산한 가정이며 실제 청구 결과나 사용 성능을 측정한 자료가 아니다. ChatGPT 구독의 사용량과 API 토큰 요금은 별도로 이해해야 한다.
Sol을 어떤 역할로 볼 것인가
GPT-6.1 Sol은 판단이 필요한 복잡한 작업에서 비용을 함께 고려할 후보 모델이다. 개발 자료를 읽고 변경안을 만들거나 여러 근거를 비교해 문서를 만드는 업무에서 검토할 수 있다. 반면 가장 까다로운 문제에서 Astra가 제공할 추가 품질의 가치가 크다면 같은 입력으로 비교하는 편이 낫다.
작업 이름만으로 선택을 고정하지 않는다. 같은 코딩이라도 짧은 수정과 여러 서비스가 얽힌 문제 조사는 다르다. 실패했을 때의 영향, 사람이 검토할 시간과 재시도 횟수까지 결과 비용에 포함해야 한다.
문서의 모델 ID는 gpt-6.1-sol이다. GPT-6 Sol과 이름이 비슷해도 동일한 버전이라고 가정하면 안 된다. 호출 설정과 평가 기록에는 사용한 ID를 남겨 결과를 재확인할 수 있게 한다.
입력과 문맥과 출력 한도
이 모델은 텍스트와 이미지를 입력받고 텍스트를 출력한다. 오디오와 동영상 입력은 해당 모델의 지원 범위가 아니다. 이미지 생성 도구를 쓸 수 있다는 사실과 모델이 직접 이미지 출력 모델이라는 말도 구분해야 한다.
현재 모델 문서의 문맥 창은 1,050,000토큰, 최대 입력은 922,000토큰, 최대 출력은 128,000토큰이다. 문맥 창 숫자 전체를 사용자 입력으로 채울 수 있다고 생각하면 안 된다. 출력과 추론에 필요한 공간도 고려해야 한다.
큰 문맥은 많은 자료를 다룰 여유를 주지만, 모든 자료를 항상 넣는 것이 좋은 전략은 아니다. 관련 없는 문서가 늘면 근거 확인과 비용 관리가 어려워진다. 필요한 자료를 고르고, 답변의 근거를 추적할 구조를 만드는 일이 먼저다.
추론 설정과 도구 호출
추론 노력 설정은 low, medium, high, xhigh와 max를 지원하고 기본값은 medium이다. none과 minimal은 지원되지 않는다. 높은 설정은 더 깊은 작업을 시도할 수 있지만 지연과 사용량을 함께 평가해야 한다.
도구 호출에는 Responses API를 사용한다. Chat Completions 지원만 보고 도구 실행도 같은 방식으로 가능하다고 생각하면 안 된다. 웹 검색, 파일 검색과 컴퓨터 사용 등은 실제 도구 구성과 권한, 해당 경로의 제한을 따른다.
처음에는 익숙한 업무 하나로 기본 설정을 평가하고, 품질이 부족한 경우에만 노력을 조정하는 방법이 현실적이다. 기능 지원 표는 필요한 서비스의 연결과 실제 실행 성공을 보장하는 표가 아니다.
Standard API 요금 읽는 법
단문 Standard 기준 100만 토큰당 입력은 2달러, 캐시된 입력 읽기는 0.10달러, 캐시 쓰기는 2.50달러, 출력은 10달러다. 입력·출력·캐시 쓰기와 읽기는 같은 항목이 아니다.
272,000 입력 토큰을 초과하면 요청 전체가 장문 구간으로 계산된다. 입력과 캐시 요율은 단문 대비 2배, 출력은 1.5배다. 초과분만 비싸지는 방식으로 계산하면 비용을 과소평가한다.
Fast는 Standard의 2배 요금이며 Batch와 Flex는 Standard보다 50% 낮은 가격으로 안내된다. 지역 처리는 제공되는 경우 추가 요금이 붙는다. 도구별 요금도 있어 토큰 비용만으로 최종 금액을 확정할 수 없다.
직접 계산한 요청 비용 예시
첫 번째 예시는 캐시를 쓰지 않는 입력 100,000토큰과 출력 10,000토큰이다. 단문 Standard에서는 입력 0.20달러와 출력 0.10달러를 합쳐 0.30달러다. 도구 요금과 지역 추가 비용은 제외했다.
두 번째는 입력 300,000토큰과 출력 10,000토큰이다. 장문 기준으로 입력 전체가 100만 토큰당 4달러, 출력은 15달러가 된다. 합계는 1.35달러다. 같은 출력량이어도 입력 임계값을 넘으면 가격 구조가 바뀐다.
세 번째는 100,000 입력 토큰이 모두 캐시 읽기로 인정되고 출력이 10,000토큰인 가정이다. 입력 0.01달러와 출력 0.10달러로 0.11달러지만, 최초 캐시 쓰기 비용은 이 계산에 포함하지 않았다. 캐시는 요청했다고 항상 같은 절감이 생기는 혜택으로 볼 수 없다.
Astra와 비교할 평가 항목
같은 업무와 자료를 주고, 형식이 예쁜지보다 필요한 결과가 맞는지 확인한다. 개발이라면 테스트 성공, 변경 범위와 누락된 조건을 본다. 조사라면 근거 출처와 모순 처리, 문서라면 핵심 요구와 사실 보존을 검토한다.
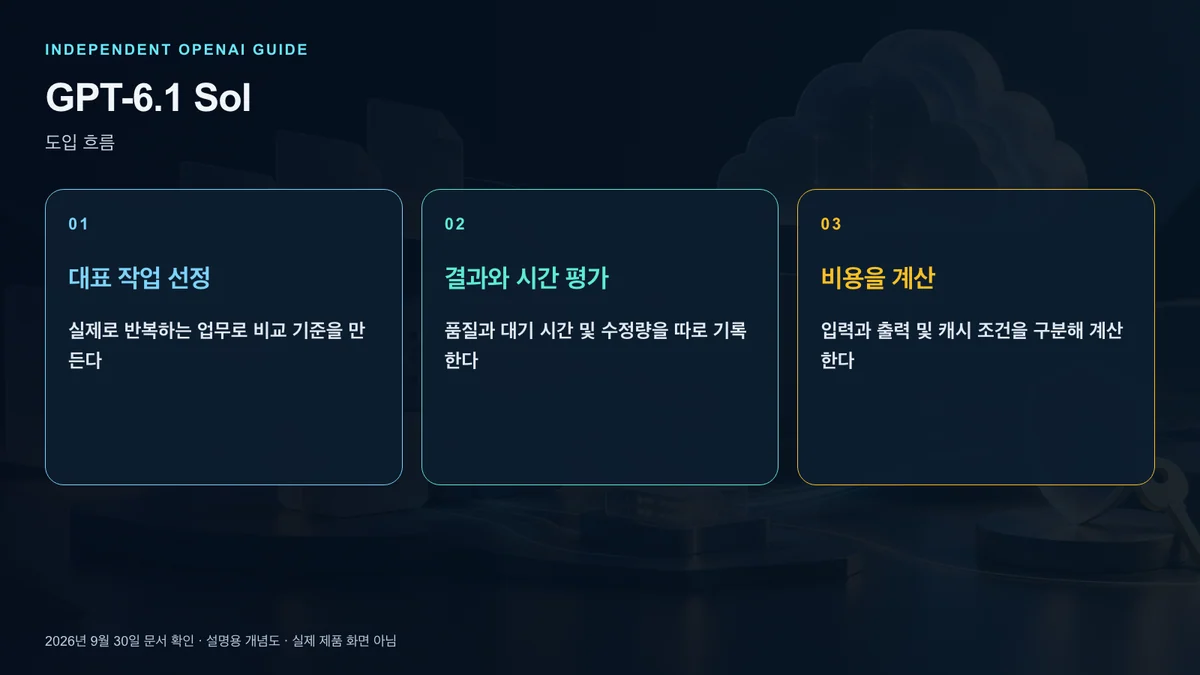
자체 평가 예시로 대표 작업 12개를 만들고 성공 여부, 총 사용량, 대기 시간과 사람이 고친 시간을 기록할 수 있다. 이는 공식 벤치마크가 아니라 팀이 직접 설계하는 비교 방법이다. 재시도까지 포함하면 싼 단가가 곧 낮은 업무 비용은 아님을 확인하기 쉽다.
한국 서비스의 예산에서는 달러 요율을 고정 원화 요금처럼 표시하지 않는다. 결제 시점과 세금, 지역 처리 조건이 다를 수 있다. 반복 사용량과 오류 비용을 먼저 계산하고 모델을 선택한다.
데이터 지역과 구독 제공 조건
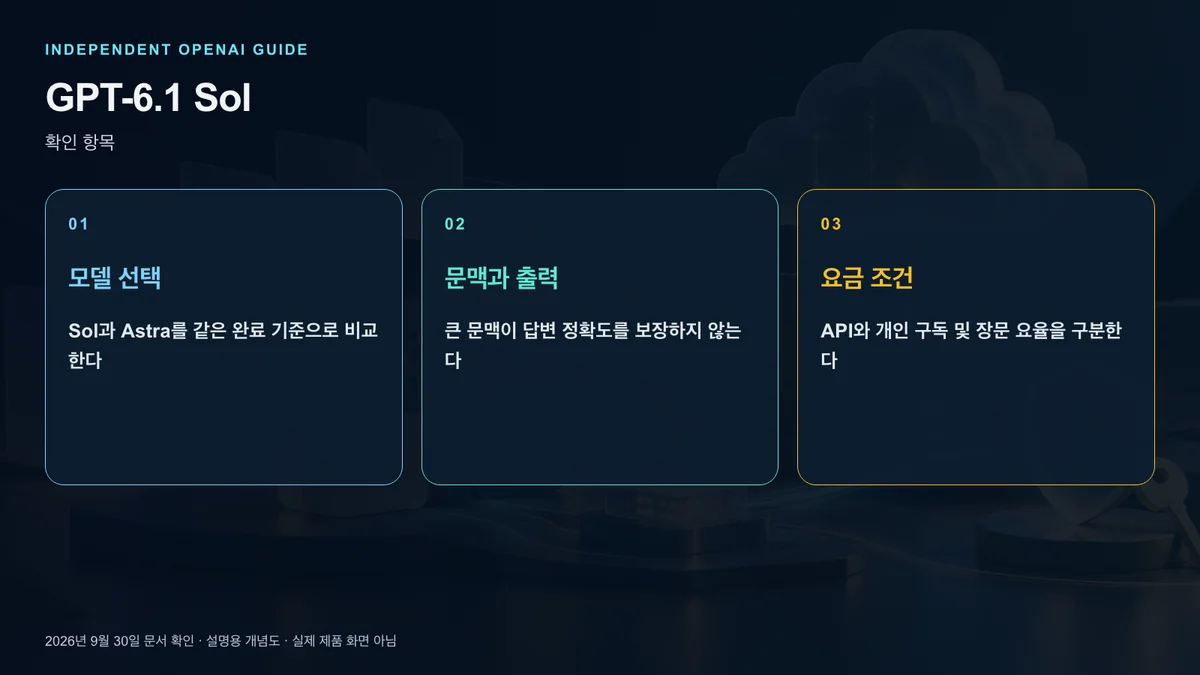
모델 문서는 미국과 EU 데이터 레지던시 지원을 안내하지만, EU 레지던시에서 Fast는 사용할 수 없다고 설명한다. 모델 지원, 조직의 자격과 처리 경로의 지원은 각각 확인해야 한다.
API에서 모델을 호출할 수 있는 것과 ChatGPT Work 또는 Codex의 구독 계정에서 선택할 수 있는 것도 별개다. 플랜별 모델 목록과 사용량 안내를 확인한다. API 단가로 구독에 포함된 작업 횟수를 역산하면 안 된다.
어떤 경우에 도입할까
복잡한 작업을 반복하며 비용이 중요하고, 결과를 검토할 기준이 준비돼 있다면 Sol을 비교 대상으로 삼기 좋다. 이미 만족스러운 모델을 쓰고 있다면 이름만 보고 교체하기보다 대표 입력으로 먼저 확인한다.
Sol의 가치는 사양 숫자 하나에 있지 않다. 필요한 품질, 허용 지연과 실제 총비용을 함께 평가해 모델을 배치할 때 드러난다. 이 글의 계산은 출발점이며, 배포 전에는 당시 가격표와 계정 제공 상태를 다시 확인해야 한다.
자료와 권리 안내
이 글은 OpenAI와 제휴하지 않은 독립적인 기능 해설이다. 제품명은 해당 권리자의 상표이며 식별 목적으로 사용했다. 그림은 설명용 일러스트와 개념도이며 실제 제품 화면이나 OpenAI 공식 이미지가 아니다.
출처: OpenAI Developers — Model specification · Model selection · API pricing · Work and Codex models · Subscription usage