AI半導体競争の本当のボトルネックはメモリー――HBM4と韓国サプライチェーン
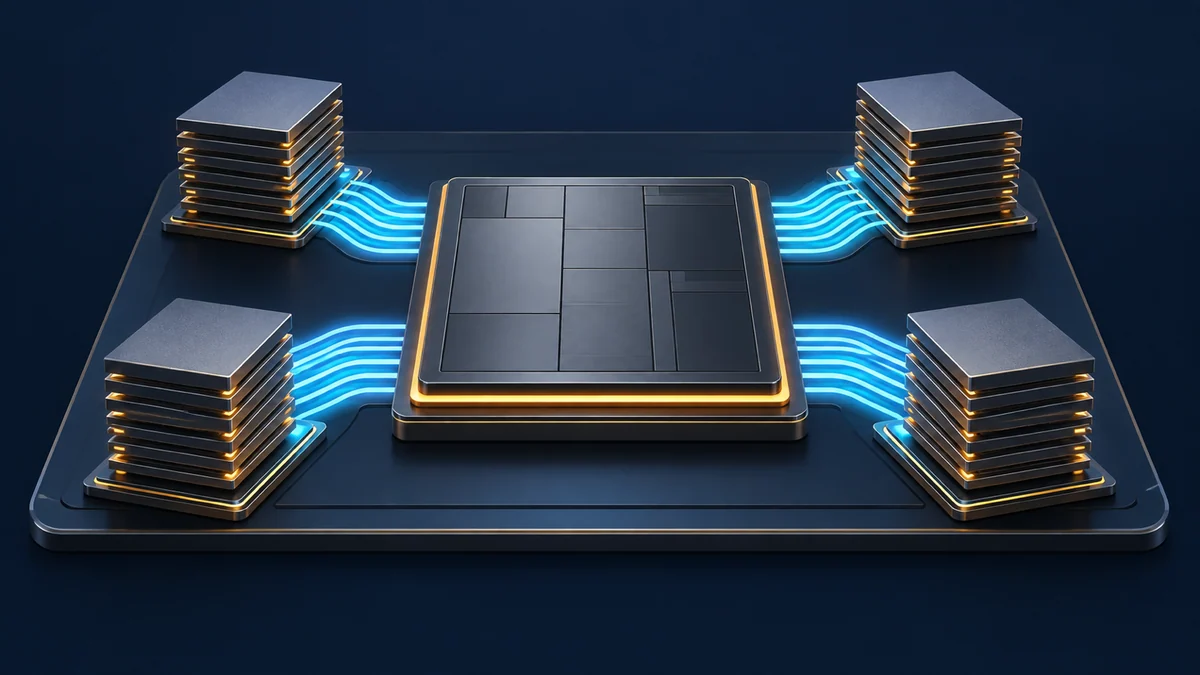
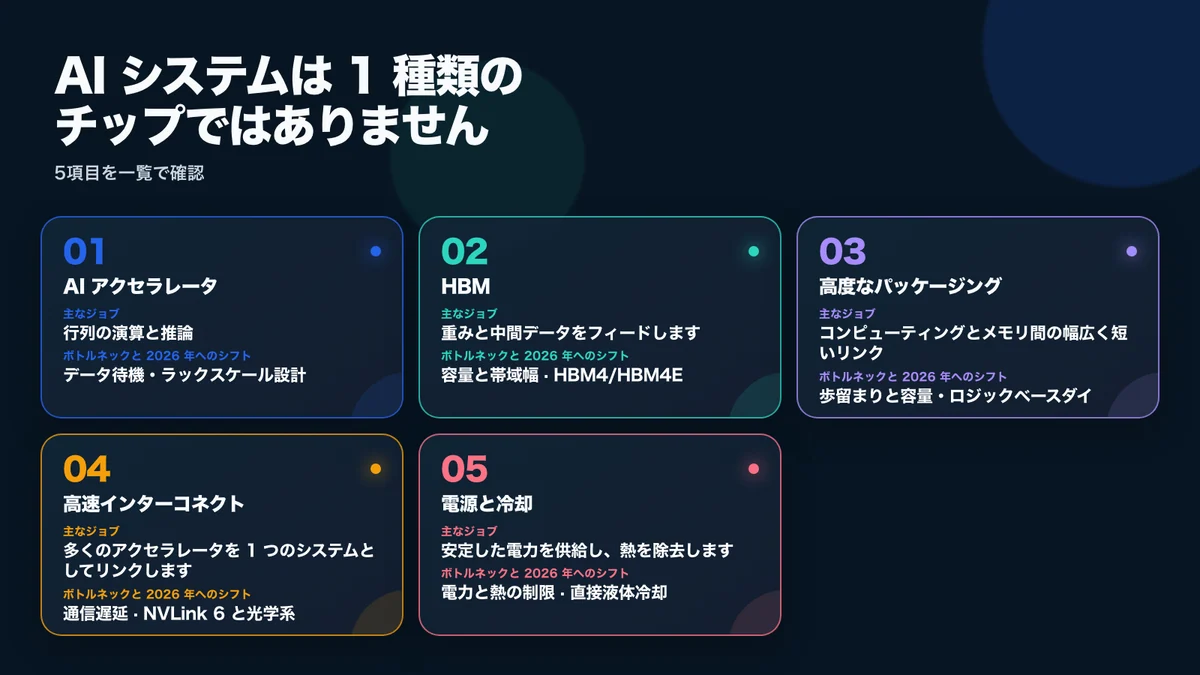
AI半導体の競争は、GPUが1秒間に何回の演算を処理できるかという数字だけでは説明できない。演算器が高速でも、モデルの重みや途中の計算結果が間に合わなければ、GPUはデータを待つことになる。この待ち時間を減らすため、アクセラレーターの近くに配置される積層型メモリーがHBM(High Bandwidth Memory)だ。
2026年の焦点は、その次世代規格であるHBM4に移っている。NVIDIAはVera RubinプラットフォームをHBM4の利用を前提に設計し、Samsung Electronics、SK hynix、Micronは量産や次世代HBM4Eのサンプル供給を進めている。なかでも韓国は、メモリーの生産だけでなく、ファウンドリー、パッケージング、基板、装置・素材まで含む供給網の重要な位置を占める。
ただし、HBMの性能が高ければAIサーバーが完成するわけではない。製造歩留まり、ロジックを担うベースダイ、先端パッケージング、冷却、高速インターコネクト、顧客による認証がそろって、初めて実際のシステムとして出荷できる。
要点
- HBMは演算チップのそばで大量のデータを並列に送り、アクセラレーターがメモリーを待つ時間を減らす。
- HBM4は容量と帯域幅を拡大する一方、積層、発熱対策、パッケージングの難度も引き上げる。
- メーカーが発表する速度や効率は、顧客認証、量産歩留まり、実システムでの性能と分けて読む必要がある。
AIシステムはGPUだけでは動かない
一般的なDRAMは、プロセッサーから離れたメモリーモジュールとして接続される。これに対してHBMは、複数のメモリーダイを縦方向に重ね、シリコン貫通電極などで接続し、演算チップの近くに実装する。信号自体を高速化するだけでなく、同時にデータを送れる経路を大幅に増やす仕組みだ。
この構造には製造上の難しさが伴う。薄く加工したダイを正確に積み重ね、接続不良や反りを抑えながら、熱を外へ逃がさなければならない。さらに、GPUと複数のHBMスタックを結ぶインターポーザーや先端基板も、高い歩留まりで供給する必要がある。
そのため、HBM用ウェハーの生産量が増えても、パッケージング能力が不足すれば完成品の出荷は伸びない。AI半導体のボトルネックは、工程の進展に応じてメモリーから実装、冷却、ネットワークへ移り得る。
メモリー帯域幅が足りなければ演算器は待たされる
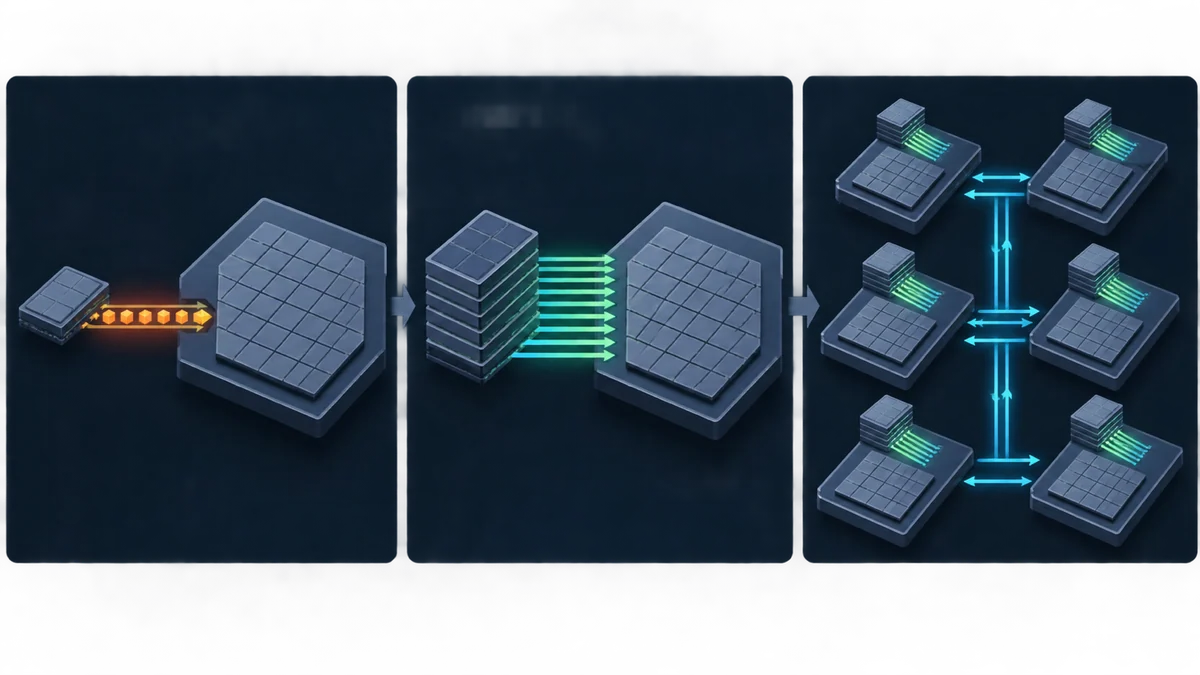
大規模モデルの推論では、保存された重みを繰り返し読み込み、先に処理したトークンの状態を保持しながら、複数のリクエストを並行して処理する。演算能力だけを増やしても、メモリーから十分な速さでデータを渡せなければ、高価なアクセラレーターの一部は待機状態になる。長いコンテキストや利用者数の増加に対応するには、メモリー容量とデータ転送効率の両方が重要だ。
NVIDIA Technical BlogによるRubinアーキテクチャの説明では、Rubin GPUは最大288GBのHBM4を搭載し、ピーク時に最大毎秒22TBのメモリー帯域幅を提供するとされている。NVIDIAはGPU単体ではなく、Vera CPU、NVLink 6、ネットワーク、ラック全体を組み合わせ、長時間のエージェント型推論や多数の同時処理に対応する構成を示している。
ここで注意したいのは、毎秒22TBが特定プラットフォームにおける最大仕様だという点だ。HBM4の1スタックだけでこの帯域幅が出るという意味ではなく、すべてのアプリケーションが理論上のピーク値を継続して利用できるわけでもない。実効性能はモデル構造、演算精度、バッチサイズ、キャッシュの使い方、チップ間通信などに左右される。
SamsungのHBM4発表は段階を分けて読む
Samsung Electronicsは、2026年2月のグローバル向け発表と韓国向け発表で、HBM4の量産と商用製品の出荷を開始したと説明している。同社が示したデータ転送速度はピン当たり11.7Gbpsで、最大13Gbpsまでの余裕を持たせ、1スタック当たり最大毎秒3.3TBの帯域幅を提供するという。
12層製品の容量は24〜36GBで、16層では最大48GBを計画している。SamsungはHBM3Eとの比較で電力効率が40%、放熱性能が30%向上したとしている。ただし、これらはメーカー自身が公表した製品仕様であり、第三者による独立評価や、あらゆるアクセラレーター上で確認された実測結果ではない。
HBM4では、積層したメモリーの土台となるベースダイの役割も大きくなる。Samsungは1c世代のDRAMプロセスと4nmのロジックベースダイを組み合わせている。メモリーセルの製造だけでなく、ロジック設計、ファウンドリー工程、パッケージングを一体で調整する能力が競争力に直結する。
同社は別のAMDとの協業発表で、HBM4がAMD Instinct MI455X GPUとHeliosプラットフォームを支えるとしている。これは会社による将来計画の説明であり、実際の採用規模や出荷時期とは区別して受け止める必要がある。
SK hynixはHBM4Eのサンプルを供給
SK hynixの2026年6月の発表によると、同社は12層HBM4Eのサンプルを主要顧客へ供給した。公表値はピン当たり最大16Gbpsで、従来製品との比較では電力効率が20%超向上し、熱抵抗が17%低減したとしている。
ただし、サンプル供給は量産完了や商用出荷と同じ節目ではない。顧客は特定のアクセラレーターと組み合わせ、信号の安定性、発熱、エラー、耐久性、互換性などを検証する。必要に応じて設計を調整したうえで認証へ進むため、「最初のサンプル」という表現だけで市場での優位性を判断することはできない。
SamsungとSK hynixの発表を、数字だけで単純な順位にすることも難しい。製品世代、積層数、顧客ごとの仕様、消費電力の条件、測定方法が異なる可能性があるからだ。同じHBM4Eという名称でも、カスタマイズされたベースダイや接続先のアクセラレーターによって、実際の動作特性は変わり得る。
設計からデータセンターまで続く供給網
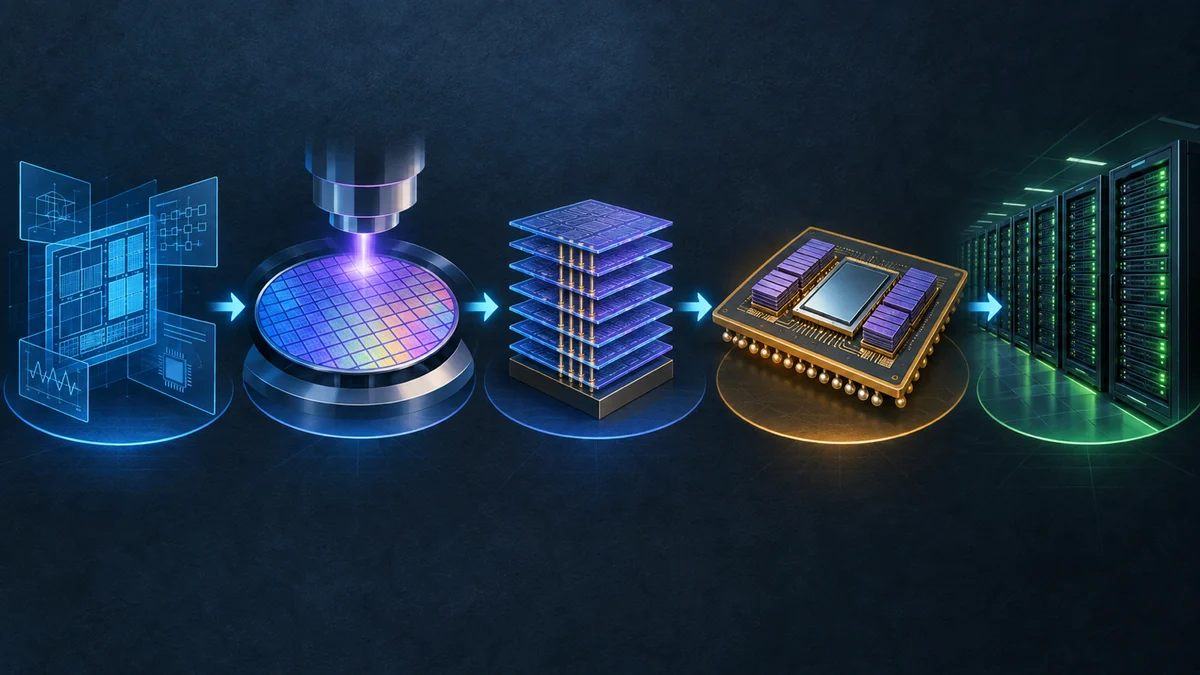
AIアクセラレーターが稼働するまでには、複数の工程と企業が関わる。
- GPUやASICの設計企業が、演算アーキテクチャとメモリーインターフェースを決める。
- ファウンドリーが演算ダイやHBM用ロジックベースダイを製造する。
- メモリーメーカーがDRAMダイを作り、縦方向に積層する。
- 先端パッケージング工程で、演算ダイと複数のHBMスタックを短く広い経路で接続する。
- 基板、電源、ネットワーク、冷却を組み合わせ、サーバーやラックに仕上げる。
- クラウド事業者がソフトウェアとスケジューラーを最適化し、実サービスを運用する。
いずれか一つの工程が不足すれば、別の工程で完成した部品が出荷待ちになる。したがって、HBMの出荷予測だけでAIインフラ全体の成長を測ったり、GPUの受注量だけでデータセンターの稼働開始時期を推定したりするのは危険だ。
米国の輸出管理は販売先だけでなく製品計画にも影響する
AI向け半導体は一般の産業製品であると同時に、安全保障上の輸出管理対象でもある。米国商務省産業安全保障局の2026年1月の発表では、NVIDIA H200、AMD MI325X、それらと同等クラスの半導体について、中国向け輸出申請を条件付きの個別審査へ移行した。申請者には、米国顧客向けの生産能力、購入者の規則順守体制、米国内の第三者による試験などに関する要件が示されている。
現行の米国輸出管理規則Part 740では、大韓民国が人工知能認可の対象国リストに含まれている。ただし、韓国で製造されたメモリーや韓国向け取引が一律に自動承認されるという意味ではない。対象製品の分類、最終利用者、設置場所、所有関係、再輸出条件などによって適用は変わる。
輸出管理は最終的な販売先だけでなく、製品の性能設定、顧客確認、データセンターの場所、契約条件にも関わり得る。規則は変更される可能性があるため、製品発表時の制度と、実際の出荷時に有効な制度を分けて確認する必要がある。
韓国の強みと供給網のリスク
韓国には大手メモリーメーカー2社に加え、ファウンドリー、基板、パッケージング、装置、素材に関わる産業がある。韓国科学技術情報通信部の2026年業務計画は、累計3万7000基のGPU確保と、韓国独自のK-NPU事業の推進を掲げている。海外のAIインフラへ部品を供給しながら、国内需要も拡大しようとする方針だ。
一方で、特定のアクセラレーター企業や少数の大口顧客、限られたパッケージング工程への依存はリスクになる。顧客側のプラットフォーム開発が遅れたり、認証に時間がかかったりすれば、メモリーそのものが仕様を満たしていても売上計上の時期は動く。
また、HBM向けに製造設備、先端工程、投資資金を振り向ければ、一般的なDRAMの供給にも影響する可能性がある。ただし、それだけを根拠にパソコンやスマートフォン向けメモリーの価格変動まで断定することはできない。
製品発表を確認するためのチェックポイント
- 速度の数字は、ピン当たり、1スタック当たり、GPUパッケージ全体のどれを示しているか
- 発表の段階は、サンプル供給、顧客認証、量産開始、商用出荷のどこか
- 電力効率や放熱性能の比較対象と測定条件が示されているか
- 積層数、容量、ベースダイの製造プロセスは何か
- パッケージング、ネットワーク、電力、冷却の制約も考慮されているか
- メーカー公表値と第三者によるシステムベンチマークが区別されているか
- 輸出管理と最終利用者に関する条件を、実際の出荷時点で再確認したか
実用的な結論
HBM4はAI半導体の付属部品ではない。モデルのデータをアクセラレーターへどれだけ速く届けられるかを左右し、長いコンテキストや多数の同時リクエストに対応できるシステムの範囲を広げる。SamsungとSK hynixによるHBM4、HBM4Eの開発競争は、韓国の供給網が世界のAIインフラに深く組み込まれていることを示している。
それでも、勝敗を一つの公表スペックで決めることはできない。十分な歩留まりで量産し、顧客のアクセラレーターで認証を通過し、先端パッケージングと冷却を安定させ、必要な数量を予定どおり届けるところまでが競争だからだ。
発表を読む際は、「最速」「量産」「出荷」といった言葉だけを見るのではなく、その数字がどの範囲を示し、どの段階まで確認されたものかを確かめたい。2026年のAI半導体競争を理解するには、GPU、HBM、パッケージ、ネットワーク、電力、冷却を一つのシステムとして見ることが最も実用的だ。
出典と利用について
- NVIDIA Technical Blog:Rubin GPUアーキテクチャ — Eduardo Alvarez、Vishal Mehta、Farshad Ghodsian
- Samsung Global Newsroom:HBM4の量産・商用出荷
- Samsung Newsroom Korea:HBM4の量産・出荷
- Samsung Global Newsroom:SamsungとAMDの次世代AIメモリー協業
- SK hynix Newsroom:12層HBM4Eサンプルの供給
- 米国商務省産業安全保障局:半導体輸出許可の審査方針
- 米国輸出管理規則Part 740
- 韓国科学技術情報通信部:2026年業務計画
本記事は、上記の公式資料に記載された製品仕様と発表内容を照合し、独自の構成と表現で解説したものです。各社の性能・効率に関する数値は、特に断りがない限り各社自身の発表に基づき、第三者による検証結果とは区別しています。出典元の写真、製品レンダリング、図表は複製していません。商標および製品名は、報道・分析対象を識別する目的でのみ使用しています。