AIで科学者の作業は週約7時間短縮、その先で検証が新たなボトルネックに
AIを使う科学者は、平均すると1週間に約7時間を節約できたと回答した。しかし、分析や仮説づくりが速くなっても、実験装置、臨床での確認、フィールド調査、人による監査まで同じ速さになるわけではない。研究の前半が効率化されるほど、後半の検証工程に仕事が集中する可能性がある。
この傾向を示したのが、Google、Google DeepMind、MIT FutureTechによる共同研究「AI in Science: Early Insights」だ。研究チームは、約1500万件のGemini利用記録、2690件の科学特化型AIモデル、米国と英国で活動する科学者637人への調査という性格の異なる資料を、共通の研究タスク分類に沿って分析した。
ただし、「週約7時間」という数字は、AI導入前後の研究成果を実験的に測定したものではない。科学者本人が見積もった平均的な時間短縮であり、そのまま科学的成果の増加を意味するわけでもない。調査対象も無作為に選ばれた科学者全体の縮図ではなく、日本の研究者を対象にした調査でもない。
要点
- 汎用LLMはコーディング、文献調査、文章作成、一般的な分析で広く使われ、科学特化型モデルは予測、分類、分子設計、シミュレーションなど専門性の高い作業を担っていた。
- 回答者のおよそ4分の3が時間短縮を報告した一方、41%は未検証の仮説が増えたと答えた。時間を節約できた人の46%は、その4分の1を超える時間をAI出力の監査や検証に使っていた。
- 研究機関が実際の成果を増やすには、モデルや計算資源だけでなく、実験設備、臨床・現場での確認、データ品質、再現性、独立したレビューにも投資する必要がある。
研究を支える三つの資料
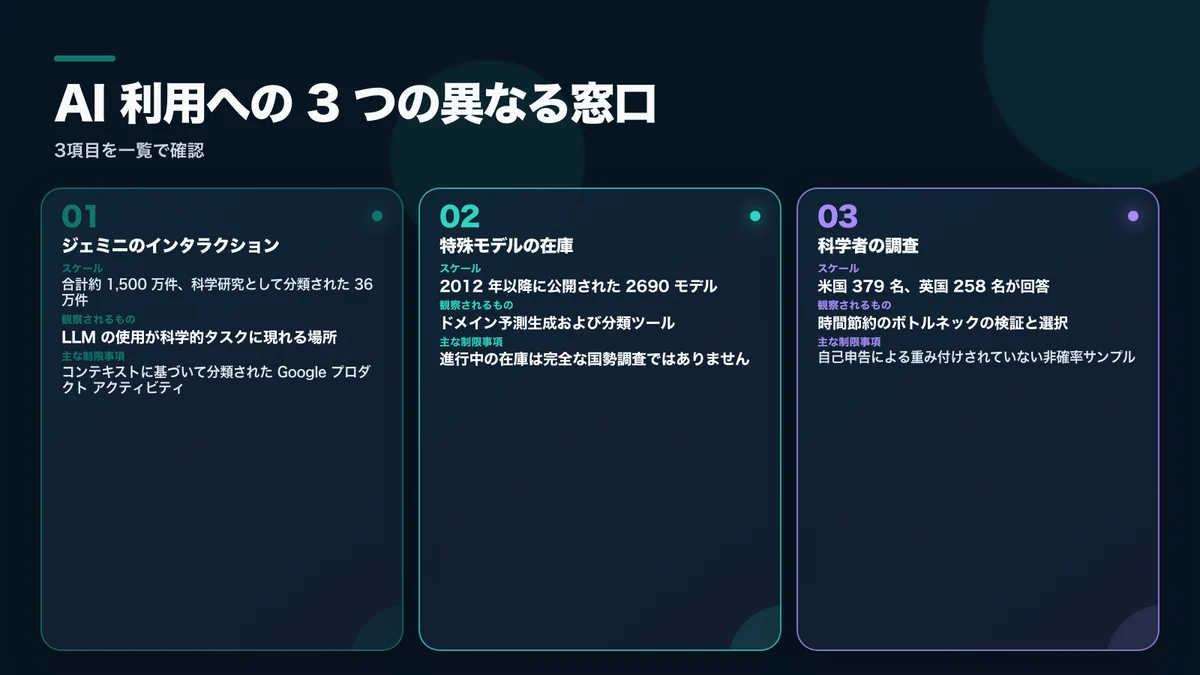
今回の研究では、異なる特徴を持つ三つの資料が組み合わされた。
- Geminiの利用記録は、実際のやり取りを大規模に観察できる一方、利用者一人ひとりの職業を雇用記録などで確認したものではない。
- 科学特化型AIモデルの一覧は、各分野でどのようなシステムが公開されてきたかを示すが、世界中のモデルを漏れなく収録した登録簿ではない。
- 科学者へのアンケートは、時間短縮や仕事の変化を本人の視点から把握できる一方、回答者の記憶や自己評価に左右される。
三つの資料は互いを補うが、同じ数字を測っているわけではない。特に、Geminiの利用記録から「週約7時間」が直接計測されたわけではない点には注意が必要だ。
汎用LLMと科学特化型モデルは役割が異なる
研究の一次資料は、すべてのAIを一つの道具として扱っていない。Geminiのような汎用LLMは、研究コードの作成やトラブル対応、統計分析、論文の検索・整理、原稿の下書きなど、分野をまたいで発生する作業に利用されていた。
これに対して科学特化型モデルは、疾患の予測、分子構造の設計、材料探索、分類、複雑なシミュレーションなど、専門データと領域知識が深く関係する場面で目立った。調査結果では、科学者がAIを使う時間の約41%が汎用のチャット・文書系LLM、約30%が科学特化型モデルに割り当てられていたという。
この割合は自己申告であり、回答者によって道具の分類方法が異なる可能性がある。それでも、汎用LLMが既存の科学ソフトウェアや専門モデルをすべて置き換えたという構図ではなく、複数のツールが補完し合っている様子がうかがえる。
科学特化型モデルの一覧には、2012年以降に公開され、関連論文と公式コードリポジトリを確認できる2690件が含まれる。生物学、医学、化学、材料科学、気象など複数の領域を対象としているが、研究チーム自身も完全なモデル台帳ではなく、更新途上の資料だと位置づけている。
「週約7時間」はどのように算出されたのか
科学者へのオンライン調査は、独立した調査事業者によって2026年7月27日から8月11日まで実施された。回答者は米国379人、英国258人の計637人で、大学、非営利研究機関、企業の研究開発部門などに所属する科学者が含まれている。対象分野は物理・工学、生命科学、保健・臨床科学、社会科学だった。
回答者のおよそ4分の3は、AIを使うことで時間を節約できたと答えた。平均は1週間当たり7時間弱で、浮いた時間の多くは追加の研究活動に振り向けられたと報告されている。また、68%は他分野の知見へアクセスしやすくなったと答え、89%は今後さらに研究成果が増えると予想した。
一方、この調査は、条件をそろえた研究室をAI利用群と非利用群に分けて比較する無作為化試験ではない。回答者が自分の仕事を振り返って見積もった結果であり、積極的にAIを使う人が参加しやすかった可能性や、過去の作業時間を正確に思い出せない可能性もある。
研究チームは、米英のあらゆる科学者を正確に代表する標本抽出の枠組みがないため、結果に人口構成を反映する重み付けをしておらず、一般的な世論調査のような誤差範囲も示していない。したがって、週約7時間は「すべての科学者に保証される効果」ではなく、今回の回答者が報告した平均値として読むべき数字だ。
ボトルネックは消えず、後工程へ移る
研究は連続した工程で成り立つ。AIが文献を整理し、コードを書き、短時間で多数の仮説を提案できても、研究室の装置、試料、臨床試験の参加者、現地調査の機会、倫理審査の処理能力まで自動的に増えるわけではない。
調査では、回答者の約44%が、過去2年間で主な制約が実験、臨床での確認、フィールドデータの収集、原稿作成など、より後ろの工程へ移ったと答えた。未検証の仮説が増えたという回答は41%で、減ったという回答は約25%だった。
検証そのものにも時間がかかる。AIによる時間短縮を経験した回答者の89%は、節約した時間の少なくとも10%をAI出力の確認に使っていた。さらに46%は、節約分の25%を超える時間を監査と検証に充てていた。研究では、この負担が生命科学で特に大きいことも報告されている。
ただし、これらの数値だけで、AIがすべてのボトルネックを引き起こしたと断定することはできない。調査が示しているのは、AI利用の拡大、研究手順の変化、検証負担の増加が同じ回答者層で並行して報告されているという関係だ。
成果物の量と重要な発見は同じではない
回答者の49%は、AIの利用によって、評価基準やデータが整った安全で漸進的な研究課題を選びやすくなったと答えた。一方、よりリスクが高く新規性のある研究に取り組みやすくなったという回答は28%だった。
研究では、データが豊富で正解を判定しやすい問題から先にAI活用の費用が下がる「街灯効果」の可能性が指摘されている。明るく見えやすい場所にある問いは効率よく処理できても、データが少なく、実験コストが高く、評価方法も固まっていない問いが同じように前進するとは限らない。
論文の草稿、分析結果、コード、候補物質などの数が増えても、再現可能な発見が同じ割合で増えるわけではない。生成が安くなる一方で確認能力が変わらなければ、研究者の仕事は「つくる作業」から「大量の候補を選別する作業」へ移る可能性もある。
そのため、生産性を見る際には、成果物の数だけでなく、仮説から検証済みの結果に至るまでの時間、再現率、訂正の頻度、装置の待ち時間、データやコードの来歴、監査に必要な工数、否定的な結果を保存できているかといった指標も重要になる。
日本の研究現場で確認したいこと
研究は、科学特化型AIモデルの開発が米国、中国、英国、欧州連合、韓国、カナダなどに集中していると分析している。しかし、科学者アンケートの対象は米国と英国であり、日本の研究環境を直接測った結果ではない。週約7時間という数字を、日本の大学、研究機関、企業の研究所にそのまま当てはめることはできない。
日本の組織がAI導入の効果を評価するなら、契約しているモデルの数や利用回数だけでなく、研究工程全体を確認する必要がある。
- 文献調査や解析が速くなった後、実験装置や試料処理の待ち時間は増えていないか
- 元データ、ソフトウェア、モデルのバージョン、プロンプト、人による修正を記録しているか
- AIが提案した結果を、生成担当者とは別の人やチームが確認できるか
- 検証に必要な時間と人員を、予算や業績評価の中で正式に扱っているか
- 再現できなかった結果や否定的な結果も保存し、同じ誤りの繰り返しを防いでいるか
- 計算資源だけでなく、共同利用設備、臨床支援、フィールド調査、データ管理にも投資しているか
AIへのアクセスだけを増やし、物理的な実験や人によるレビューの能力を据え置けば、未検証の候補が積み上がるおそれがある。反対に、実験の自動化、共有設備、標準化されたデータ、独立した再現チームを組み合わせれば、前工程で節約した時間を信頼できる研究成果へつなげやすくなる。
ATLASの利用記録と科学者調査を混同しない
GoogleのATLAS方法論によると、Geminiアプリ、Google AI Mode、Gemini APIから2026年4月6日から19日までに収集した匿名化済みの利用記録14,653,926件が自動分類された。公開集計では、利用者が10人未満の集団を除外し、差分プライバシーを適用したと説明されている。
この記録は、大規模な利用行動を観察する資料としては有用だが、利用者全員の職業を人事情報などで確認したものではない。科学関連とされた約36万件も、会話内容や職業上の文脈から科学的な作業である可能性を推定した結果だ。
これに対し、週約7時間の短縮や検証時間の割合は、7月から8月に実施された別のアンケートに基づく。Geminiの製品ログから科学者の作業時間を直接測った、と説明するのは誤りになる。
ATLASのデータはGoogle製品を中心としており、企業契約による一部の有料Gemini API利用は含まれない。ほかの企業のAI、組織内の閉鎖型システム、ローカルモデル、オフラインの科学ソフトウェアも網羅していない。約1500万件という規模は大きいが、世界中の科学AI利用を数えた全数調査ではない。
実用的な結論
AIは、コーディング、文献調査、分析、定型的な準備作業を短縮し、専門分野を越えた知識への入口を広げる実用的な道具になりつつある。ただし、科学研究の最終地点は、もっともらしい文章や仮説を生成することではなく、証拠によって結果を確かめることにある。
週約7時間という数字は、確定済みの生産性向上率ではなく、研究現場の時間配分が変化していることを示す手がかりとして扱うのが適切だ。組織が見るべきなのは、AIで何時間浮いたかだけではない。その時間がどの作業から生まれ、検証にどれだけ戻り、最終的に再現可能な成果へ変わったかである。
モデルや計算資源を拡充するなら、実験、臨床・現場での確認、データ品質、監査、再現研究も同時に強化する必要がある。AIによる生成速度と、研究機関の検証能力を同じペースで高められるかどうかが、時間短縮を実際の科学的発見へつなげる条件になる。
出典と利用について
- Google, Google DeepMind and MIT FutureTech, AI in Science: Early Insights
- MIT FutureTech, AI in Science研究紹介
- Google AI, AI & Economy ATLAS方法論
- Google, 2026年9月のAI & Economy ATLAS更新
本記事は、資料に記載された数値、方法、留保を照合し、観察ログとアンケート結果を区別して独自の文章で再構成したものです。自己申告による時間短縮を因果関係の証明として扱わず、米国・英国の調査結果を日本を含む全科学者の代表値には拡張していません。元資料の図表、写真、製品画面、長い引用文は転載していません。