AIが次のAI開発を加速する時代へ:Anthropicが示した再帰的自己改善の実像と限界
AIがコードを書き、実験結果を分析し、次世代のAIモデル開発を支える――その循環は、もはや遠い未来だけの話ではない。Anthropicが公表した再帰的自己改善に関する研究は、AIが人間から完全に独立して自らを進化させたと宣言するものではない。焦点は、AI研究所の仕事をAIがどれほど速め、その成果として生まれた新しいモデルが次の開発をさらに加速するのか、という現実的なフィードバック構造にある。
同社は研究部門の人員130人を対象に調査し、2026年3月にMythos Previewを使った場合、回答者が認識した成果量の増加は中央値で約4倍だったと報告した。また、エンジニア1人当たりの四半期のコード出荷量は2021年から2025年までに約8倍となり、Claude Codeが社内の自由度の高い課題に成功した割合は約26%から91%へ上昇したという。
ただし、これらは主としてAnthropic内部の調査や測定である。自己申告に基づく指標が含まれ、一部ではClaudeが作った成果物をClaudeで評価している。大きな数字だけを切り取って、独立した外部研究で確定した一般法則のように扱うべきではない。
要点
- 現在確認されているのは、AIが研究組織内のコード作成、実験、評価を高速化する段階であり、目標や計算資源まで自律的に管理する完全な自己改善ではない。
- Anthropicは成果量約4倍、コード出荷量約8倍、社内課題の成功率91%という指標を示しているが、組織の拡大や開発ツールの変化、評価方法の影響を切り分けることは難しい。
- AIが候補となるコードや仮説を大量に作れるようになるほど、検証、研究方針、計算資源の配分、安全性の判断といった人間側の工程が新たなボトルネックになる。
- 企業や研究機関にとって重要なのは、生成量の多さだけではなく、AIの成果を独立した方法で確かめ、採用や公開の可否を決める仕組みである。
Anthropicが公表した主な指標
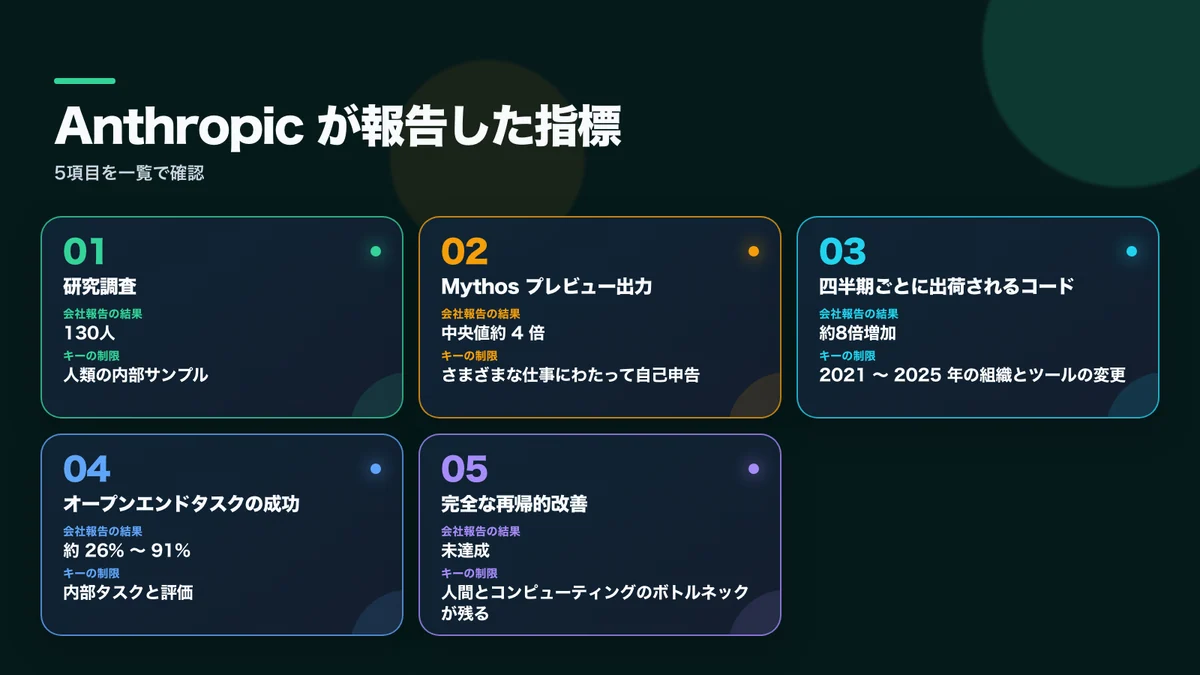
Anthropicの資料に登場する主な数値は、次のように整理できる。
- 研究部門の人員130人を対象に社内調査を実施した。
- Mythos Previewを利用した回答者は、AIの支援がない場合と比べた成果量を中央値で約4倍と見積もった。
- エンジニア1人当たりの四半期のコード出荷量は、2021年から2025年にかけて約8倍になったとされる。
- Claude Codeによる社内の自由度が高い課題の成功率は、約26%から91%に上がったと報告されている。
- 一部の評価では、Claudeによる成果物をClaudeが判定する方法が採用された。
ここで重要なのは、各数字が同じ方法で測られたわけではない点だ。約4倍という値は研究者の自己申告を中心とする一方、コード出荷量や課題成功率は社内の運用指標である。いずれもAnthropic内部の変化を知る材料にはなるが、別の企業や研究機関にもそのまま当てはまるとは限らない。
「再帰的自己改善」とは何を指すのか
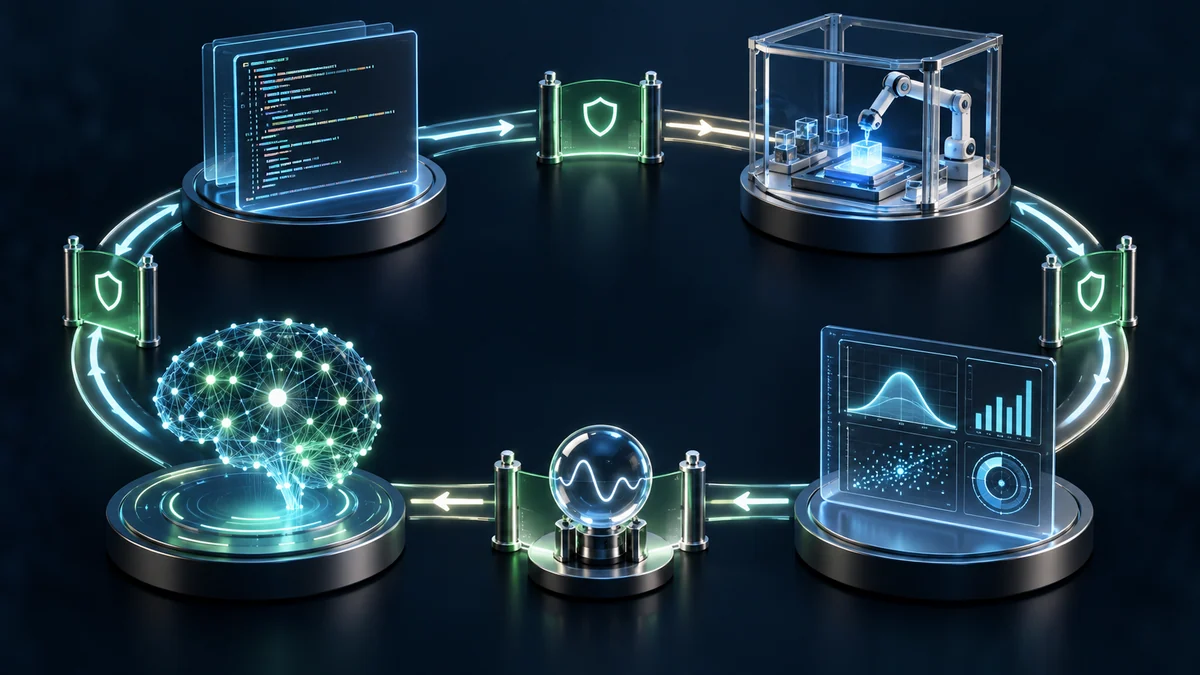
再帰的自己改善を広い意味で捉えると、AIがAI研究を支援し、その結果として作られた、より能力の高いAIが次の研究をさらに支援する循環を指す。
例えば、モデルが学習用コードの不具合を見つけたり、データを選別したり、新しい実験案を提案したりする。別のモデルがその結果を評価する場合もある。こうした支援によって次世代モデルの開発が速くなれば、完成したモデルは次のサイクルで、さらに強力な研究アシスタントとして利用される。
一方、より強い意味での再帰的自己改善は、AIが人間の助けを受けずに目標、学習データ、モデル構造、計算資源、配備までを管理し、自らの能力を繰り返し高める状態を意味する。Anthropicは、現時点でそこまで到達したとは説明していない。
研究課題を選ぶこと、高価な計算資源をどこへ割り当てるか決めること、危険性を評価すること、完成したモデルを公開するか判断することは、引き続き人間が担っている。したがって、現在の状況は「AIが単独で次のAIを作っている」というより、「人間が運営するAI研究開発の自動化が急速に進んでいる」と表現するほうが正確だ。
成果量「約4倍」をどう読むべきか
Anthropicは研究部門のスタッフに対し、Mythos Previewを使ったときの成果量が、支援を使わない場合に比べてどの程度増えたかを尋ねた。その回答の中央値が約4倍だった。分析、コーディング、実験の準備、文書作成など、日常的な研究作業が大幅に速くなったという実感を示す数字である。
しかし、自己申告による調査は、作業時間と完成物を厳密に管理した比較実験ではない。AIを積極的に使う人ほど調査に回答しやすい可能性があり、「成果量」の意味も仕事によって異なる。小さなコード修正を数多く終えることと、価値のある研究仮説を一つ確立することを、同じ単位では測れない。
AIによって試せる案が増えても、結果を十分に検証できなければ、科学的な生産性まで同じ割合で向上したとはいえない。むしろ、未確認の結果が大量に生まれ、研究者のレビュー待ちが増えることも考えられる。
コード出荷量が約8倍になったという指標にも、同じ注意が必要だ。2021年から2025年までの間には、Anthropicの人員、社内の開発基盤、テストの自動化、製品の範囲なども変化している。約8倍という数字のすべてをClaudeだけの効果として分離することはできない。
成功率が約26%から91%へ上がった意味
Anthropicによると、Claude Codeが社内の自由度の高い課題を完了できた割合は、約26%から91%へ上昇した。あらかじめ答え方が定められたベンチマークだけではなく、実際のコードリポジトリにある曖昧な問題を追いかけ、一定の成果にまとめる能力が改善したという主張である。
ただし、どの課題を選び、何をもって成功としたのかという詳しい条件は社内にある。一部ではClaudeがClaudeの成果を評価しているため、同じモデル系列が好む書き方や解決方法を高く評価したり、共通する見落としを発見できなかったりする可能性も考慮しなければならない。
外部で結果を再現するには、課題の定義、合格基準、人間による確認方法、失敗例の分布などが必要になる。社内課題で91%という数字は重要な進歩を示す一方、「AI研究全体の91%を自律的に実行できる」という意味ではない。コード上の問題を解くことと、価値のある科学的な問いを選び、誤った前提を捨て、公開してよい能力か判断することは別の仕事だからだ。
人間のボトルネックはどこへ移るのか
コード作成が速くなると、それまで目立たなかった制約が前面に出る。実験を動かすためのGPU、信頼できる評価データ、結果を解釈する専門家、現実の研究施設で行う実験、安全性の審査などである。
AIが1日に多数の仮説を提案できても、人間がすべてを確かめられなければ、価値のある結果を選び出す作業はかえって難しくなる。候補の生成が速くなるほど、検証能力との差が広がる可能性がある。
人間の役割は、すべてのコードや文書を手作業で生産することから、研究目標と評価基準を定め、独立した検証を要求し、失敗した場合の影響を判断することへ移っていく。人間が不要になるというより、少数の意思決定がより多くの計算資源と自動処理を動かす構造になる。そのため、決定権を誰が持ち、問題が起きたときに誰が責任を負うのかが一段と重要になる。
科学や医療で期待される効果と留保
AIが先行研究を整理し、実験用コードを書き、複数の結果を比較できれば、研究者は見込みの薄い仮説を早く退け、有望な案を深く調べやすくなる。資料では、タンパク質設計、医薬品候補、材料探索、数学のように探索範囲が広い分野が、こうした支援の恩恵を受け得るとされている。
ただし、生物学や医療の成果は、コードのテストだけでは確定しない。研究施設での再現、臨床上の安全性、多様な患者集団への配慮、規制上の手続きが必要になる。AIが開発を速めるほど、使用したデータや判断過程を追跡できる状態にし、否定的な結果も保存し、独立した研究者が同じ結論に達するかを確かめる必要性は高まる。
なぜ安全性の確保が難しくなるのか
モデル開発の速度が安全研究や評価方法の整備を上回れば、現在のモデルを十分に理解する前に次のモデルが作られる可能性がある。
さらに、AIがモデル本体だけでなく、安全フィルターや評価コードまで作成すると、同じ系列に由来する誤りが、開発対象と検査手段の両方に入り込むおそれがある。これはAIが意図的に人間を欺く場合に限らない。自動化された組織全体が同じ前提や見落としを共有するだけでも、誤りが検出されにくくなる。
そのため、再帰的な開発を安全に進めるには、回答を制限するフィルターだけでは足りない。学習環境、データ管理、評価者の独立性、サンドボックス、外部監査、公開の承認権限、事故報告まで含む仕組みが必要になる。AIが作成した研究用コードは人間や別のモデルで交差確認し、重要な最終評価は開発中のモデルから分離しておくことが望ましい。
日本の企業・研究機関が導入時に確認したいこと
日本の組織がこの動向を実務へ取り入れる場合、「AIが開発者を何人置き換えられるか」から考えるのは適切ではない。まず、現在の業務で本当に時間がかかっている工程を把握する必要がある。コード作成ではなく、テスト環境の準備、セキュリティー審査、データへのアクセス、製品レビューが遅いのであれば、生成するコードだけを増やしても待ち行列が長くなる。
初期導入では、次のような進め方が考えられる。
- 機密情報や個人情報を取り除いた社内課題を用意し、AI導入前の成功率と人間による確認時間を記録する。
- AIが作ったコードには、自動テスト、静的解析、依存関係の検査を組み合わせる。
- モデルやエージェントの開発、評価、公開承認を一つのシステムや担当者に集中させない。
- 社外APIへ送信できる情報の範囲と、入力・出力ログの保存期間を明確にする。
- 作成量だけでなく、手戻り、見逃された不具合、人間のレビュー負担も評価する。
ベンダーの社内調査で成果量が約4倍だったとしても、自社で同じ効果が得られるとは限らない。導入判断では、処理件数の増加よりも、自社環境で見逃した誤り一件がどれほどの損失や安全上の問題につながるかを重視する必要がある。
実用的な結論
AIによるAI開発の加速は、将来の仮説であると同時に、すでに研究現場で始まっている業務変化でもある。完全に自律した自己改善システムが成立したわけではないが、AIが次世代モデルのコード、実験、評価に関わり、そこで作られた強いモデルが次の開発を手伝う循環は現実になりつつある。
Anthropicが示した約4倍、約8倍、91%という数値は、その変化の方向と規模を考える材料になる。しかし、独立して検証された普遍的な性能保証ではない。自己申告、組織規模の変化、開発基盤の改善、社内評価の偏りを含めて読む必要がある。
企業や研究機関が今から備えるべきなのは、生成量を最大化する仕組みだけではない。どの成果を信頼し、どの段階で人間が止め、何を公開してよいと判断するのかを明確にすることである。AI開発が速くなるほど、競争力を左右するのは「最も多く作れる組織」ではなく、「作られたものを確実に検証できる組織」になる可能性が高い。
出典と利用について
Anthropic、Claude、OpenAI、および関連する名称や商標は、それぞれの権利者に帰属する。本記事は各社の後援、承認、監修を受けた公式コンテンツではない。企業が公表した社内測定と、独立した検証によって確定した事実を区別しながら編集した。掲載画像は説明のための編集用イメージであり、実在する研究施設や製品画面を示すものではない。