Gemini 3.8 Liveを読み解く:リアルタイム音声AIが「会話するエージェント」へ
Googleが2026年9月15日に発表した「Gemini 3.8 Live」と「Gemini 3.8 Live Extended Thinking」は、AIの声をより人間らしくするだけの更新ではない。音声と映像から状況を把握し、会話を続けながら外部ツールを呼び出し、必要であれば複数段階の推論をバックグラウンドで進めることが中心に据えられている。
変化の要点は、音声AIの役割が「質問を聞いて答える」ことから、「対話を保ちながら作業を進める」ことへ広がった点にある。ただし、会話が自然になれば、それだけで実用的なエージェントになるわけではない。実際の導入では、権限管理、処理の中断、ツール実行結果の確認、データの保存範囲といった仕組みが、声の滑らかさと同じくらい重要になる。
要点
- Gemini 3.8 Liveは応答の速さと自然な会話を重視し、Live Extended Thinkingは時間のかかる推論や複数段階の作業を想定している。
- 標準モデルはテキスト、画像、音声、動画を入力でき、関数呼び出しや検索との連携にも対応する一方、一般的なテキストモデルが備えるすべての機能を利用できるわけではない。
- 実運用の品質は、声の自然さだけでなく、中断への対応、外部操作の検証、権限の範囲、記録の保持期間によって決まる。
2つのモデルは何が違うのか
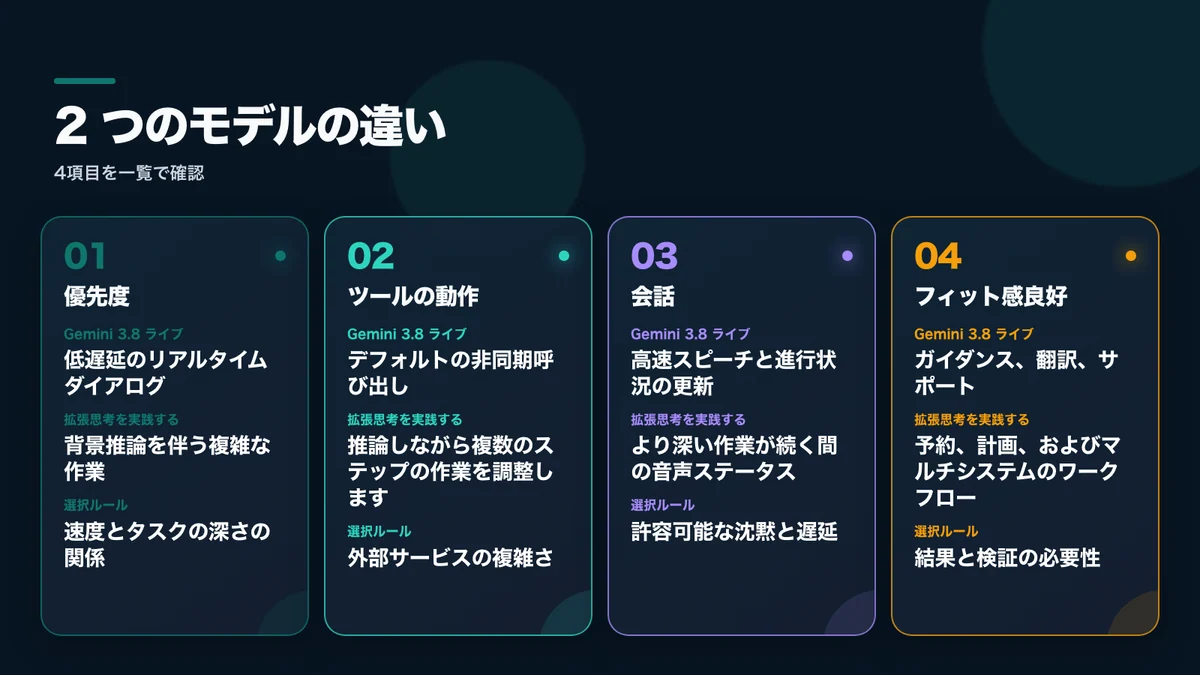
標準モデルの識別子はgemini-3.8-liveである。Googleの開発者向け資料では、入力上限が131,072トークン、出力上限が65,536トークンとされている。入力にはテキスト、画像、音声、動画を利用でき、出力はテキストまたは音声に対応する。
関数呼び出し、Live API、Google検索に基づく情報の補強には対応する。一方、キャッシュ、コード実行、ファイル検索、画像生成、構造化出力は、この標準モデルでは非対応として記載されている。したがって、「Gemini」という名称だけを見て、ほかのモデルで使える機能もすべて利用できると考えるべきではない。
Live Extended Thinkingは、リアルタイムの音声セッションを維持しながら、より複雑な推論やツール処理を裏側で進める構成だ。時間のかかる処理中に完全な沈黙へ入るのではなく、作業を続けていることを短い音声で伝えられる。サーバー側では処理中と待機状態が区別され、1回の依頼に対して複数の音声応答が返る可能性がある。
そのため、利用者に聞こえる返答が終わったことと、依頼された作業そのものが完了したことは同じではない。アプリを開発する側は、音声の再生状態だけで完了を判断せず、バックグラウンド処理の状態も確認する必要がある。
非同期ツール呼び出しが会話を変える
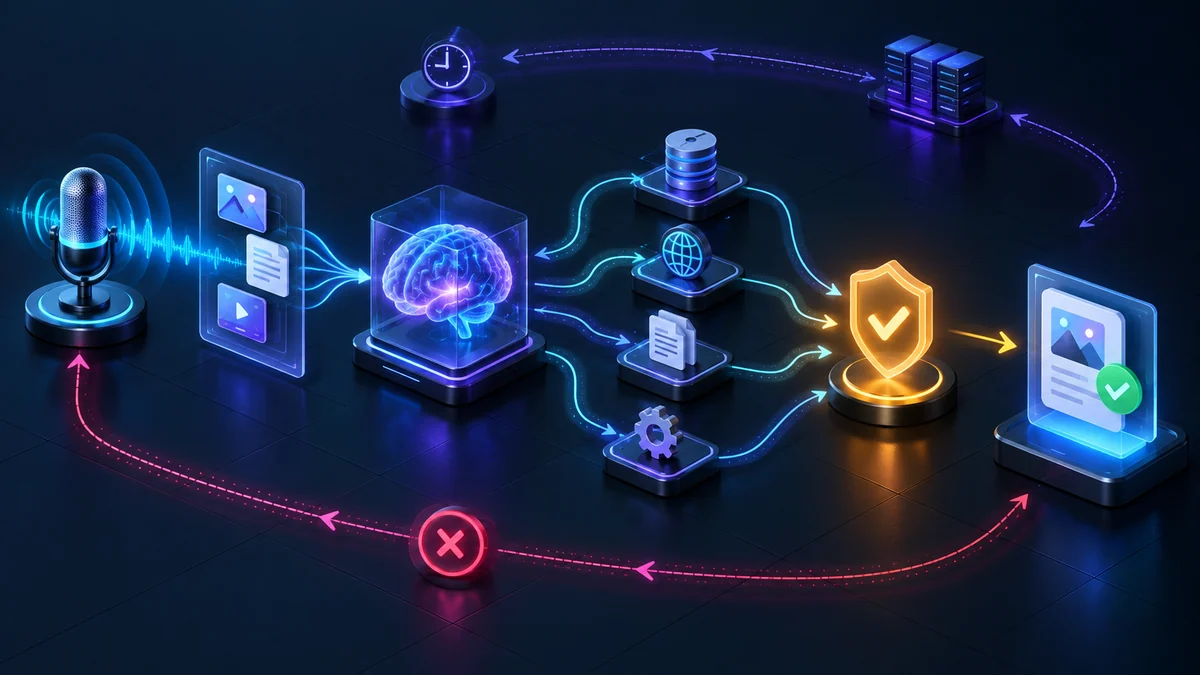
従来型の音声アシスタントは、話を聞き、1回返答し、そのやり取りを終える構造が中心だった。Gemini 3.8 Liveでは、外部ツールを非同期で動かしている間も、セッションを応答可能な状態に保つことが想定されている。
たとえば旅行支援では、フライトを検索し、カレンダーと照合している途中で、利用者が日付や条件を変更することがある。非同期処理なら、検索を進めながら変更を受け付けられる。ただし、自然に見える会話の裏側では、次のような制御が欠かせない。
- 利用者が条件を変えたとき、進行中の処理を更新または中止する
- 再試行によって予約やメッセージ送信が重複しないようにする
- 購入、予約、送信などの外部操作前に最終確認を取る
- モデルの意図ではなく、ツールが返した実際の結果を確認する
- 音声応答の終了とバックグラウンド作業の完了を区別する
- どの判断が、どの外部操作につながったのかをログで追跡できるようにする
Googleの資料では、Gemini 3.8 Liveの非同期実行は標準動作とされており、明示的にブロッキングとして宣言したツールを除き、処理中も会話を止めない設計になっている。
以前のGemini 3.1 Flash Liveプレビューから移行する開発者は、モデル名を差し替えるだけでは不十分だ。標準の3.8 Liveでは従来のthinking_level設定を受け付けないと説明されているため、関数呼び出しの動作とセッション設定をあらためて確認する必要がある。
97言語への対応は、品質が一律という意味ではない
Googleは、Gemini 3.8 Liveが対応する97言語を会話中に自動検出し、自然に切り替えられるとしている。日本語と英語が混ざる問い合わせ、外国語を使う旅行者への案内、多言語の教育やサポートなどでは有用になり得る。
ただし、対応言語の数は、すべての言語や利用環境で同じ精度が得られることを保証しない。日本語で評価するなら、少なくとも次の点を個別に試す必要がある。
- 敬語、丁寧語、くだけた話し方を文脈に応じて扱えるか
- 日本人名、地名、商品名、アルファベットを含む固有名詞を認識できるか
- 日本語と英語が一文の中で切り替わっても意味を保てるか
- 日付、金額、電話番号、住所などを正しく聞き取れるか
- 周囲に雑音がある場合や複数人が話す場面で誤認識が増えないか
- ツール呼び出し後も適切な言語と会話の調子を維持できるか
- 音声認識だけでなく、生成される日本語音声も自然か
また、APIやGoogle AI Studioで利用できる機能が、Geminiアプリ、Search Live、Google Workspaceなどに同じタイミングで提供されるとは限らない。今回の資料から日本国内の各製品における具体的な提供状況までは確定できないため、実際の画面、契約プラン、プレビュー表記を製品ごとに確認するのが安全だ。
音声とカメラはプライバシーの範囲を広げる
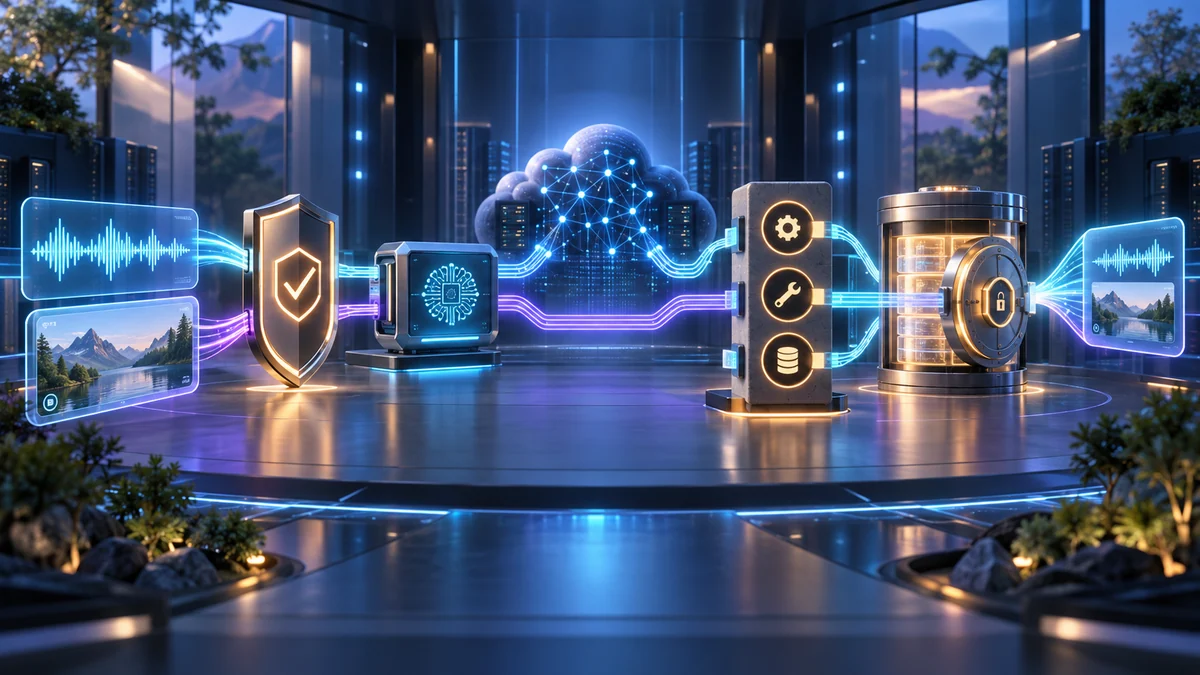
リアルタイムの音声エージェントは、文字入力型のチャットボットよりも多くの周辺情報を受け取る可能性がある。マイクには本人の発言だけでなく、近くにいる人の会話や生活音も入る。カメラには書類、顔、位置を推測できる情報、社内画面などが映り込むことがある。
さらに外部ツールを接続すれば、カレンダー、メール、顧客情報、予約履歴、取引記録なども処理対象になり得る。導入前には、少なくとも以下を明文化したい。
- 元の音声や動画フレームを保存するか
- 通信中と保存中のデータをどのように保護するか
- セッション終了後、記録をいつまで保持するか
- 入力データがモデル改善に利用される可能性があるか
- 利用者や管理者が確認できる監査ログは何か
- 接続するツールごとに必要最小限の権限を設定できるか
- 機密情報を検出したとき、送信や処理を止められるか
- データの削除や開示を求める手順が用意されているか
Googleは、自社のAI製品を通じて生成された音声に、人には聞き取りにくいSynthIDウォーターマークを埋め込むと説明している。これは生成音声の出所を確認する手がかりにはなるが、内容の正確性、著作権上の利用許可、適切な用途まで保証するものではない。人間の声と誤認され得る場面では、AI音声であることを利用者に知らせる表示も必要になる。
ベンチマークと実際の導入成果は分けて考える
Googleは、Live Extended Thinkingが音声品質、エージェント作業、音声推論に関する複数の評価で高い結果を示したと発表している。ただし、これはGoogleが提示した条件と評価セットに基づく結果であり、独立した検証結果ではない。
コールセンター、教室、車内、ゲームのボイスチャットなどには、それぞれ異なる雑音、通信状況、割り込み、例外処理がある。実環境では、単純な正答率だけでなく、次の指標も合わせて見るべきだ。
- 最初の音声が返るまでの時間
- 利用者が話を割り込ませたとき、すぐに応答を止められるか
- 外部ツールを含む作業全体が完了するまでの時間
- 間違った操作や重複操作が発生した割合
- 人が結果を修正しなければならなかった割合
- 通信切断や再接続から正常に復帰できるか
- 日本語の話し方や多言語の切り替えによる誤り
- 1件の作業を正常に完了するために必要なコスト
求めるバランスは用途によって変わる。ゲームキャラクターや簡単なナビゲーションでは即時性が重要になりやすい。一方、予約、購入、金融、医療に関わる案内では、多少会話が遅くなっても、確認と検証可能な完了を優先すべきだ。
どのような用途に向くのか
Gemini 3.8 Liveは、リアルタイムのカスタマーサポート、対話型の学習支援、ゲームキャラクター、通訳、車載機器やスマートグラスのインターフェースなど、会話を途切れさせずに進める必要がある用途と相性がよい。複数の条件を比較し、検索や外部ツールを順番に使う作業では、Live Extended Thinkingが候補になる。
反対に、一括で処理する音声の文字起こし、文書要約、厳密なJSON生成、長期間にわたるファイル検索などは、別のモデルや従来型の処理パイプラインのほうが単純で安定する場合がある。音声を使う機能だからといって、すべてをLive APIへ移す必要はない。
実用上の結論
Gemini 3.8 Liveの重要な点は、AIがより人間らしく話すことだけではない。利用者と会話しながら外部ツールを動かし、変更や割り込みを受け入れ、処理状態を伝えながら作業を完了できる設計にある。
導入を判断するときは、デモ音声の自然さだけで評価しないほうがよい。まず小さな対象業務を選び、中断、キャンセル、重複防止、最終確認、権限、ログ、失敗時の復旧を含めて試すべきだ。音声で「完了しました」と答えたかではなく、依頼された操作が実際に、正しく、安全に完了したかを確認できることが、実用的なエージェントの条件になる。
出典と利用について
- Google:Gemini 3.8 LiveとLive Extended Thinkingの公式発表
- Google Koreaによる韓国語の公式発表
- Gemini APIのモデル情報
- Gemini Live APIのSDK導入ガイド
- Live APIのバックグラウンド思考に関する資料
- Google DeepMindのモデルカード一覧
本稿は、一次出典であるGoogleの公式発表と、関連する開発者向け資料に記載された仕様、制限、提供方針を照合し、独自の構成と表現で解説したものです。公式の図表や製品画面、長い引用文は再掲していません。また、Googleが公表したベンチマーク結果を、あらゆる実環境で同じ成果が得られることの証明としては扱っていません。