GPT-6時代のプロンプトキャッシュ入門:コスト構造とキャッシュミスの落とし穴
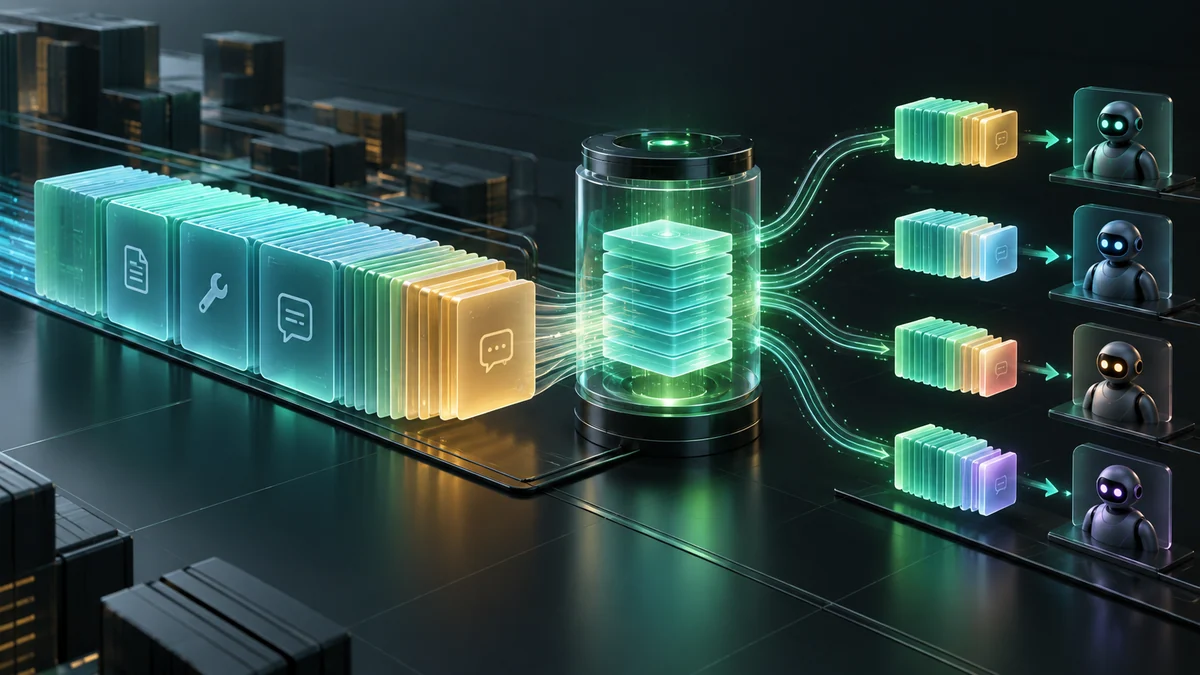
GPT-6時代のAIエージェントでは、料金表に掲載された入力トークン単価だけを見ても、実際の運用コストを正確には見積もれない。同じ量の入力を送るサービスでも、長い共通指示やツール定義を毎回計算し直す構成と、変わらない先頭部分をキャッシュして繰り返し使う構成では、請求額に大きな差が生じる可能性がある。
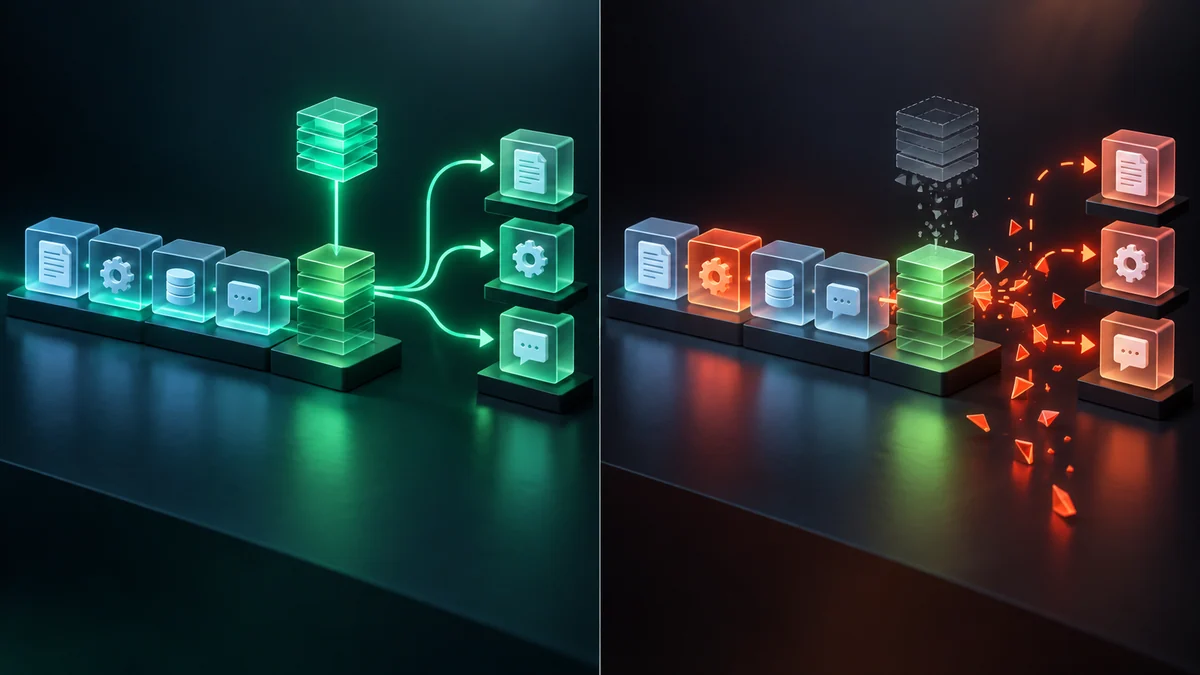
ただし、キャッシュを使えば必ず安くなるわけではない。一度しか使わない内容をキャッシュに書き込めば、通常入力より高い書き込み料金だけを負担することになる。また、プロンプトの早い位置にあるツール定義や設定を頻繁に変えると、その後ろに続く長い共通部分まで再利用できなくなることがある。
OpenAIが提供するPrompt Cache Diagnosticsは、こうした失敗を調べるための機能だ。単にキャッシュ済みトークン数を見るだけでなく、どこまで以前のリクエストと一致したのか、なぜキャッシュミスが起きたのかを確認できる。
要点
- GPT-5.6以降の対応モデルでは、キャッシュ書き込みが通常入力の1.25倍、読み出しが0.1倍として扱われる。
- 同じプレフィックスを完全な形で少なくとも一度再利用できれば、書き込みを含めてもキャッシュなしで2回処理するより安くなる。
- モデル、ツール一覧、出力スキーマ、推論設定、圧縮された会話履歴などの変更は、見た目が似たリクエストでもキャッシュミスを引き起こしうる。
- キャッシュヒット率だけでなく、出力、再試行、ツール利用、人による確認まで含めた「タスク完了1件あたりの総コスト」で評価する必要がある。
料金を倍率で整理する
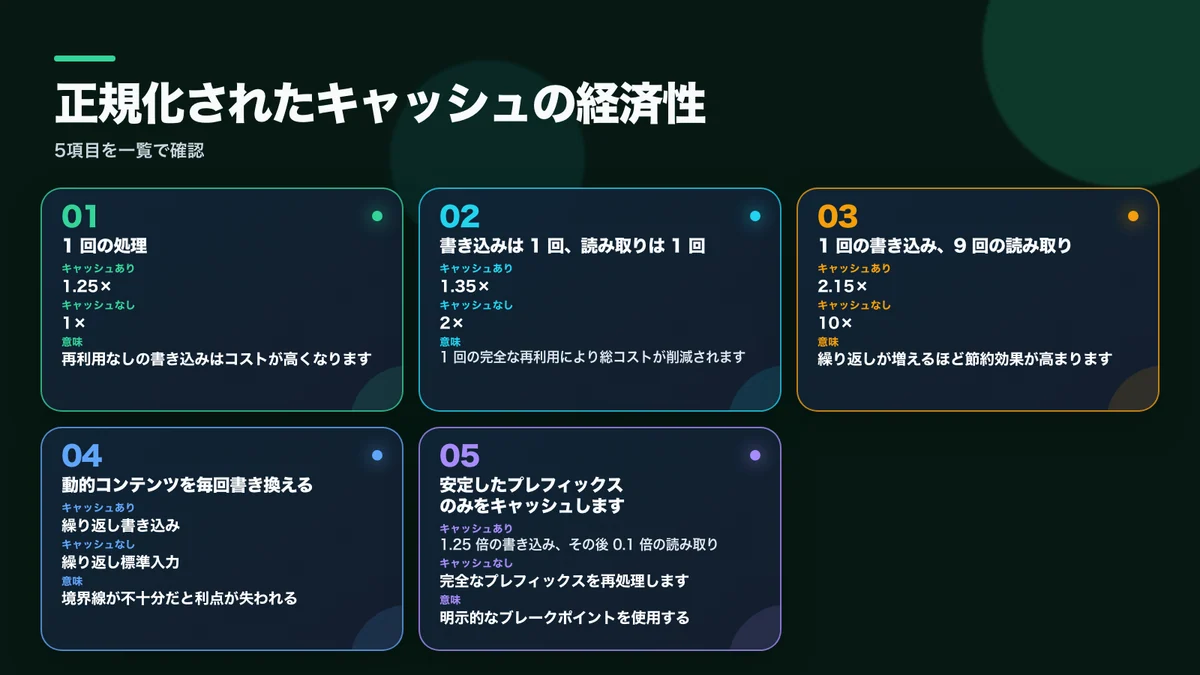
ここでいう倍率は、通常の未キャッシュ入力料金を「1」とした比較値であり、特定モデルのドル建て価格そのものではない。
同じプレフィックスを一度だけ処理するなら、通常入力は1倍、キャッシュ書き込みは1.25倍となる。再利用されなければ、キャッシュを意図的に作るほうが割高だ。
一方、1回書き込んだ内容を完全な形でもう一度読み出す場合、合計は「1.25+0.1」で1.35倍になる。キャッシュを使わず同じ部分を2回処理する場合は2倍なので、最初の完全な再利用が成立した時点で差が逆転する。
さらに、1回の書き込み後に9回読み出せれば、合計は2.15倍となる。キャッシュなしで10回処理する場合の10倍と比べると、再利用回数が多いワークロードほど効果が大きいことが分かる。
ただし、これはプレフィックス全体が一致する単純化した例だ。共有部分の後ろに追加される新しい質問やツール結果は別途処理され、一部しか一致しなければ節約できる範囲も小さくなる。実際の料金はモデル、処理サービスの区分、長いコンテキストに関する条件、出力やツールの料金によっても変わる。
プロンプトキャッシュが保存するもの
OpenAI Developersのプロンプトキャッシュ解説によると、キャッシュの対象はプロンプトの文字列そのものではなく、モデルが計算したキー・バリュー状態、いわゆるKVテンソルである。後続のリクエストで対象となる先頭部分が一致すれば、モデルは共有区間を最初から計算せず、保存済みの状態を再利用できる。
照合される範囲は、アプリケーションが「プロンプト」と呼んでいる文章だけではない。モデルが実際に受け取るレンダリング済みコンテキストには、OpenAI側の指示、ツールの名前・説明・スキーマ・並び順、開発者メッセージ、会話履歴、テキスト、画像、文書、対応する音声などが含まれる。
そのため、ユーザーに見える質問が前回と同じでも、ツールスキーマを少し変更すれば、その位置以降が一致しなくなる可能性がある。
GPT-5.6以降の対応モデルでは、キャッシュ可能なプレフィックスとして最低1,024トークンの見える入力が必要だ。OpenAIが内部で付加する非表示のシステム内容は、この最低トークン数には含まれない。
暗黙的キャッシュと明示的キャッシュ
暗黙的な方式では、OpenAIがキャッシュに適したメッセージの終端を判断し、ブレークポイントを自動的に配置する。たとえば、最新のユーザーメッセージや、連続するツール結果の最後などが候補になる。安定した会話履歴へ新しい内容を順番に足していく一般的なマルチターン処理では、導入しやすい方式だ。
明示的な方式では、開発者が選んだコンテンツブロックにprompt_cache_breakpointを配置する。明示的キャッシュ専用モードでブレークポイントを一つも指定しなければ、そのリクエストではキャッシュの利用も新しい書き込みも発生しない。
この仕組みを使えば、長い共通ポリシー、固定された製品資料、安定したツール定義までをキャッシュし、顧客ごとの設定や現在時刻のように変化しやすい情報を後ろへ分離できる。
1件のリクエストから作成できるキャッシュ書き込みは最大4件だ。更新頻度の異なる区間を分けるために複数の境界を置けるが、数を増やすだけで安くなるわけではない。それぞれの区間について、書き込み後に実際の再利用が見込めるかを確認する必要がある。
キャッシュミスにつながりやすい変更
モデルの変更
モデルが異なれば、重みやキャッシュの扱いも異なる。同じプロンプトを送ったとしても、あるモデルで作成したキャッシュを別のモデルが利用できるとは考えないほうがよい。
ツール一覧の変更
ツールの名前、説明、スキーマ、順序、並列呼び出しに関する設定は、モデルに渡されるプレフィックスを変える可能性がある。
特定のターンだけツールを使わせたくない場合、リクエストからツール一覧そのものを削除するより、一覧を安定させたままtool_choiceをnoneに設定するほうがキャッシュを維持しやすい場合がある。もっとも、アプリケーションの安全性や意図した挙動を優先することが前提となる。
出力形式と推論設定の変更
Structured Outputsのスキーマ、reasoning.effort、回答の詳細度などは、モデル側で構成される指示を変化させうる。対応するGPT-6の会話中に推論強度を変える場合、OpenAIの資料では、以前のリクエスト設定を書き換えるのではなく、後ろにconfiguration_updateを追加する方法が案内されている。
会話履歴の圧縮
コンテキスト管理機能によって過去の会話が圧縮された表現へ置き換わると、最初に変わったトークン以降は以前のキャッシュと一致しないことがある。圧縮はコンテキストの長さを抑えるうえで役立つが、キャッシュの再利用率とは別の観点で評価しなければならない。
先頭に置かれた動的な値
日時、ユーザーID、セッションごとの権限、現在の状態などを開発者メッセージの冒頭に入れると、その後ろにある共通資料まで毎回異なるプレフィックスとして扱われる可能性がある。
動かない指示を先にまとめ、変動する情報をブレークポイントの後ろへ置くのが基本となる。ただし、情報の順序を変えることで安全性やモデルの振る舞いに影響が出る場合は、キャッシュ効率より正確性を優先すべきだ。
Prompt Cache Diagnosticsで分かること
OpenAIは2026年9月8日、Responses APIでGPT-5.6以降の対応モデル向けPrompt Cache Diagnosticsを一般提供した。以前のレスポンスと現在のリクエストを比較し、再利用された範囲、選択されたブレークポイント、キャッシュミスの理由、問題を調べるための案内を確認できる。OpenAI APIの変更履歴
Prompt Caching Dashboardは、個別リクエストの診断とは役割が異なる。期間ごとのキャッシュヒット率、1回の書き込みに対する読み出し回数、キャッシュ読み出し・書き込み・通常入力トークンの構成を追跡するためのものだ。Diagnosticsが一件の不一致を調べる機能なら、ダッシュボードは本番環境全体の傾向を把握する機能と位置づけられる。
prompt_cache_keyの役割もモデル世代によって異なる。GPT-5.6より前のモデルでは、関連するリクエストを同じキャッシュへ振り分けるために安定したキーが重要だった。GPT-5.6以降はOpenAI側がルーティングを自動処理するため、最適化目的では必須ではない。
一方で、顧客・ユーザー・ワークスペースごとの利用量を区別したり、キャッシュヒットの挙動から別利用者の一致情報を推測される可能性を抑えたりする用途には使える。ただし、このキーだけで認可やテナント分離を実現できるわけではない。
日本の開発チームが確認したい設計手順
まず、リクエストを「安定している部分」「定期的に変わる部分」「毎回新しくなる部分」に分ける。共通の安全規則、固定された製品説明、変化しないツールスキーマは安定部分に置きやすい。顧客別ポリシー、日時、セッション状態は変化する部分であり、現在の質問や最新のツール結果は通常、最後に加わる。
次に、再利用回数を実測する。一度しか呼び出されない長文を意図的にキャッシュしても、書き込み料金を回収できない。多数のリクエストが同じ共通指示を使うサービスや、長い会話中にツール構成を維持するエージェントでは、キャッシュの価値が高くなりやすい。
そのうえで、次の項目を確認するとよい。
- 同じプレフィックスが何回読み出されているか
- どの変更点からキャッシュミスが発生しているか
- キャッシュ書き込みが再利用されないまま終わっていないか
- 出力トークン、再試行、ツールやコンテナの料金を含めても総コストが下がっているか
- 顧客別の指示や権限を移動したことで、回答品質や安全性が変化していないか
- 円建ての社内予算と照合する際、実際の請求額、為替、税、決済条件まで確認しているか
高いキャッシュヒット率は、システム全体が安価で信頼できることを意味しない。失敗した処理のやり直しや人による確認が増えれば、トークン料金が下がっても業務コストは上がる。
実用的な結論
GPT-6系のコスト最適化では、単価の安いモデルを探すだけでなく、再利用できるコンテキストを安定した形で設計することが重要になる。共通の指示やツールを前方にまとめ、頻繁に変わる情報を適切な境界より後ろへ置き、Diagnosticsで実際のミス原因を確認するという流れが基本だ。
プロンプトキャッシュは無料の割引機能ではない。最初に高めの書き込み料金を払い、その後の安い読み出しで回収する仕組みである。したがって、判断基準はキャッシュ済みトークンの割合ではなく、書き込み、読み出し、ミス、出力、再試行、ツール利用、レビューを含む「成功したタスク1件あたりの総コスト」であるべきだ。
また、キャッシュヒットのために重要な顧客別ルールを不適切な位置へ移動すると、モデルの挙動そのものが変わりかねない。コスト削減は、正確性、セキュリティ、権限管理、利用者ごとの分離を維持できる範囲で進める必要がある。
出典と利用について
OpenAI、GPTおよび関連する名称・商標は、それぞれの権利者に帰属する。本記事はOpenAIによる公式記事ではなく、同社の後援または承認を受けたものでもない。2026年9月26日時点で確認された公式資料の内容をもとに、独自の構成と文章で解説している。
対応モデル、機能、料金は変更される可能性があるため、本番環境へ導入する際は最新の公式資料を確認する必要がある。掲載画像は実際のプラットフォーム画面ではなく、説明を目的に制作された編集用イメージである。