GPT-6 Sol・Lunaを検証—低価格APIとベンチマーク、Xの初期反応
OpenAIは2026年9月22日、GPT-6 SolとGPT-6 Lunaを発表した。GPT-6 Astraが最も難しい一連の作業を担う上位モデルであるのに対し、Solは複雑なコーディングやエージェント型ワークフロー、Lunaは大量処理やコストを重視する用途に向けられている。
今回の焦点は、あらゆる評価で性能が飛躍したという単純な世代交代ではない。OpenAIは、Astra世代の能力をより低い単価で利用できるようにしたと説明している。実際、公式ベンチマークではSolがエージェントやコンピューター操作で好成績を示した。一方、Artificial Analysisの独立評価では、前世代と同程度の項目や、Lunaのコーディング、両モデルの知識労働で後退した項目も確認された。
したがって、確認できる変化は「すべての仕事が高品質になったこと」よりも、「一定の能力をより低い費用で使えるようになったこと」にある。
要点
- Solは複雑なコーディング、ツール利用、コンピューター操作、多段階のエージェント処理で、性能と費用の両立を狙うモデルだ。
- Lunaは分類、抽出、短い下書き、候補生成など、検証しやすい大量処理を低コストで行う用途に向く。
- 両モデルは105万トークンのコンテキストに対応するが、入力が27万2000トークンを超えると、超過分だけでなくリクエスト全体に割増料金が適用される。
- 導入判断ではトークン単価だけでなく、成功率、再試行、処理時間、人による確認まで含めた「完成結果1件当たりの費用」を見る必要がある。
Astra・Sol・Lunaはどう使い分けるのか
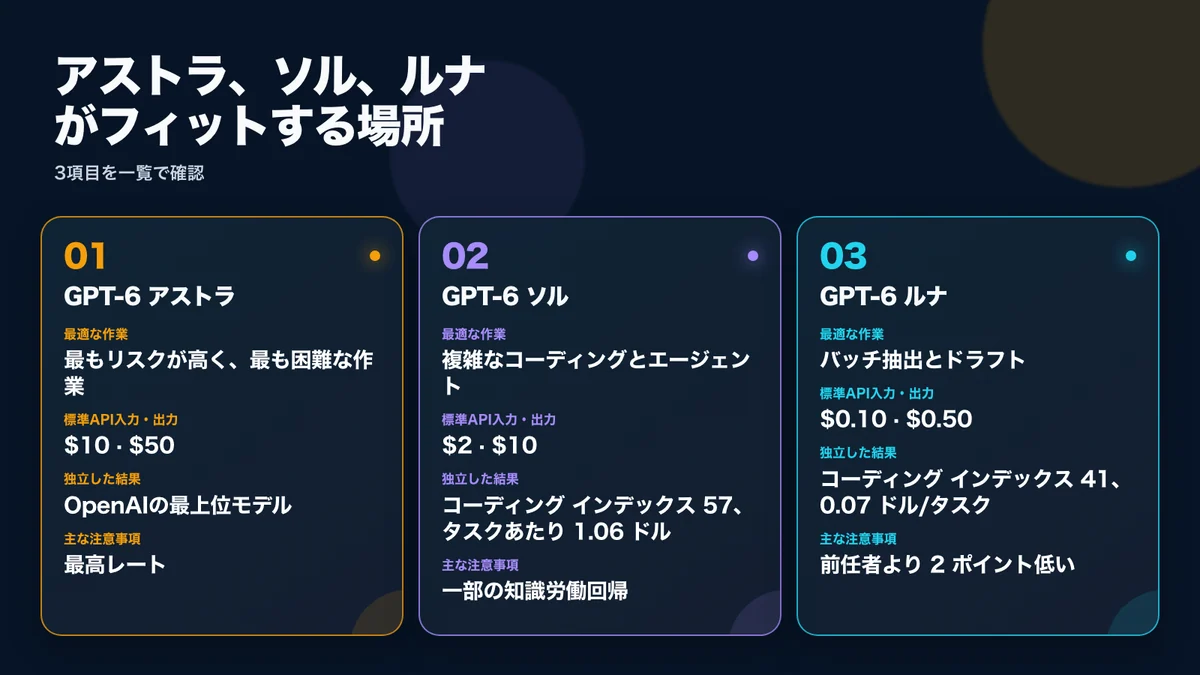
Astraは、失敗した場合の影響が大きく、利用可能な最高水準の推論能力を必要とする仕事に残る。Solはコーディングエージェント、複雑な調査、コンピューター操作、複数のツールを順番に呼び出す処理に適している。Lunaは、分類や情報抽出、短文の作成、大量の候補生成など、結果を自動的に検査しやすい作業が主な対象だ。
三つのモデルのどれか一つに統一するより、作業の難しさと失敗時のリスクで振り分けるほうが現実的だ。たとえばLunaで候補を生成し、明確なルールで検証する。不確かな案件だけをSolへ回し、重要な最終判断をAstraまたは人間が担当する構成が考えられる。
公式仕様—同じ長文対応でも料金差は大きい
GPT-6 Solの公式モデルページは、gpt-6-solを複雑なコーディングとエージェント型ワークフロー向けと説明している。推論強度はnone、low、medium、high、xhigh、maxに対応し、初期値はmedium。コンテキストは105万トークン、最大出力は12万8000トークン、知識の基準日は2026年4月20日とされる。
Standard APIの料金は100万トークン当たり、入力2ドル、キャッシュ済み入力0.20ドル、キャッシュ書き込み2.50ドル、出力10ドル。テキストと画像を入力でき、出力はテキストとなる。音声と動画は直接扱わない。
GPT-6 Lunaの公式モデルページでは、gpt-6-lunaを目的が明確な大量処理や費用重視の作業に向けたモデルとしている。推論強度の選択肢、105万トークンのコンテキスト、最大12万8000トークンの出力はSolと同じで、知識の基準日は2026年5月18日。100万トークン当たりの料金は、入力0.10ドル、キャッシュ済み入力0.01ドル、キャッシュ書き込み0.125ドル、出力0.50ドルだ。
両モデルはウェブ検索、ファイル検索、画像生成、Code Interpreter、hosted shell、apply patch、Skills、computer use、MCP、tool search、関数呼び出し、構造化出力に対応する。一方、ファインチューニングには対応しない。利用できるツールが同じでも、適切なツールの選択や失敗後の復旧まで同じ精度になるとは限らない。
27万2000トークンの境界に注意
105万トークンを入力できることと、その全量を基本料金で処理できることは別だ。入力が27万2000トークンを超えると、そのリクエスト全体について入力とキャッシュの料金が2倍、出力料金が1.5倍になる。境界を超えた部分だけに追加料金がかかる仕組みではない。
Solでは、入力単価が100万トークン当たり2ドルから4ドル、出力単価が10ドルから15ドル相当になる。Lunaにも同じ倍率が適用される。そのため、大量の文書を一度に渡す方法が、検索、段階的な要約、キャッシュの再利用より安いとは限らない。
地域処理は提供地域で10%の割増となる。BatchとFlexはStandardの50%、Fastは該当料金の2倍とされている。EUデータレジデンシーはStandard processingのみで利用できる。実際の費用計画では、モデル名だけでなく、処理方式、入力の長さ、キャッシュ利用率も確認したい。
OpenAIの公式ベンチマーク
OpenAIの発表記事では、エージェント処理とコンピューター操作に関する結果が強調されている。
- AutomationBenchではSol xhighが33.2%、1タスク当たり0.27ドル。OpenAIが掲載した比較では、Astra lowは30.3%でSolの3.9倍の費用、Claude Opus 5 maxは26.9%で11.1倍の費用だった。
- Agents’ Last ExamではSol maxが56.4%。OpenAIは、掲載されたClaude Opus 5の最高結果を上回り、1タスク当たりの費用は60%低いとしている。
- DeepSWE v1.1ではSol maxが68.8%、Luna maxが66.6%。同じ資料に掲載されたClaude Fable 5の最高値は69.9%だった。
- OSWorld 2.0 offlineではSol xhighが60.5%、Claude Opus 5 mediumが60.3%だった。
- OpenAI内部の事実性評価では、Solの誤りがGPT-5.6 Solのおよそ半分になったと報告された。
ただし、最後の評価は日常的な利用を代表する標本ではなく、誤りを誘発するよう選ばれた会話を対象としている。ストレステストとしては参考になるが、利用者全体の平均的な誤答率や、日本語でも同じ結果になることを示すものではない。他社モデルとの比較も、推論強度、使用ツール、制限時間、費用の算定方法がそろっているかを確認する必要がある。
独立評価が示したのは「低価格」と「ばらつき」
Artificial Analysisの独立評価も費用効率の改善を認めているが、能力全般が大きく伸びたとは結論づけていない。
Intelligence Indexの1タスク当たり費用は、Sol maxが1.06ドルで、GPT-5.6 Sol maxの1.99ドルから低下した。Luna maxは0.07ドルで、前世代の0.18ドルを下回った。1タスク当たりの出力はSolが2万9000から3万1000トークン、Lunaが4万1000から5万1000トークンへ増えている。回答を短くしたから安くなったのではなく、単価の引き下げが大きく影響したと読める。
Coding Agent IndexではSol maxが55点から57点へ上昇した一方、Luna maxは43点から41点へ低下した。SolはTerminal-Bench 4.0で37%から43%、SWE-Atlas-QnAで54%から58%へ改善。LunaはSWE-Atlas-QnAで49%から44%、DeepSWE v1.1で66%から64%へ下がった。
知識労働のGDPval-AA v2.1ではSolが約100 Elo、Lunaが約75 Elo低下し、AA-Briefcase v1.1ではLunaが約45 Elo下がった。Artificial Analysisは、一部の失敗について、推論能力だけでなく、要求された成果物や評価項目の欠落、表現品質が関係したと説明している。報告書やプレゼンテーションの作成では、形式の順守と項目の抜けを独立して検査する必要がある。
幻覚率の低下は正答率の上昇と同じではない
AA-Omniscienceでは、Solの幻覚率が92%から60%、Lunaは93%から77%へ低下した。しかしSolの回答試行率も99%から83%に下がり、正答率は59%から54%へ低下している。
つまりSolは、不明な問題に推測で答える代わりに、回答を控える傾向を強めた可能性がある。根拠のない回答が減ることには価値があるが、「誤った回答が減ること」と「正しい回答が増えること」は同義ではない。運用時には正答率だけでなく、回答保留、確信を伴う誤り、再試行、人による確認の割合をまとめて測定すべきだ。
Xの反応は発信者ごとに分けて読む
OpenAIの公式X投稿は、Astraの進歩を高速で安価なSolとLunaへ展開し、GPT-5.6のプロモーション料金に比べてトークン単価を50%引き下げたと説明した。これは製品の位置づけと料金に関する一次情報だが、独立した品質検証ではない。
Sam Altmanの投稿は、知能、アラインメント、業務成果物、コーディング、コンピューター操作の改善と、トークン単価およびタスク単価の低下を強調している。会社経営者による発表時の主張であり、実務費用は再試行や確認作業を含めて検証する必要がある。
Tibo Sottiauxの投稿は、高性能モデルの能力を効率化し、利用しやすくする開発方針を説明した。OpenAI社員による戦略解説であり、外部利用者の独立レビューではない。
これに対し、Artificial AnalysisのX投稿は、費用効率は改善したものの、総合的な知能・コーディング指標はGPT-5.6系とおおむね同水準で、評価項目によって改善と後退が混在したとまとめている。
Perplexity CEOのAravind Srinivasによる投稿は、同社のWANDR評価でSolがOpus 5に対して5分の1の価格だったと述べた。SolをLight effort、AstraをHigh effortのオーケストレーターとして使う説明は具体的な運用例だが、WANDRはPerplexity独自の評価であり、一般的な独立ベンチマークとして扱うことはできない。
発売直後の個人による感想には、Lunaを高く評価する声と、Solの品質は期待ほどではないものの価格が弱点を補うという見方の両方があった。ただし、プロンプト、推論強度、利用ツール、アカウント条件が示されていない短い投稿は、再検証すべき論点を見つける材料にとどまる。
日本の利用者が導入前に確認したいこと
発表時点でSolとLunaはChatGPT Work、Codex、APIで提供される。Plus、Pro、Business、Enterprise、Eduの利用者はWorkとCodexからアクセスでき、FreeとGoの利用者はデスクトップアプリでLunaを利用できる。一般のChatにはまだ提供されておらず、段階的な展開のためアカウントごとに利用開始時期が異なる場合がある。
ChatGPTのサブスクリプションとAPI料金は別扱いだ。PlusやProを契約してもAPIトークンが含まれるわけではなく、Codexの利用枠もAPIの料金表だけでは算定できない。
また、英語中心のベンチマークから日本語での品質をそのまま判断することはできない。敬語、固有名詞、和英混在の文書、長文からの項目抽出、指定された書式の順守など、実際に扱う日本語データで試す必要がある。特にLunaを大量処理へ使う場合は、自動検査と標本確認を組み合わせ、見逃し率を把握してから処理量を増やしたい。
実用的な結論—どのモデルを選ぶべきか
- Astra: 失敗の影響が大きく、長期的な計画や複合的な意思決定で最高水準の能力を優先する作業
- Sol: 複雑なコーディング、ツール操作、コンピューター利用、多段階の調査で、品質と費用のバランスを取りたい作業
- Luna: 分類、抽出、短い下書き、候補生成など、大量に処理しながら結果を自動検証できる作業
GPT-6 SolとLunaは、Astraを一律に置き換えるモデルではない。同じ世代の能力を、難易度、速度、費用、失敗リスクに応じて振り分けるための選択肢だ。
比較すべきなのは表示されたトークン単価だけではなく、完成した成果物1件にかかる総費用である。モデルの呼び出し、失敗した実行、再試行、人による確認、待ち時間まで含めると、単価の安いモデルが結果的に高くなる場合もある。反対に、検証を自動化できる大量処理では、Lunaの低価格が大きな効果を持つ可能性がある。
現時点で最も堅実なのは、全業務を一度に移行することではない。実際のデータで小規模に評価し、処理のリスクと複雑さに応じてLuna、Sol、Astra、人間の確認へ振り分ける方法だ。
出典と利用について
- OpenAI, GPT-6 Sol and Luna発表記事
- OpenAI, GPT-6 Solモデル文書
- OpenAI, GPT-6 Lunaモデル文書
- OpenAI, モデルカタログ
- Artificial Analysis, GPT-6 Sol・Luna独立評価
- OpenAIの公式X投稿
- Sam AltmanのX投稿
- Tibo SottiauxのX投稿
- Artificial AnalysisのX投稿
- Aravind SrinivasのPerplexityに関するX投稿
OpenAI、ChatGPT、GPT、Codexおよび関連する商標は、それぞれの権利者に帰属する。本記事はOpenAIの提供、後援、承認を受けた公式コンテンツではない。公式仕様と提供元によるベンチマーク、Artificial Analysisの独立測定、企業関係者の説明、確認条件が限定された初期反応を区別し、資料の内容を日本語向けに再構成した。公式チャート、製品画面、Xのスクリーンショット、第三者の写真は転載していない。