JEVをCodexにつなぐ方法:GPTを置き換えず、判断だけを構造化する
はじめに
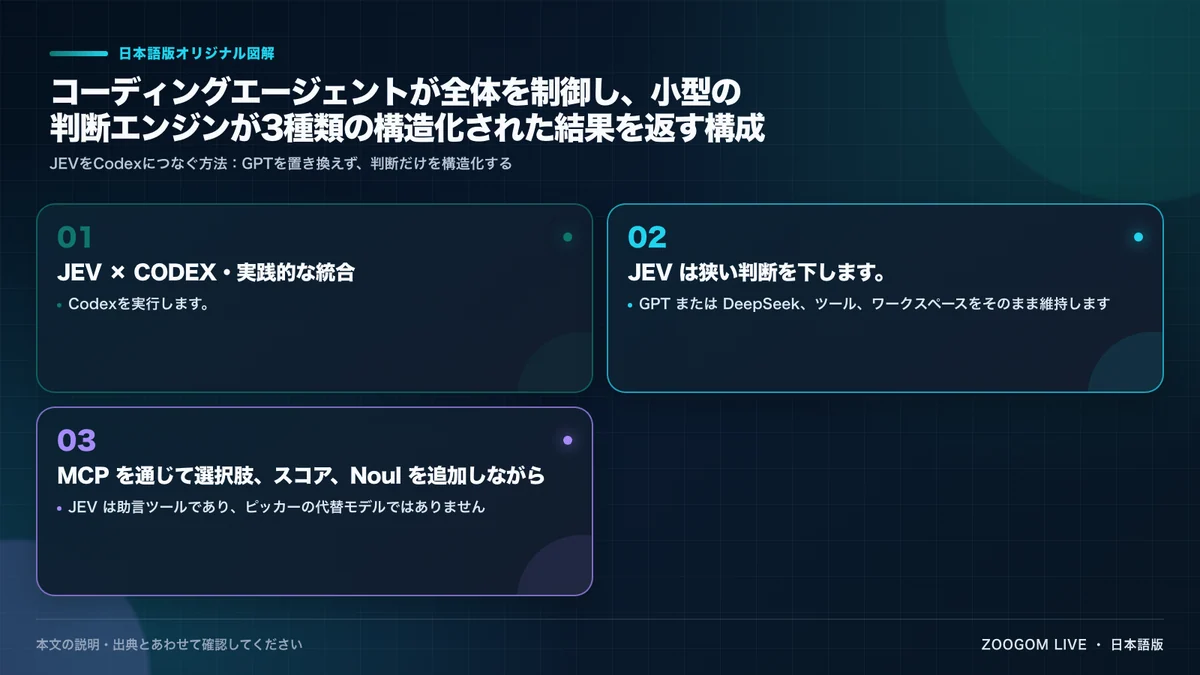
Codexは、コードやファイルを読み書きし、ターミナルや外部ツールを扱いながら、利用者が指定した目的に向けて作業を進めるコーディングエージェントだ。一方、TypeSafe AIのJEVは、文章やコードを自由に生成するためのモデルではない。与えられた状態を評価し、あらかじめ定義された選択肢、段階的なスコア、または「はい」である確率を返すことに役割を絞っている。
両者を接続しても、Codexの基盤モデルがJEVへ切り替わるわけではない。TypeSafe AIのコーディングエージェント向け説明では、JEVはCodexなどで使われる基盤LLMの代替ではなく、コード生成、会話、ツール呼び出しも担当しないと説明されている。
つまり、現実的な構成は「Codexが情報を集めて作業を進め、判断範囲を明確に限定できる場面だけJEVへ問い合わせる」というものだ。JEVが返す確率は参考材料にはなるが、デプロイや削除、権限変更を実行してよいという許可にはならない。
要点
- JEVを接続しても、CodexのGPTやDeepSeek、会話、ファイル、ツール環境はそのまま維持される。
- TypeSafe AIの公式エージェントスキルはAPIの使い方を伝える知識層であり、実際の呼び出しにはアプリケーションまたはMCPサーバーが必要になる。
- Choice・Score・Noulは分類やリスク評価に向くが、計算、日付比較、自由文生成、高影響な処理の承認には使うべきではない。
JEVが返す3種類の判断
TypeSafe AIの概要では、JEVは同社初のSystem Oneモデルと位置付けられている。一般的な大規模言語モデルのように長い文章を返すのではなく、共通のstateに対して名前付きの質問を評価し、プログラムで扱いやすい形式の値を返す。
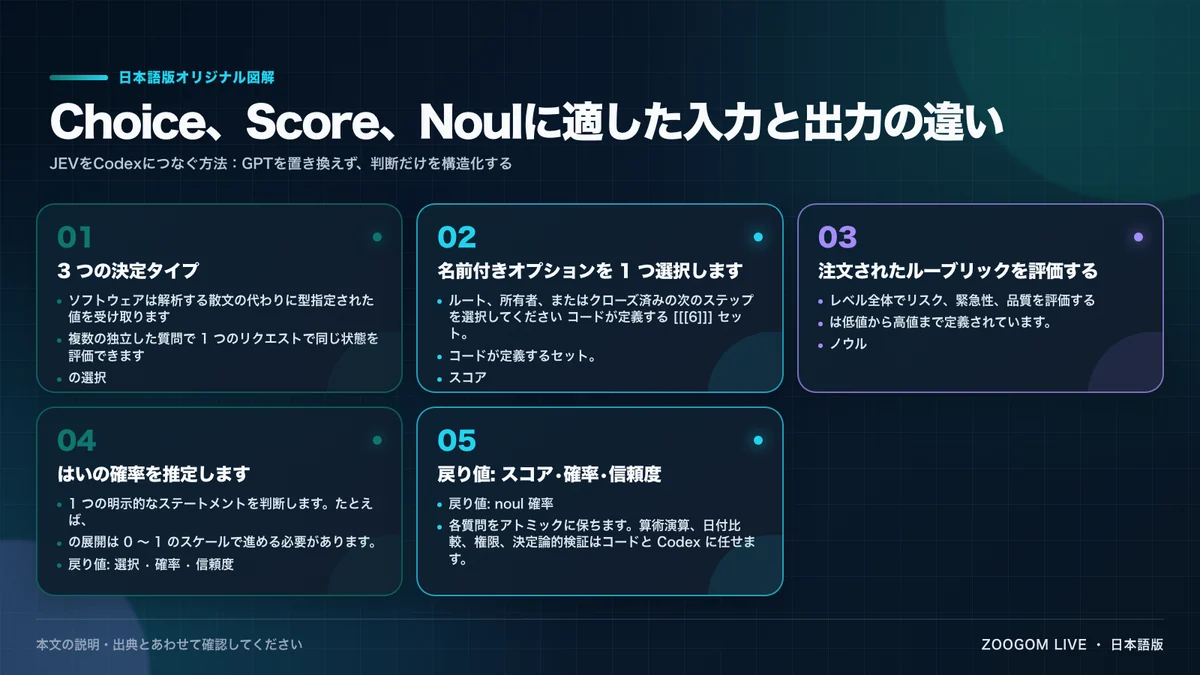
利用できる判断形式は次の3つだ。
Choiceは、アプリケーション側が提示した候補から1つを選ぶ。Scoreは、「低い・中程度・高い・非常に高い」など、順序のある尺度から1段階を選ぶ。Noulは、ある命題が正しいと考えられる確率を0から1までの値で返す。
1回のリクエストで複数の質問を評価できるが、それぞれは独立した判断に分ける必要がある。「次に何をするか」「リスクは何段階か」「今すぐデプロイ可能か」を別々に質問し、組み合わせ方はアプリケーション側で管理するのが基本となる。
CodexとJEVの役割を分離する
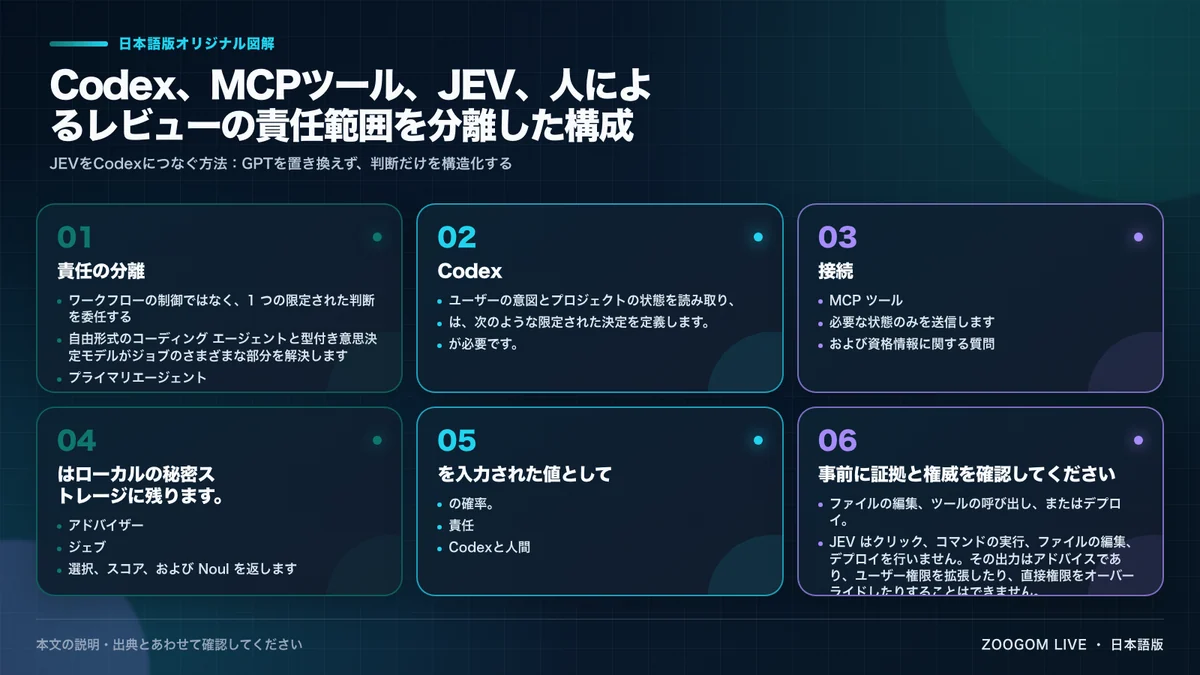
基本的な処理の流れは次のようになる。
- 利用者がCodexへ作業を依頼する。
- Codexがリポジトリ、テスト結果、運用条件などを確認する。
- 限定された判断が必要になった時点で、必要な情報だけをMCPツールへ渡す。
- MCPサーバーがJEV APIを呼び出し、構造化された回答を受け取る。
- Codexが回答をテストログや変更内容などの直接的な証拠と照合する。
- ファイル編集、コマンド実行、デプロイなどはCodexと利用者が別途判断する。
JEV自身は画面をクリックせず、シェルコマンドも実行せず、ファイルや外部システムを変更しない。この分離により、確率的な回答がそのまま取り返しのつかない操作へ直結するのを防ぎやすくなる。
接続方法は2通り
公式エージェントスキルを利用する
TypeSafe AIは、コーディングエージェントに質問形式やAPIの利用パターンを伝える公式エージェントスキルを公開している。資料に示された一般的な導入コマンドはnpx skills add typesafe-ai/skills --skill typesafe-aiだ。
このスキルは、CodexがJEV用のクライアントコードや評価処理を書く際のガイドになる。ただし、スキルを追加しただけで会話内にJEVの呼び出しツールが現れるわけではない。実際のネットワーク通信は、製品側のコードか独立した接続層が担当する。
MCPサーバーを用意する
Codexの会話中にJEVへ直接問い合わせるには、呼び出し可能なMCPサーバーが必要になる。資料の検証環境では、ローカルのstdioプロセスとして動く非公式のJEV Decision Helperが使われ、機能は次の2つに限定されていた。
statusは、API認証情報が設定されているかだけを確認し、値の表示や課金対象のリクエストは行わない。decideは、stateとChoice・Score・Noulの質問形式を検証してからJEVへ送る。
これはTypeSafe AIが配布する公式Codex用MCPプラグインではなく、公開APIを利用する独立した接続実装だ。採用する組織はラッパーコードを自ら確認・保守するか、監査可能な実装を選ぶ必要がある。
OpenAIのプラグイン資料では、CodexプラグインにスキルやMCP設定を含められると説明されている。認証情報をプラグインのファイルや配布物へ埋め込まず、MCPプロセスには必要最小限の環境変数だけを渡す設計が重要だ。
APIへ渡す情報
TypeSafe AIのAPI資料によると、JEVはPOST https://api.typesafe.ai/v1/systemoneをBearer認証付きで呼び出す。主な入力は、利用するモデル、判断に必要な事実をまとめたstate、独立した質問を収めるquestionsの3要素だ。
開発中に安定版を追随するならjev-latestを利用できる。一方、評価済みの応答傾向やしきい値に基づく本番運用では、モデルのバージョンを固定する方が再現性を保ちやすい。
stateには会話履歴やリポジトリ全体を無条件で入れず、判断に直接関係する事実だけを渡す。Choiceの候補やScoreの尺度も接続層で検証し、返された文字列をそのままコマンド、ファイルパス、外部操作として実行してはならない。
Choice・Score・Noulの使い分け
Choice
担当チームへの振り分けや、「修正して再テスト」「追加の証拠を集める」「人のレビューへ回す」といった閉じた候補から次の経路を選ぶ場合に向く。回答には選択結果、候補ごとの確率分布、独立したconfidenceが含まれる。
Score
リスク、緊急度、レビュー優先度など、順序を持つ基準の評価に適している。ここで使う数字は計算結果ではなく、事前に決めた段階のラベルだ。請求額の合計、正確な件数、日付の差などは、決定的なコードで計算してから必要な結果だけをstateへ渡す。
Noul
「この変更は今すぐデプロイできる」のように、1つの命題が正しい確率を求めるときに使う。結果は0から1までの値で、ChoiceやScoreのような独立したconfidenceは付かない。Choice内の候補確率とNoulの値は質問構造が異なるため、同じ指標として単純に合算できない。
接続試験で得られた結果
資料の接続試験では、パスワード、APIキー、顧客情報を送らず、次の合成された状態だけをJEVへ渡している。
- ログインセッション用ミドルウェアとデータベース移行処理に変更がある。
- 自動テストは42件通過している。
- セキュリティ統合テストは1件失敗している。
- ロールバック計画は用意されている。
- デプロイはまだ始まっていない。
jev-latestが指していたJEV 1.13.0は、次の処理として「修正して再テスト」を98%の候補確率、confidence 0.97で選んだ。リスク評価は4段階中の「2=高い」で、その段階の確率は100%、confidenceは1.0だった。「直ちにデプロイできる」という命題に対するNoulは0.03だった。
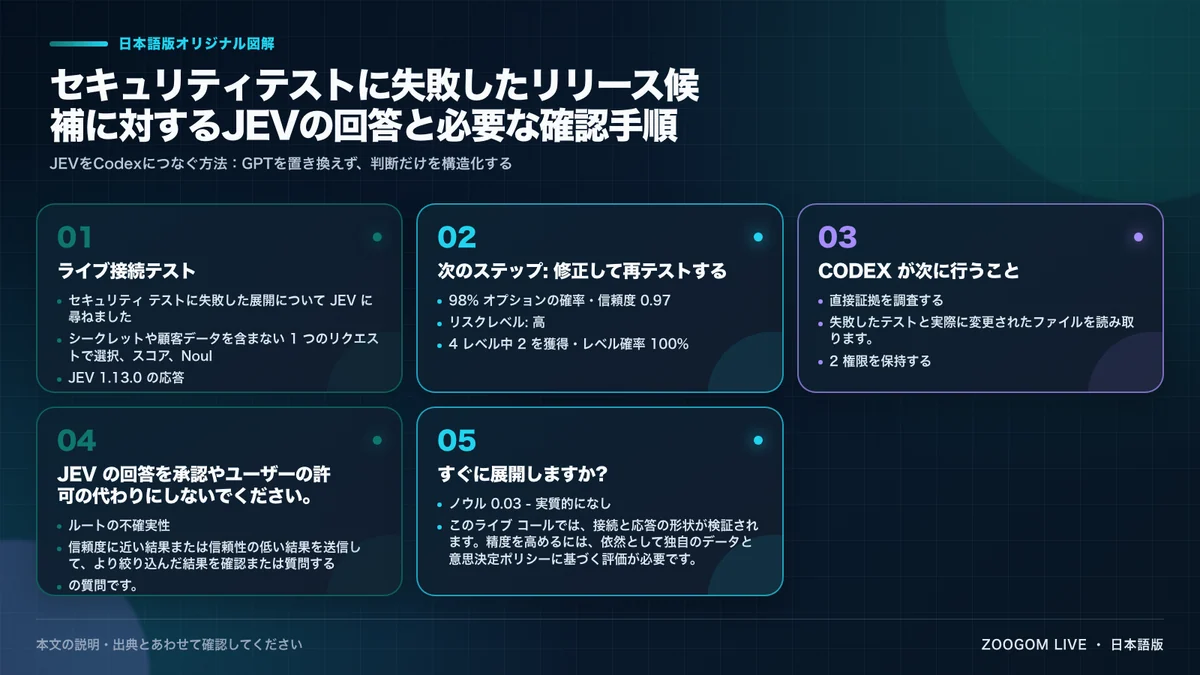
もっとも、この1件だけで精度を評価することはできない。確認できるのは、接続、入力スキーマ、応答形式が機能したことまでだ。本番導入には、実際の業務を代表する正解付きデータを用意し、誤検知、見逃し、分類ごとの偏り、しきい値の安定性を検証する必要がある。
日本語運用とセキュリティ上の注意
モデル資料では英語が主な学習言語とされている。日本語で使う場合も、社内用語、製品名、敬語を含む問い合わせなど、実際の業務データに近い評価セットを用意する必要がある。英語以外の入力が直ちに使えないという意味ではないが、英語で得た評価結果を日本語環境へそのまま当てはめることはできない。
APIキーはソースコード、.mcp.json、ログ、Gitリポジトリへ保存しない。外部サービスへ送るstateから、不要な会話履歴、パスワード、トークン、顧客の原文を除外することも重要だ。タイムアウト、スキーマ違反、レート制限が起きた場合は、安全側で処理を停止させる。
confidenceの利用ガイドは、高confidenceを自動処理、中間域を追加確認、低confidenceを人のレビューへ振り分ける考え方を示している。ただし、共通の万能なしきい値は示されていない。文書タグの付与と本番デプロイでは、誤判断の影響が大きく異なるためだ。
また、JEV 1.13の既知の限界には、文字どおりに解釈しやすい傾向、無関係な情報を大量に含むstateによる性能低下、指示と評価基準の衝突、敵対的な入力やプロンプトインジェクションの影響が挙げられている。画像、音声、動画を直接判定するモデルでもない。
モデル、コンテキスト、料金
TypeSafe AIのモデル情報によると、2026年9月27日時点の安定版はjev-1.13.0で、jev-latestは同バージョンを指している。リクエスト全体のコンテキスト上限は64K、stateと最長の単一質問を合わせた上限は32Kで、入力はテキストに限られる。
入力料金は10億トークン当たり42ドル、すなわち100万トークン当たり0.042ドルで、出力トークンは無料とされている。単価が低くても、不要なデータまで送る理由にはならない。入力が大きくなるほど関連性を保ちにくくなり、プライバシーや障害調査の負担も増える。公開される制限は変更される可能性があるため、直接HTTPクライアントを実装する場合は429や529への指数バックオフも必要になる。
実用的な結論
JEVとCodexは競合するモデルではなく、役割の異なる組み合わせだ。Codexは目的の理解、証拠の確認、コードやツールの操作を担当し、JEVはChoice・Score・Noulによる限定的な判断を返す。
導入時は、いきなり自動デプロイへ結び付けるのではなく、担当先へのルーティング、レビューが必要かどうかの分類、次に集める証拠の選択など、やり直しやすい用途から始めるのが現実的だ。質問を1つずつ分離し、stateを最小化し、モデルと質問のバージョンを記録する。さらに、自社の日本語データで確率としきい値を評価し、デプロイ、削除、権限変更、外部送信には直接的な検証と人の承認を残すべきだ。
JEVの回答は「参考にできる確率」であって「実行してよいという権限」ではない。この境界を明示することが、Codexとの連携を安全に運用するための中心となる。
出典と利用について
本稿は、一次出典であるTypeSafe AIの公開資料と、OpenAI Developersの関連資料を参照し、日本語読者向けに構成と表現を改めた独立編集記事です。JEVおよびTypeSafeの名称はTypeSafe AIに、Codex、GPTおよび関連名称はOpenAIその他の権利者に帰属します。本稿は各社による後援、承認、提携を示すものではありません。
- TypeSafe AI:JEVの概要と判断形式
- TypeSafe AI:コーディングエージェントにおけるJEVの役割
- TypeSafe AI:APIと応答形式
- TypeSafe AI:モデル、コンテキスト、料金
- TypeSafe AI:confidenceの利用方法
- TypeSafe AI:JEV 1.13の既知の限界
- TypeSafe AI:公式エージェントスキル
- OpenAI Developers:Codexプラグインの構成
- OpenAI Developers:Docs MCP