OpenAI「Bel」10兆パラメータ説を検証――GPT-7・AGIの噂と確認済み情報
OpenAIが「Bel」というコードネームの次世代AIモデルを開発している――。そんな情報がXやReddit、AI関連サイトで広がっている。なかでも注目を集めたのは、「総パラメータ数が10兆を超える」「社内モデルDougの後継」「GPT-7の基盤になる」「AGIの水準に近づく」といった主張だ。
しかし、2026年9月25日時点でOpenAIはBelを発表していない。OpenAIの公式モデルカタログにも掲載されておらず、製品発表、システムカード、公開済みの研究資料にも、その名称を確認できない。
情報の流れをさかのぼると、中心的な主張はひとつの匿名性の高いXアカウントに行き着く。その後の投稿の多くは、別々の情報源による裏付けではなく、最初の内容を言い換えたり、より強い表現へ膨らませたりしたものだ。本稿では、確認済みの公式情報と、未確認の主張、そこから派生した推測を分けて整理する。
要点
- Belの存在、事前学習の完了、10兆を超える総パラメータ数は、現時点ではひとつのX投稿に由来する未確認情報である。
- OpenAIがAstraより高性能な社内モデルを数学研究に使ったことは公式に公表されているが、そのモデルがBelだとは説明されていない。
- 発端となった投稿にGPT-7という名称やDevDayでの発表予定はなく、いずれも拡散の過程で加わった推測である。
Belをめぐる主張の証拠レベル
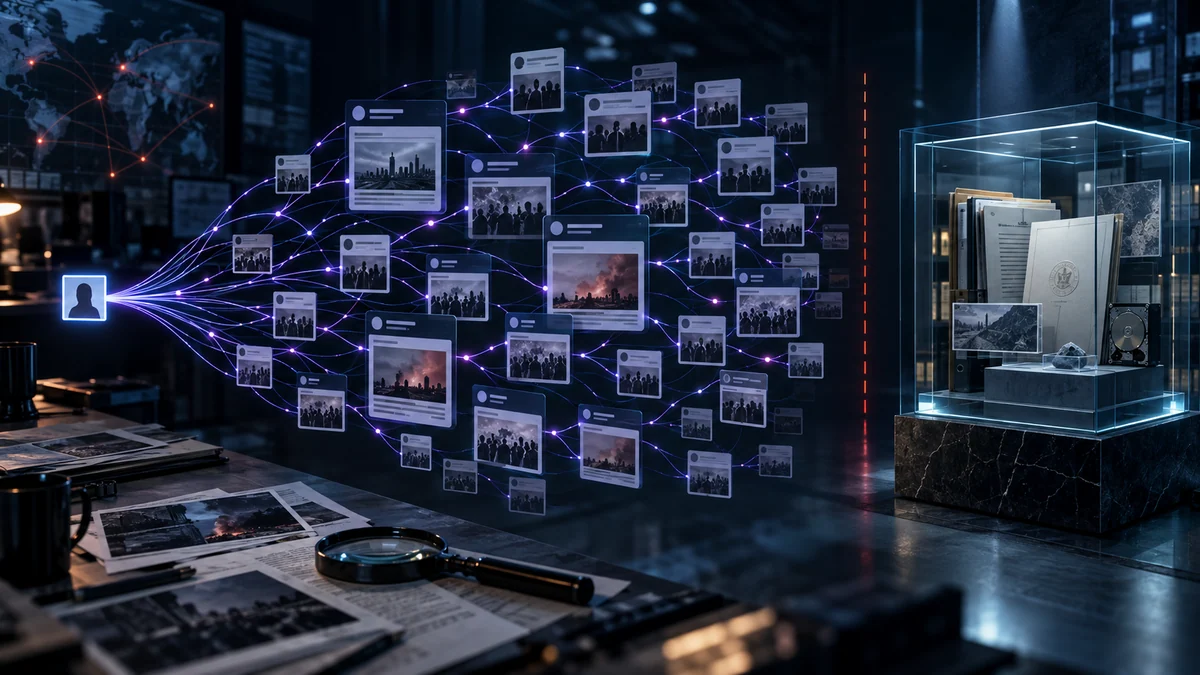
現時点で確認できる情報は、次のように区別する必要がある。
- 公式に確認済み:OpenAIは公開中のAstraより大幅に高性能な社内モデルを、一部の数学研究に使用した。
- 未確認の主張:その社内モデルまたは別の事前学習モデルがBelと呼ばれ、総パラメータ数が10兆を超える。
- 拡散後に加わった推測:BelはGPT-7であり、AGIに相当し、DevDayで発表される。
- 現時点で存在しない裏付け:Belという名称を記したOpenAIのモデルカード、API資料、研究論文、製品発表。
複数の投稿で同じ内容を見かけても、情報源が同一なら独立した証拠が増えたことにはならない。
発端となったX投稿が主張したこと
8月25日、Xアカウントの@synthwaveddは、OpenAIがBelというコードネームで次の事前学習を完了したと投稿した。BelはDougと呼ばれる社内モデルの後継であり、Dougは追加の強化学習を経てAstraやGPT-6の基盤になる、という系譜も示している。
同じ投稿は、Belについて「総パラメータ数が10兆を超える」「GPT-4.5に近い規模」「GPT-6より後の世代、あるいはAGIの境界に位置するシステムの基盤になり得る」と主張した。
ただし、投稿には第三者が検証できる資料が添えられていない。モデルカード、学習記録、コード、データセンターの記録、情報提供者の所属やアクセス範囲、独立した取材による確認はいずれも示されていない。
したがって、この投稿から確実に言えるのは、「Belという名称と10兆パラメータ説が公に発信された」という点までだ。OpenAIが実際にBelを学習したことや、事前学習を完了したことまでは確認できない。
投稿数の多さは情報源の多さではない
翌日、@Adidotdevは、OpenAIがAstraに続くモデルをすでに完成させたという趣旨で情報を紹介した。しかし、別の出典を示す投稿では、情報源として@synthwaveddを挙げている。これは二つ目の独立したリークではなく、最初の主張を再発信したものだ。
@kimmonismusの投稿も、Belやパラメータ規模、競合企業の計算資源に関する話を取り上げているが、出典は同じアカウントである。yumeacademyの投稿では、さらに劇的な表現や追加の規模推定が登場するものの、それを支えるOpenAIの資料は示されていない。
検索結果にX投稿、Redditのスレッド、ブログ記事が並ぶと、多数の関係者が同じ情報を確認したように見える。だが引用関係をたどってすべてが一件の投稿に戻るなら、根本の情報源は依然としてひとつである。
最初の投稿はBelをGPT-7と呼んでいない
BelをGPT-7と同一視する見出しも広がっているが、発端となった投稿に「GPT-7」という製品名はない。記されていたのは、BelがGPT-6より後のモデルの基盤になる可能性がある、という投稿者の見方だった。
研究上のコードネーム、事前学習を終えたチェックポイント、一般公開される製品は、一対一で対応するとは限らない。ひとつの基盤モデルから複数の製品が作られる場合もあれば、強化学習、安全性調整、提供環境の制約によって名称や用途が変わる可能性もある。研究段階のモデルが製品化されないケースも考えられる。
仮にBelが実在していたとしても、それだけでGPT-7という正式名称や、ChatGPT・APIでの近日公開が確定するわけではない。
「総パラメータ数10兆」が意味するもの
元の投稿は10T+ total parametersと表現している。これは学習に使ったトークンが10兆個という意味ではなく、モデルを構成する総パラメータ数が10兆を超えるという主張だ。
もっとも、総パラメータ数だけでは、ひとつの回答を生成するときに必要な計算量は分からない。Mixture of Expertsのような構造なら、トークンごとに全体の一部だけを有効化することがある。一方、密な構造のモデルでは、より多くの重みを毎回の処理に使う可能性がある。
有効パラメータ数、専門家モデルの数とルーティング方法、数値精度、学習データ、学習計算量、コンテキスト長、提供用インフラが不明なままでは、10兆という数字を応答速度、利用料金、能力へ直接置き換えることはできない。
また、OpenAIはGPT-4.5の正確なパラメータ数を公式には公表していない。このため、「GPT-4.5と同程度の規模」という比較にも、外部から照合できる基準値がない。
パラメータ数だけでAGIとは判断できない
AGIには、単一の標準化された判定基準があるわけではない。複数のベンチマークで高得点を記録しても、長期的な計画、新しい状況への適応、事実性、自律的なエラー回復、安全性、実際の運用コストは別に評価する必要がある。
総パラメータ数からは、少なくとも次の点を判断できない。
- リクエストごとに有効になる計算量と応答時間
- 学習データの品質、範囲、重複、評価データの混入
- 強化学習や安全性調整後に維持される能力
- ブラウザー、コード実行、外部ツール、複数エージェントを使う作業の成功率
- 誤答、再試行、回答保留、人による確認まで含めた実質的なコスト
仮に10兆という数字が後日確認されても、それだけでAGIへの到達、GPT-7という名称、間近の公開、あらゆる評価での優位性を証明することにはならない。
OpenAIの公式資料で確認できる範囲
OpenAIの公式モデルカタログには、GPT-6 Astra、GPT-6 Sol、GPT-6 Lunaなどの公開モデルが掲載されているが、Belはない。カタログにないことだけで、非公開の研究モデルが存在しないとは断定できない。ただし、利用者が現在APIで選択できる公式モデルとしてBelが案内されていないことは確認できる。
GPT-6 Astraの公式発表では、Astraが事前学習、強化学習、アラインメント研究を通じて開発されたと説明されている。しかし、DougからAstra、さらにBelへ続くとされる社内系譜は掲載されていない。
つまり、「Belという未確認のコードネームに関する噂がある」という表現は証拠に沿っているが、「OpenAIのGPT-7であるBelが完成した」と断定するのは、公開情報の範囲を超えている。
Astraより強力な数学モデルはBelなのか
OpenAIは9月8日のNavier–Stokes方程式に関する研究報告で、GPT-6 Astraより大幅に高性能な社内モデルを使用したと公表した。
資料によると、8月28日から事前学習済みモデルに大規模な強化学習を行い、約1万のエージェントを同時稼働させた。解決までに88時間、約270万件のメッセージ、約1300億の出力トークンを使い、その後、AstraによるLean検証にさらに17時間を費やしたとされる。
これは、OpenAIが少なくとも特定の研究用途で、公開中のAstraを上回る社内システムを運用していることを示す公式情報だ。強化学習の開始が、Bel投稿の3日後だったことも、両者を結び付ける推測が生まれた理由のひとつだろう。
しかし、日付が近いことはモデルの同一性を証明しない。公式資料が使っている表現は「事前学習済みモデル」であり、Bel、Doug、10兆パラメータ、GPT-7のいずれも記されていない。複数の社内チェックポイントが並行して存在する可能性もあるため、「BelがNavier–Stokes問題を解決した」とするのは証拠を越えた解釈になる。
一方、OpenAIが8月1日に公開した数学・理論計算機科学における10の進展では、使用したシステムをAstraの社内版と明記している。名称を確認できる資料と、名称を明かしていない資料は分けて扱う必要がある。
roonの投稿にBelへの言及はない
OpenAIの研究者として知られるroonは、重要な問題の解決策を研究所が長期間抱え込むべきではなく、1〜2カ月ほどでほかの組織も似た能力に到達し得る、という趣旨を投稿した。一部のReddit投稿やコメントは、これをBel級の能力や次世代モデル公開の手掛かりとして解釈した。
しかし、元の投稿にはBel、GPT-7、パラメータ数、公開日の記載がない。研究の進展を示す一般的なシグナルとして読む余地はあっても、OpenAIの関係者がBelを確認した証拠にはならない。
DevDayで発表される可能性は確認されていない
OpenAI DevDay 2026の公式案内によると、イベントは9月29日に開催される。大規模な開発者向けイベントを前に、新モデルやAPIに関する予想が出ること自体は不自然ではない。
ただし、公式案内にBelの記載はない。DevDayの開催が確定していることと、Belがそこで発表されることは別の主張である。仮に事前学習が終了していたとしても、強化学習、安全性評価、提供環境の最適化、製品設計、価格設定には追加の工程があり得る。
実用的な結論――日本の利用者が確認すべきこと
現時点では、Belを実在する公開製品として比較・購入判断の対象にする段階ではない。今後、正式発表があった場合は、巨大なパラメータ数より先に次の点を確認するのが実用的だ。
- OpenAIの公式モデルカタログやシステムカードに名称が掲載されたか
- ChatGPTのプランに含まれるのか、CodexやAPIで利用できるのか
- 日本のアカウントへ提供される時期と利用条件
- APIのモデル識別子、料金、レート制限、長いコンテキストの扱い
- データの保存、処理地域、法人向けセキュリティ条件
- 日本語での指示理解、長文の抜け、固有名詞、敬語、和英混在文書の品質
- トークン単価だけでなく、再試行や人による確認を含めた作業完了までのコスト
Belを確認済み情報として扱うには、OpenAIの発表、モデルカタログ、システムカード、研究論文などに名称が明記される必要がある。さらに、総パラメータ数と有効パラメータ数を分けた技術説明、独立した複数の取材源、再現可能な評価結果があれば、信頼度は大きく高まる。
現段階で最も正確なまとめは、「OpenAIが次世代の事前学習モデルをBelと呼んでいるという未確認の主張がある」だ。モデルの存在、10兆パラメータ、GPT-7との関係、AGIという評価、発表時期については、公式資料または独立した検証が出るまで断定できない。
出典と利用について
- OpenAI公式モデルカタログ
- OpenAIによるGPT-6 Astraの発表
- OpenAIによるNavier–Stokes方程式の研究報告
- OpenAIによる数学・理論計算機科学における10の進展
- OpenAI DevDay 2026公式案内
- @synthwaveddによるBel関連の主張
- Adit_Yahによる再拡散投稿
- Adit_Yahによる情報源の表示
- kimmonismusによる出典付き投稿
- yumeacademyによる拡大解釈の例
- roonによる研究能力の拡散に関する投稿
- MukhtadaによるBel情報の証拠経路の分析
- Traictoryによる10兆パラメータ説の検討
- Skala BlogによるBelの噂の検証
一次出典はOpenAIの公式資料である。OpenAI、ChatGPT、GPTおよび関連する商標は、それぞれの権利者に帰属する。本稿はOpenAIの提供、後援、承認を受けた公式コンテンツではない。
Xの投稿は元の投稿へのリンクとして示し、投稿画面を画像として複製していない。本文中の編集画像には、ロゴ、製品画面、実在人物、第三者の写真を使用していない。未確認情報、二次的な再拡散、OpenAIの公式発表を区別し、資料の文章を直訳せず独自に再構成した。