OpenAIの「1万AIエージェント」は難問研究をどう変えたのか
OpenAIが2026年9月8日に公表したNavier–Stokes方程式に関する研究成果は、ひとつのチャットボットが難問に答えたという話ではない。約1万のAIエージェントを並行稼働させ、異なる仮説を探索させながら、有望な途中結果を共有し、最終的に解析的な証明とLeanによる形式化へまとめた大規模研究プロジェクトである。
注目を集めたのは、GPT-6 Astraより大幅に能力が高いとOpenAIが説明する、訓練中の内部モデルが使われた点だ。ただし、未公開モデルに一度質問しただけで長年の数学的難問が解決したわけではない。内部モデル、エージェントの分業、コード実行、キャッシュされたウェブ情報、人間による計算資源の配分、Codexによる中間成果の統合、そしてGPT-6 Astraを使った形式検証までを含むシステム全体の成果として見る必要がある。
要点
- OpenAIは、滑らかな外力を受ける3次元非圧縮性流体について、有限時間で特異点が発生する構成を示したと発表した。
- Navier–Stokes方程式に関する探索だけで、約270万件のメッセージ、約1300億出力トークン、約88時間が費やされた。Leanによる形式化と検証には、さらに約17時間を要した。
- 論文と形式証明が公開されても、数学界による独立検証やClay Mathematics Instituteの正式な判断が完了したことにはならない。
公表された研究規模
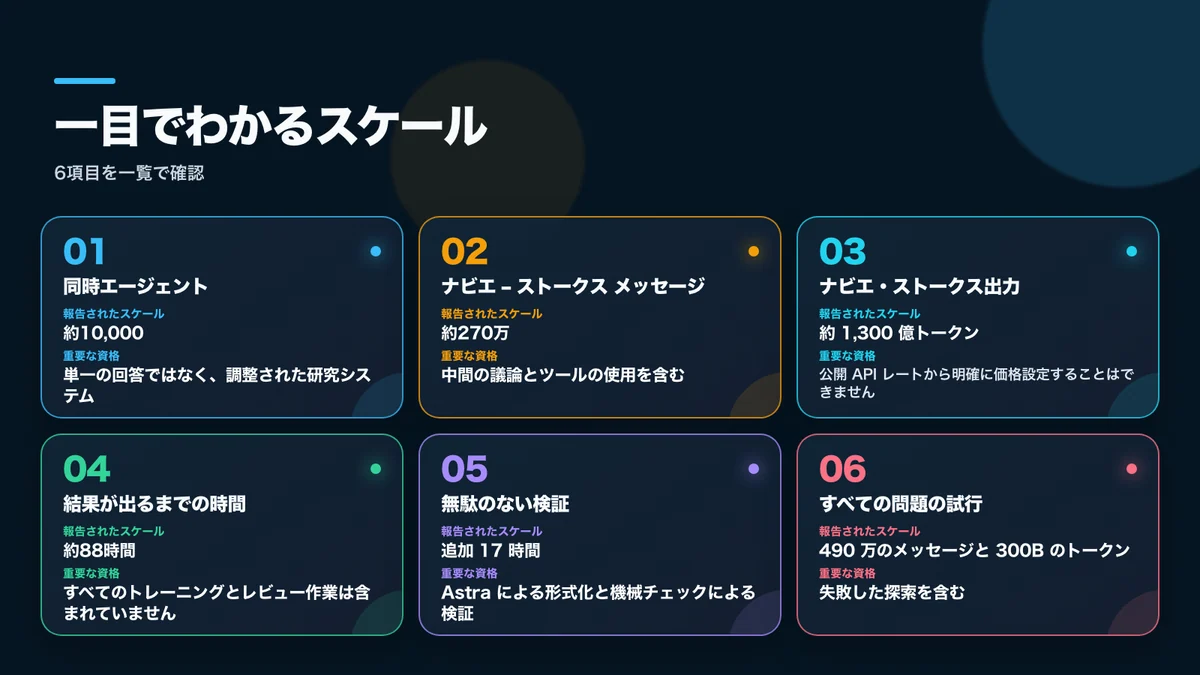
OpenAIの説明に基づく主な規模は次の通りだ。
- 同時に動いたAIエージェントは約1万。
- Navier–Stokes方程式の探索では約270万件のメッセージを生成。
- 同じ探索で使用した出力は約1300億トークン。
- エージェント群が結果に到達するまで約88時間。
- その後、GPT-6 AstraによるLean形式化と検証に約17時間。
- 他の数学問題を含む試行全体では約490万件のメッセージ、約3000億出力トークン。
これらはOpenAIが公表した値であり、第三者が計測した数字ではない。また、トークン数だけから研究費や消費電力を算出することもできない。内部モデルの推論方法、キャッシュの利用率、ハードウェア構成、学習コスト、失敗した実行の扱いなどが開示されていないためだ。
何を証明したと主張しているのか
Navier–Stokes方程式は、水や空気などの流体の動きを記述する。航空機の設計、気象予測、血流の解析をはじめ、幅広い分野の基礎となる方程式だ。数学上の大きな問いは、滑らかな初期状態から始まる3次元非圧縮性流体が、その後も常に滑らかであり続けるのか、それとも有限時間のうちに速度などが際限なく大きくなる特異点を生じ得るのか、という点にある。
OpenAIは、最初は静止している流体に滑らかな外力を加えたとき、有限時間で特異点が発生する構成について、解析的証明とLean形式化を作成したとしている。その中心にあるのは、内側へらせん状に巻き込みながら引き伸ばされる渦の構造だ。
会社の説明では、速度が発散する一方でエネルギーは有限に保たれる。さらに、加速度、圧力、移流、粘性などに関係する大きな項が精密に打ち消し合うことで、外力そのものは滑らかに維持されるという。
OpenAIは、この結果がClay Mathematics Instituteによる定式化のうちCとDの命題を満たすと説明している。ただし、これは現時点ではOpenAI側の主張である。研究者による証明の精査、主要な計算の再現、Leanコードの監査、誤りが見つかった場合の修正などは、発表とは別の過程になる。OpenAI自身も、今回の成果を根拠にミレニアム賞を請求する意向はないとしている。
約1万のエージェントはどう動いたのか
OpenAIによると、8月28日から事前学習済みモデルに大規模な強化学習を行い、9月1日には未解決のミレニアム懸賞問題や、影響が大きいと判断した複数の問題で実験を始めた。問題の定式化を少しずつ変えた課題を複数のグループに割り当て、各グループのエージェントにはキャッシュされたインターネット情報の参照、コードの実行、グループ内での通信を認めたという。
初めからすべての計算資源をNavier–Stokes方程式へ集中させたわけではない。約100のエージェントが約50時間をかけ、外力のないEuler方程式について正則性に対する反例を発見したとされる。人間の研究者はこれを有望な手掛かりと判断し、他の問題からエージェントを移動させ、その途中結果をNavier–Stokes方程式の研究グループへ渡した。
内部モデルの訓練が進み、より新しいチェックポイントが利用可能になると、稼働中のエージェントも更新された。探索が進んだ段階では、Codexが各グループの中間成果を整理し、別のグループが続きから検討できるようにした。
したがって、これは「AIだけで完結した自律研究」でもない。どの問題を対象にするか、計算資源をどこへ移すか、どの途中結果を重視するか、どのようなプロンプトを与えるか、そして何を公表できるかという判断には、人間の研究者が関与している。
1300億出力トークンが示すもの
約1300億出力トークンという数字は、ひとつの長大な回答を生成した量ではない。多数のエージェントが仮説を立て、計算し、反論し、失敗した経路を捨て、別のグループへ知見を渡すまでの総量だ。
試行した全問題では約3000億出力トークンに達したため、最終成果につながらなかった探索にも大きな計算資源が使われたことになる。この点は科学研究において重要だ。成功した一本の経路だけでなく、大量の失敗や行き止まりを含む探索全体が、結果を得るためのコストだからである。
一方、公開APIの単価を単純に掛けて研究費を推計するのは適切ではない。内部環境の価格体系やハードウェア稼働率が分からず、訓練と推論の費用も分離されていない。1300億という値は計算規模の大きさを表すが、正確な請求額を表す数字ではない。
再現性にも課題がある。約1万のエージェントを88時間動かす方法は、一般的な大学の研究室がすぐに再現できる規模ではない。ただし、完成した証明が十分に簡潔で、公開されたLeanコードを小規模な環境でも検査できるなら、成果を生み出す計算量と成果を検証する計算量は分けて考えられる。
Leanによる形式検証の役割
自然言語で書かれた数学証明には、明記されていない前提、符号の間違い、境界条件の見落としなどが紛れ込むことがある。Leanでは、定義と推論の各段階を形式言語で記述し、小さな信頼対象であるカーネルに確認させる。
OpenAIは、エージェント群が結果へ到達した後、GPT-6 Astraを用いたLean形式化と検証に約17時間を追加したと説明している。
ただし、Leanで検査に通ったことが、そのまま元の問題全体の解決を保証するわけではない。形式化された定義が本来の数学的問題に正確に対応しているか、読み込んだライブラリや仮定が妥当か、論文中の説明が形式定理の範囲を超えていないかは、人間が確認する必要がある。
形式証明の大きな利点は、検証可能性にある。公開された成果物がそろっていれば、外部の研究者は物語としての説明を信じるだけでなく、同じカーネルで証明を再検査できる。
内部モデルを「Bel」と呼べない理由
オンラインでは、OpenAIの将来モデルの名称として「Bel」を挙げる未確認情報が流れている。しかし、今回の公式発表はその名称を使用していない。明らかにされているのは、GPT-6 Astraより大幅に能力が高いとされる新しい内部モデルであり、なお訓練中だという点までだ。
そのため、現段階で適切な呼称は「OpenAIの内部モデル」である。BelやGPT-7と結び付けたり、特定のパラメーター数を断定したりする根拠は、資料中には示されていない。
また、モデル単体の能力と研究システム全体の能力も区別すべきだ。同じモデルを通常のチャット画面で使えたとしても、約1万のエージェント、各種ツール、中間成果の統合、人間の判断、Lean検証を組み合わせた環境が自動的に再現されるわけではない。
研究を加速する可能性とリスク
OpenAIはAIによる研究加速の解説で、文献調査、仮説生成、コーディング、検証の循環をAIが速める可能性を説明している。今回の事例は、それを大規模に運用した例といえる。多数のアプローチを同時に調べ、離れた中間成果を結び付け、最終的な経路を形式証明へ圧縮できる点は大きい。
しかし、規模が大きくなれば正しさが自動的に高まるとは限らない。似た訓練を受けたエージェントが同じ思い込みや誤った前提を共有し、間違いを高速で増幅する可能性もある。OpenAIが別途公開しているモデルの不整合に関する報告枠組みと不整合を監視するための案内も、大規模なエージェント運用では行動監視や問題報告の仕組みが重要になることを示している。
日本の研究機関や企業が参考にできる点
日本の大学や企業が、約1万のエージェントという規模をそのまま再現する必要はない。実用的なのは、エージェント数ではなく役割分担の設計を取り入れることだ。
たとえば、仮説を作る担当、反例を探す担当、文献と出典を確認する担当、コードを実行する担当、最終結果を独立に検証する担当を分ける。計算資源が限られている場合は、エージェントを増やす前に、各工程の終了条件や自動テスト、誤りを検出した際の差し戻し手順を整えるほうが現実的である。
研究データの扱いも事前に定める必要がある。エージェントが参照できる論文や社内資料の範囲、中間生成物の保存期間、外部のモデル事業者へ送信できる情報、著者や発明者の扱い、誤りがあった場合の責任を明文化しておくべきだ。公開検証が可能な数学研究と、個人情報や営業秘密を含む産業研究では、同じ運用ルールを使えない。
よくある疑問
ミレニアム懸賞問題は正式に解決されたのか
OpenAIは、公式な定式化に含まれるCとDの命題を示したと主張している。ただし、独立した数学者による検討やClay Mathematics Instituteの手続きは別であり、受賞や正式認定が確定したわけではない。
GPT-6 Astraが問題を解いたのか
主要な探索を担ったのは、GPT-6 Astraより能力が高いと説明された内部モデルと、約1万のエージェントからなるシステムである。Astraは、その後のLean形式化と検証に使われた。
一般利用者は内部モデルを使えるのか
公開モデルとして提供されていることは、資料から確認できない。正式名称、提供時期、料金、コンテキスト長も発表されていない。
1万のエージェントは1万人の研究者と同じか
同じではない。エージェントは同一または類似するモデルを複数回動かした実行単位であり、訓練上の偏りや弱点を共有する可能性がある。独立した経験、専門分野、説明責任を持つ1万人の人間とは性質が異なる。
実用的な結論
今回の発表で重要なのは、単体のチャットモデルの性能よりも、計算によって拡張された研究組織の形だ。強力な内部モデル、多数のエージェント、数百万件のメッセージ、コードや情報参照のツール、人間による方向付け、Codexによる知見の統合、Lean形式検証がひとつの流れとして組み合わされている。
研究機関や企業が取り入れるべきなのは、まず分業と独立検証である。多数決で正解を決めるのではなく、仮説を作る工程と、それを壊そうとする工程を分離する。最終成果については、出典、途中の判断、使用したツール、検証方法を後から追跡できるようにすることが欠かせない。
証明が独立検証に耐えれば、今回のプロジェクトはAIによる科学研究加速の重要な事例になり得る。一方、1300億トークンという規模自体は、結論が正しいことの証拠ではない。公開された論文とLean成果物は検証の出発点であり、検証そのものを省略するものではない。
出典と利用について
- OpenAI, On the Navier–Stokes Millennium Prize Problem
- OpenAI, A view inside AI-accelerated research
- OpenAI, Model misalignment reporting framework
- OpenAI Developers, Misalignment monitoring
- Clay Mathematics Institute, Navier–Stokes equation
OpenAI、GPT、Codex、Leanに関する名称および商標は、それぞれの権利者に帰属する。本記事は企業や研究機関による後援、承認を受けた公式コンテンツではない。公開資料をもとに、確認可能な事実、OpenAIの主張、編集上の分析を区別して構成している。掲載画像は独自の編集用イメージであり、実際の研究現場や製品画面を示すものではない。