Xiaomi MiMo-V2.6を読み解く:100万トークン、マルチモーダル、大規模RLの実力
Xiaomiは2026年9月22日、AIモデル群「MiMo-V2.6」を正式に発表した。構成は、高性能を重視する「MiMo-V2.6-Pro」、速度と費用のバランスを狙う「MiMo-V2.6-Flash」、エージェント強化学習の研究に向けた9B規模の蒸留チェックポイントだ。モデルの重みや技術資料、強化学習に関する情報もあわせて公開されている。
注目点はモデルの大きさだけではない。ProとFlashはテキスト、画像、動画、音声を扱い、最大100万トークンのコンテキスト内でコーディング、ウェブ利用、パソコン操作、サイバーセキュリティーなどの長い作業に取り組むことを想定している。さらにXiaomiは、学習の一部を公式ライブRLダッシュボードで公開し、ステップ数、処理トークン、推定費用、再起動、評価値の変化を記録した。
ただし、発表時点の性能値の多くはXiaomi自身が実施または報告したものだ。100万トークンへの対応も、あらゆる長文処理で同じ精度や費用対効果が得られることを意味しない。MiMo-V2.6は有力なオープンウェイトAIの候補だが、実際の導入判断には独立した検証と業務データでのテストが必要になる。
要点
- Proは総パラメーター1兆200億、動作時に420億を有効化するSparse MoEモデル。Flashは総3,090億、動作時に150億を有効化する。
- 両モデルは最大100万トークンのコンテキスト、最大12万8,000トークンの出力、マルチモーダル入力、ツール呼び出しに対応する。
- API料金は低く設定されているが、元のチェックポイントを自前で動かすには大規模なGPU環境が必要で、性能値にも第三者による再現確認が残る。
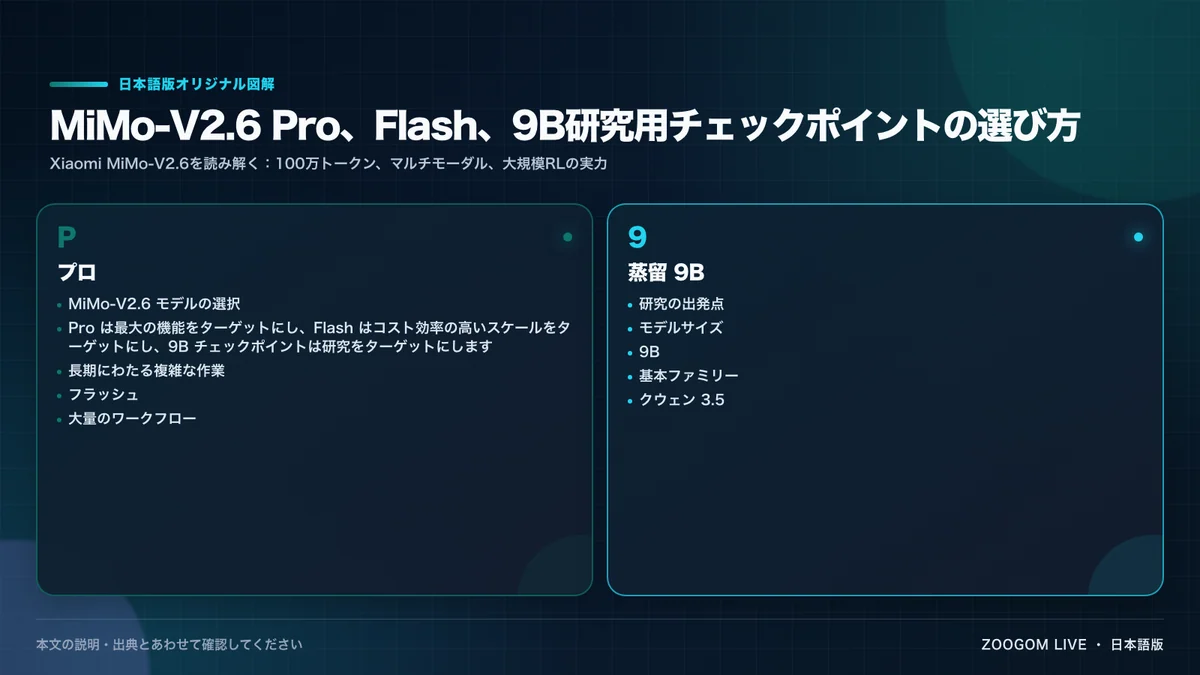
Pro、Flash、Distill 9Bの違い
Proは、複雑なプロジェクトや長時間にわたるエージェント作業を想定した上位モデルだ。モデルカードによると、総パラメーターは1兆200億で、各トークンの処理時には420億を有効化する。
Flashは総3,090億、動作時に150億を使う構成で、Proと同じ種類の入力や長いコンテキストに対応しながら、API料金を抑えている。多数のリクエストを処理する用途や、繰り返しツールを呼び出すワークフローでは、Flashのほうが試しやすい。
一方、「MiMo-V2.6-Distill-Qwen-9B」はProをそのまま小型化した製品ではない。Xiaomiの説明では、Qwen3.5-9Bを基盤に、コード、一般的なエージェント、視覚を使うコーディング、サイバーセキュリティーのデータで教師あり微調整した研究用チェックポイントである。ローカル実験には現実的な選択肢だが、ProやFlashと同等の能力を備えるわけではない。
巨大モデルでも全パラメーターを毎回使わない
ProとFlashはSparse MoE、つまり疎な専門家混合モデルを採用する。入力トークンごとに全パラメーターを計算するのではなく、ルーターが一部の専門家を選ぶ。Proでは384のルーティング専門家から8つ、Flashでは256から8つが有効になる。
これにより計算量は抑えられるものの、Proが一般的な420億パラメーターの密モデルと同じ機材で動くという意味ではない。処理時に使う計算量と、全モデルの重みを保存・分散するためのメモリーは別の制約だからだ。
Xiaomiの公式SGLang例では、Proにテンソル並列16、データ並列2、2ノードの構成を使う。Flashの例もテンソル並列8、データ並列2を前提とする。個人向けパソコンや単体の一般的なGPUで、元モデルを手軽に運用できる規模ではない。
100万トークンで何が変わるのか
ProとFlashは最大100万トークンのコンテキストと、最大12万8,000トークンの出力を掲げる。大きなコードリポジトリー、複数回にまたがるツール実行履歴、文書群、動画や音声から得た情報を一つの処理に含められる余地がある。
ただし「100万トークンを入力できる」ことと、「100万トークンでも常に正確で安い」ことは同じではない。入力が長くなれば、非キャッシュ部分の料金、応答時間、情報検索の難しさが増える。古い指示と新しい指示が衝突したり、エージェントが不要なツール出力をため込んだりする可能性もある。
実務では、必要な情報だけを検索して渡し、途中結果を要約し、チェックポイントやコンテキストキャッシュを使う設計が引き続き重要だ。100万トークンは、コンテキスト管理を不要にする機能ではなく、扱える上限を広げるものと考えるのが妥当だろう。
画像、動画、音声とパソコン操作
公式モデルカードによれば、ProとFlashはテキスト、画像、動画、音声を一つのモデルで入力できる。視覚処理には6億8,100万パラメーターのMiMo ViT、音声には3億800万パラメーターのAudioTokenizerと1億2,700万パラメーターのパッチエンコーダーを使う。
ホスト型モデルは推論、ツール呼び出し、ストリーミング、ウェブ検索、構造化出力、コンテキストキャッシュにも対応する。Xiaomiは、3Dゲーム場面の作成、Blenderでのモデリング、画面を見ながらのオフィスソフト操作、文献検索や計算ツールを組み合わせた材料候補の選別、Figmaやフロントエンド、スライド、動画、音楽の制作フローなどを想定例として挙げている。
これらは対応範囲を示す事例であり、すべてのアプリやパソコン環境で同じ結果を保証するものではない。画面操作の品質はモデルだけでなく、画像取得、クリックやキー入力の仕組み、アプリの権限、再試行、誤操作を止める安全策にも左右される。
ライブ強化学習で公開された記録
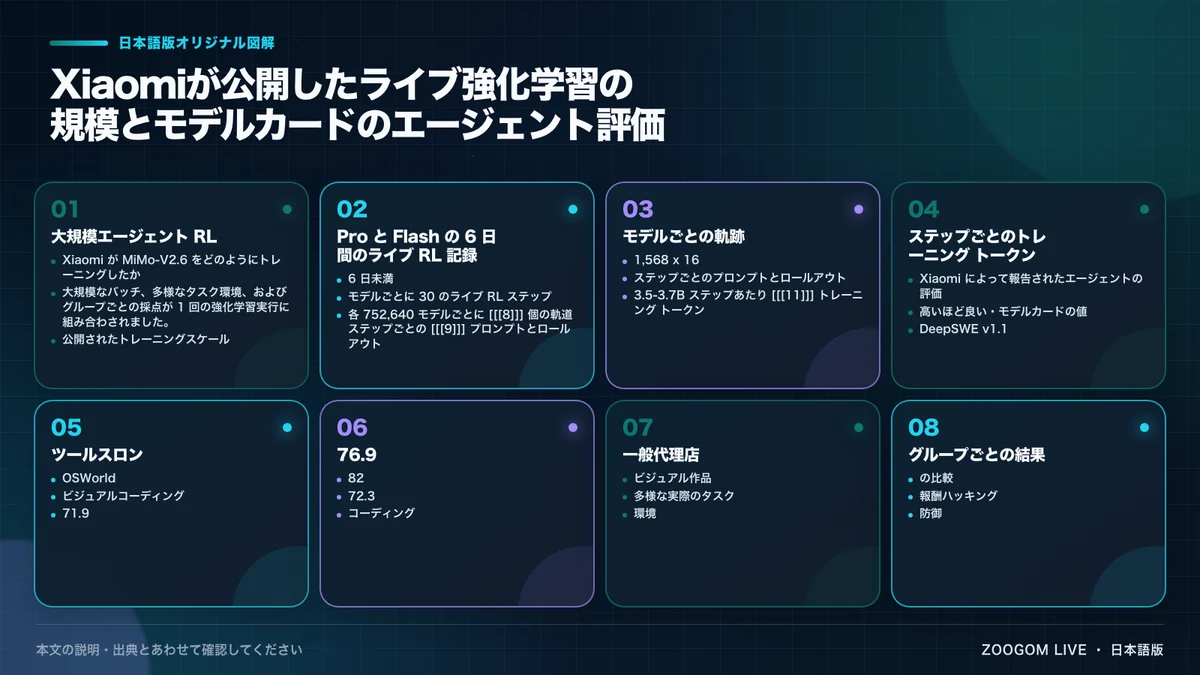
公式ダッシュボードでは、2026年9月22日時点でProとFlashの学習がそれぞれ30ステップを終え、「ended」と表示されていた。
各モデルは1ステップ当たり1,568件のプロンプトについて16回のロールアウトを行い、2万5,088件のtrajectoryを生成した。30ステップの累計はモデルごとに75万2,640件となる。累計学習トークンはProが約750億、Flashが約814億。最終推定費用はProが約262万米ドル、Flashが約85万4,000米ドルだった。記録上の再起動回数はProが14回、Flashが5回である。
運用上の問題も公表された。Proでは専門家への負荷の偏りによるGPUメモリー不足や、学習クラスターと評価システム間のネットワーク問題が報告された。Flashでは、あるデータセットの基盤障害が遅れて検出され、15ステップ目から再開している。問題のあるロールアウト傾向が確認されたサイバーセキュリティー用データを、後続のPro実行から除外したという説明もある。
この記録からは、大規模なエージェント強化学習が、データ、分散処理、評価器、報酬設計を継続的に調整する工程であることが分かる。ただし、公開されているのはXiaomiが運営したシステムのログであり、外部監査や第三者による再現実験ではない。
「自己改善」は自動的な自己書き換えではない
Xiaomiは今回の学習を、自己改善に向かう強化学習と説明している。これは、提供中のモデルが利用者の知らないところで自らの重みを書き換えるという意味ではない。
公開された方法は、複数の解決経路を生成し、成功した経路同士を比較しながら、より短く効率的な解決策に報酬を与えるものだ。さらに、報酬の抜け穴を利用する挙動を抑えるため、敵対的評価、異常検出、検証器の相互確認を組み合わせる。複数のツール実行環境を混ぜて学習し、未経験の環境にも手順を応用できるようにする狙いも示されている。
つまり、管理された学習工程で評価信号を細かくし、反復的にモデルを改善する仕組みである。「自己改善」という言葉だけから、無制限に自律進化するサービスだと受け取るべきではない。
ベンチマークは有力だが制作元の報告値
公式モデルカードでは、ProとFlashの順に、DeepSWE v1.1が71.9と67.9、Toolathlon-Verifiedが76.9と73.6、OSWorld-Verifiedが82.0と80.8、MiMo VisualCodingが72.3と71.5と報告されている。CyberGymではFlashが95.1、Proが94.0だった。
FlashがProに近い数値を示した点は注目に値する。ただし、評価設定はXiaomiが選択・実行したもので、MiMo Code BenchやMiMo Cyber Benchなど社内評価も含まれる。比較対象が同じ応答時間、トークン量、ツール利用回数で測定されたとは限らない。
現段階では、「すべての非公開モデルを上回った」と断定するより、「オープンウェイトのモデル群として競争力のある初期結果を示した」と捉えるのが安全だ。
API料金と日本から試す際の注意
海外向け従量制APIの100万トークン当たりの料金は、Proがキャッシュ済み入力0.0036米ドル、非キャッシュ入力0.435米ドル、出力0.87米ドル。Flashはそれぞれ0.0028米ドル、0.14米ドル、0.28米ドルだ。Pro UltraSpeedは0.036米ドル、4.35米ドル、8.70米ドルとなる。
非キャッシュ入力100万トークンと出力10万トークンを使う場合、追加機能を除く計算上の料金はProが約0.522米ドル、Flashが約0.168米ドルになる。ウェブ検索は海外向け料金で1,000回当たり5米ドルが別途発生し、取得したページが入力に加わればトークン料金も増える。Batch APIはProとFlashのリアルタイム料金から50%割引と案内されている。ウェブ検索の対応モデルと料金も用途に応じて確認したい。
日本からの利用可否、支払い方法、適用地域、税の扱いは、実際の登録時に公式コンソールで確かめる必要がある。為替で円換算額が変動するため、本稿では根拠のない固定換算値を示していない。
APIはOpenAIまたはAnthropic互換プロトコルに対応し、モデルIDはmimo-v2.6-pro、mimo-v2.6-flash、mimo-v2.6-pro-ultraspeedとされる。ただし互換性は、接続先URLやモデル名を変更して既存SDKを利用しやすいという意味だ。ChatGPTやOpenAIの契約にMiMoの利用料が含まれるわけではない。推論フィールド、マルチモーダルファイル、ストリーミング、複数ターンのツール履歴は、利用するクライアントごとに検証したほうがよい。
オープンウェイト、ライセンス、データ管理
MiMo-V2.6-Pro-RL、MiMo-V2.6-Flash-RL、MiMo-V2.6-Distill-Qwen-9BのモデルページにはMITライセンスが表示されている。研究、改変、商用利用に比較的寛容な条件だが、製品に関係するすべての権利問題がなくなるわけではない。
基盤モデルや第三者コンポーネントの条件、生成物の著作権・肖像権・商標権、APIサービスの利用規約とプライバシーポリシーは別途確認が必要だ。サイバーセキュリティー機能は、許可を得たシステムだけで使わなければならない。
ホスト型APIへソースコード、顧客資料、従業員情報、未公開研究を送る場合は、保存期間、学習への利用、処理地域、削除機能、監査対応、法人契約を確認したい。自前運用なら外部送信は減らせるが、アクセス制御、秘密情報の遮断、ログのマスキング、ツール権限の最小化、出力検証は運用者の責任になる。
実用的な結論
大量のコーディング支援、文書処理、反復的なツール呼び出しを低コストで試したいチームにはFlashが有力だ。視覚情報と複数のツールを組み合わせる難しい長期作業ではProが候補になる。GPUクラスターを持つ組織や、モデル内部を研究したい開発者は、公開された重みの利点を活用しやすい。
一方、独立検証済みのモデルだけを採用する組織、日本語の長文や敬語、固有名詞で高い精度を求める用途、個人用パソコンで元のProやFlashを動かしたい利用者は、急いで導入する必要はない。日本語性能についても、公開資料だけでは実務品質を確定できない。
現実的な進め方は、実際の業務を反映した小さな評価セットを用意し、ProとFlashを同じツール権限、同じトークン予算で比較することだ。正答率だけでなく、総費用、応答時間、ツール失敗からの復旧、長い会話での指示維持、機密情報の扱いまで測定したうえで利用範囲を広げたい。
出典と利用について
本稿は一次出典であるXiaomi MiMoの公式発表、モデルページ、モデルカード、学習ダッシュボードを照合し、日本語向けに構成し直したものです。ベンチマーク、学習規模、推定費用、料金はXiaomiによる公表値であり、独立監査済みの数値として扱っていません。
Xiaomi、MiMo、Qwenおよび関連する商標は、それぞれの権利者に帰属します。本稿はXiaomiの提供、承認、後援による広告ではありません。掲載画像は製品画面、商標ロゴ、公式発表画像、第三者の写真を複製したものではありません。
- Xiaomi MiMo:MiMo-V2.6公式発表
- Xiaomi MiMo:公式ライブRLダッシュボード
- Xiaomi MiMo:MiMo-V2.6-Proのモデル情報と料金
- Xiaomi MiMo:MiMo-V2.6-Flashのモデル情報と料金
- Hugging Face:MiMo-V2.6-Pro-RLモデルカード
- Hugging Face:MiMo-V2.6-Flash-RLモデルカード
- Hugging Face:MiMo-V2.6-Distill-Qwen-9B
- Xiaomi MiMo:Batch API料金
- Xiaomi MiMo:ウェブ検索の対応モデルと料金