Claude Opus 5.5「性能低下説」を検証――本当に弱体化されたのか
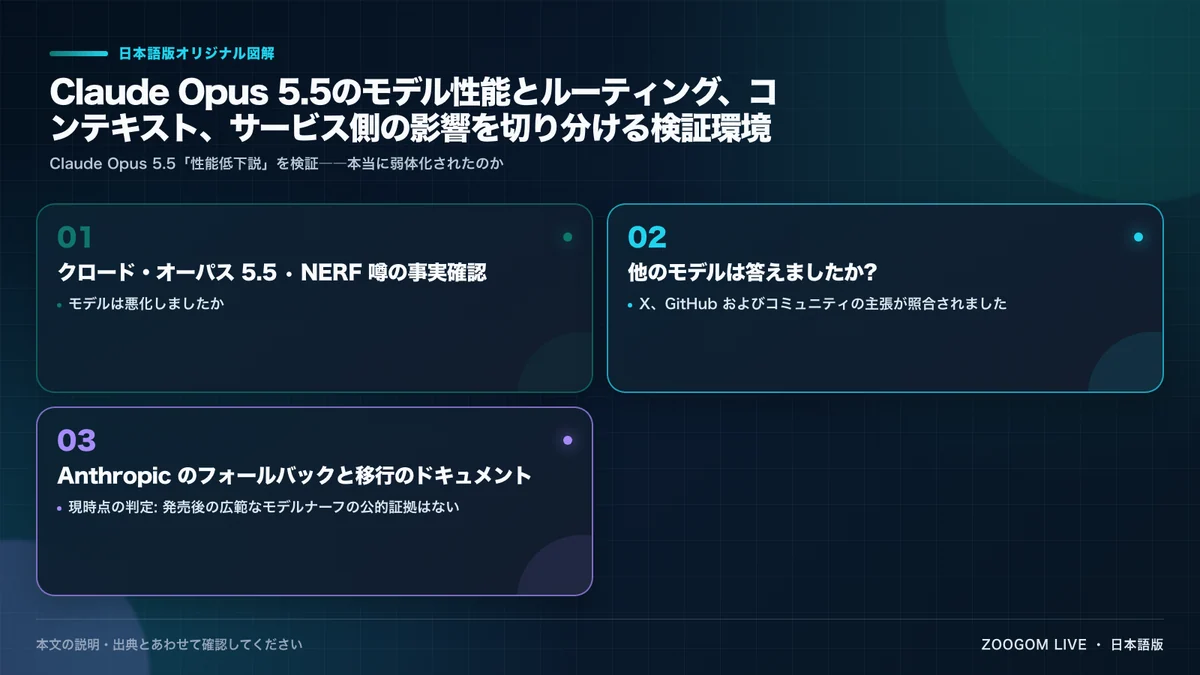
Claude Opus 5.5の公開後、XやReddit、GitHubでは「最初より回答が悪くなった」「指示の見落としが増えた」「以前のモデルに戻されたように感じる」といった声が相次いだ。日常的に同じリポジトリでClaude Codeを使う開発者にとって、修正回数や抜け漏れの増加は軽視できない問題だ。
ただし、利用者が品質低下を経験したことと、AnthropicがOpus 5.5そのものをリリース後に弱体化したことは、同じ意味ではない。
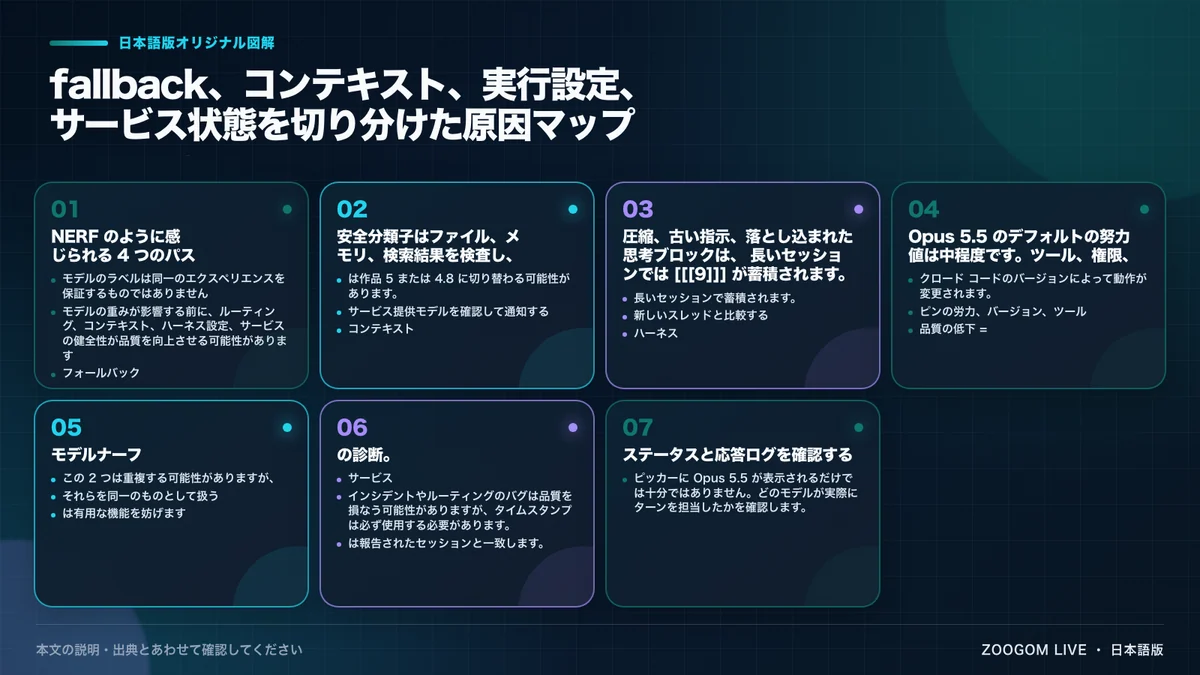
2026年9月27日時点の公開情報から言えるのは、Opus 5.5の重み、量子化品質、提供時の計算量が広範に引き下げられたと示す証拠は確認できないということだ。一方で、自動的なモデル切り替え、推論量を調整するeffortの初期値、thinkingの表示、長い会話のコンテキスト、サービス基盤の不具合など、性能が落ちたように見える要因は複数ある。
要点
- X、Reddit、GitHubには品質低下を訴える実際の投稿があるが、多くは同一条件で繰り返した比較や、実際に応答したモデルの記録を伴っていない。
- ClaudeアプリやClaude Codeでは、安全性分類の結果によってOpus 5.5からOpus 5またはOpus 4.8へ切り替わる場合がある。
- Opus 5.5の
effortの初期値はmediumであり、初期値がhighだったOpus 5とは、設定を省略しただけで比較条件が変わる。 - モデル自体の弱体化は未確認だが、利用者が感じた品質問題まで否定できるわけではない。
「弱体化」という言葉に混在する三つの問題
第一は、モデルの重みや量子化、割り当てられる計算量がひそかに変更されたという主張だ。これは最も強い意味での「モデル弱体化」に当たる。立証するには、モデルと実行環境を固定し、同じ課題を変更前後に何度も実行した記録が必要になる。現在公開されている利用者報告は、その水準には達していない。
第二は、利用者がOpus 5.5を選んでいても、特定のリクエストには別のモデルが回答するケースだ。Anthropicはこれをfallbackとして説明している。結果が以前より弱く感じられる可能性はあるが、Opus 5.5自体の能力を下げたこととは区別しなければならない。
第三は、モデルを取り巻く環境の変化だ。Claude Codeのバージョン、ツールや権限、effort、会話履歴の圧縮、メモリ、ルーティング、サービス障害などが含まれる。利用者から見えるのは最終的な回答なので、原因が異なっていても、体験としてはすべて「モデルが急に賢くなくなった」と映りうる。
Xとコミュニティ投稿から分かる範囲
Anthropicは2026年9月22日、XでClaude Opus 5.5の公開を告知した。これは公開日と製品の存在を確認できる一次資料だが、その後のすべてのリクエストで同じ提供品質が保たれたことまで証明するものではない。
公開直後には、Opus 5より大きく改善したと評価する肯定的なX投稿もあった。一方、「弱体化しないでほしい」という懸念も早い段階から現れた。どちらも利用者の初期体験や期待を示す資料ではあるものの、独立したベンチマークではない。
Redditの「Opus 5.5 nerfed?」というスレッドでは、当初は優秀だったモデルが、ほどなく繰り返し修正を必要とするようになったとの主張が出た。これに対し、公開直後すぎて継続的な劣化を判断できないという反応も寄せられている。
別の「弱体化しないでほしい」というRedditでの議論では、毎日同じテストを行って変化を追跡する案も示された。ただし、これは検証方法の提案であって、弱体化を証明した結果ではない。Hacker Newsの公開時の議論にも、高評価と将来の性能低下への警戒が並んでいる。
投稿の多さや賛同数は、うわさが広がった背景を知る手掛かりにはなる。しかし、モデルの内部変更を示す技術的な証拠にはならない。
GitHub Issueは調査の手掛かりであり、結論ではない
9月23日には、Claude Codeのリポジトリに「Opus 5.5 performance degradation」Issue #96205が登録された。報告者はWindowsとClaude Code 2.1.280を使用し、1日のうちに品質が大幅に落ちたと説明している。
これは無視すべき報告ではない。特定環境での不具合、fallback、サービス障害、あるいはモデル側の問題を調べる出発点になりうる。
ただし、Issueには再現用プロンプト、比較対象となる出力、レスポンスID、実際に回答したモデル、effort、トークン使用量、同一条件での反復結果が掲載されていない。したがって「問題はなかった」とも言えないが、サービス全体でOpus 5.5が弱体化された証拠とも言えない。
公式に確認されている自動fallback
Anthropicのモデル切り替えに関するヘルプ記事によると、Opus 5とOpus 5.5へのリクエストには自動安全性分類が適用される。判定対象は直前の入力だけではなく、Claudeが参照するメモリ、コネクターの内容、ウェブ検索結果、ファイルにも及ぶ。
公式説明では、分類結果に応じて次のような処理が行われる場合がある。
- 一部の高リスクなサイバーセキュリティ関連リクエストはOpus 4.8へ切り替えられる。
- ウイルス学、毒性学、分子設計などに関わる一部のデュアルユース生命科学リクエストはOpus 5へ切り替えられる。
- 一部のフロンティアLLM開発リクエストはOpus 5へ切り替えられる。
- 内部推論の抽出を試みるリクエストは、別モデルへ切り替えずに拒否される場合がある。
Claudeのウェブ、モバイル、デスクトップ各アプリとClaude Codeでは、自動切り替えが初期状態で有効になることがある。切り替え時には通知と回答モデルの表示が行われると説明されているが、それを見落とせば、Opus 5.5が突然弱くなったように感じても不思議ではない。
一度切り替わると、モデル選択が下位モデルのまま残る場合もある。原因となった内容が会話履歴に残っていれば、Opus 5.5を選び直しても同じ判定が繰り返されうる。設定で自動切り替えを無効にすると、下位モデルによる回答の代わりに、該当リクエストが停止する可能性がある。
APIでは実際に回答したモデルを確認できる
Claude APIの拒否とfallbackに関する文書では、確認すべき情報が具体的に示されている。APIの自動fallbackは初期設定ではなく、開発者側で構成する必要がある。
切り替えを利用している場合は、次の三つを確認する。
- 応答の最上位にある
model:最終的なメッセージを生成したモデル fallbackコンテンツブロック:モデル間の切り替え記録usage.iterations:各試行、fallback_message、モデル別のトークン使用量
このfallbackを引き起こすのは安全性分類による拒否であり、レート制限、過負荷、サーバーエラーが自動的に下位モデルへ転送される直接の理由ではない。
fallback後は、同じ会話が約1時間にわたり切り替え先のモデルへ直接送られる「sticky routing」の影響を受ける場合もある。その後の応答に新しいfallbackブロックがなくても、最上位のmodelとusage.iterationsを確認する必要がある。
effortの初期値はhighからmediumへ変わった
AnthropicのOpus 5.5変更ガイドでは、effortの初期値がmediumとされている。Opus 5の初期値はhighだったため、両モデルで設定を省略すると推論条件がそろわない。
Opus 5.5ではadaptive thinkingが常時有効で、完全には無効化できない。同じeffortでも多く考える傾向があるため、max_tokensが小さすぎると最終回答に使える余裕が減る可能性もある。比較するならmedium、high、xhighなどを明示し、出力上限も統一する必要がある。
モデルIDだけを入れ替えた場合、ツール呼び出しや互換性の違いまで「推論能力の低下」と誤認するおそれがある。モデルだけでなく、実行環境と設定を一緒に記録することが重要だ。
thinkingの表示と長い会話も体感を左右する
Opus 5.5では、ツール呼び出しの間に挟まる短い進行説明が通常のテキストではなくthinkingブロックとして返される。初期設定のdisplay: "omitted"では内容が表示されず、処理が続いていても画面上では停止したように見える場合がある。
thinkingブロックはモデルと会話に結び付いている。Opus 5.5から多くの下位fallbackモデルへ切り替わると、切り替え先が読み取れない過去のthinkingブロックが除かれる可能性がある。公式文書では、Fable 5.1とMythos 5.1はOpus 5.5のブロックを維持できる例外として挙げられている。リクエスト自体は成功しても、長い作業の計画が途中で不安定になったように見えることがある。
また、長期間続けたClaude Codeのセッションには、古い要件、使われなくなったファイルパス、失敗したツール出力、メモリ、圧縮された要約が残る。同じ一文を入力しても、新しい会話と長い会話では、モデルが実際に受け取るコンテキストが異なる。
インフラ障害で品質が落ちた前例
Anthropicは2025年、三つの品質問題に関する事後検証を公開した。そこでは、コンテキスト長に関係する誤ったサーバールーティング、出力の破損、TPUコンパイラーの問題によって、一部の応答品質が実際に低下したと説明している。利用者の報告が増えた一方、社内の自動評価では問題をすぐに捉えられなかったことも認めた。
同社は、需要、時間帯、サーバー負荷を理由に意図的にモデル品質を下げることはないとの立場を示している。ただし、この事例はモデルの重みを変更しなくても、配信基盤の不具合によって利用者の体験が悪化しうることも示す。
つまり、「モデル弱体化の公開証拠がない」と「品質上の問題は一切起きていない」は別の結論である。
実用的な確認方法
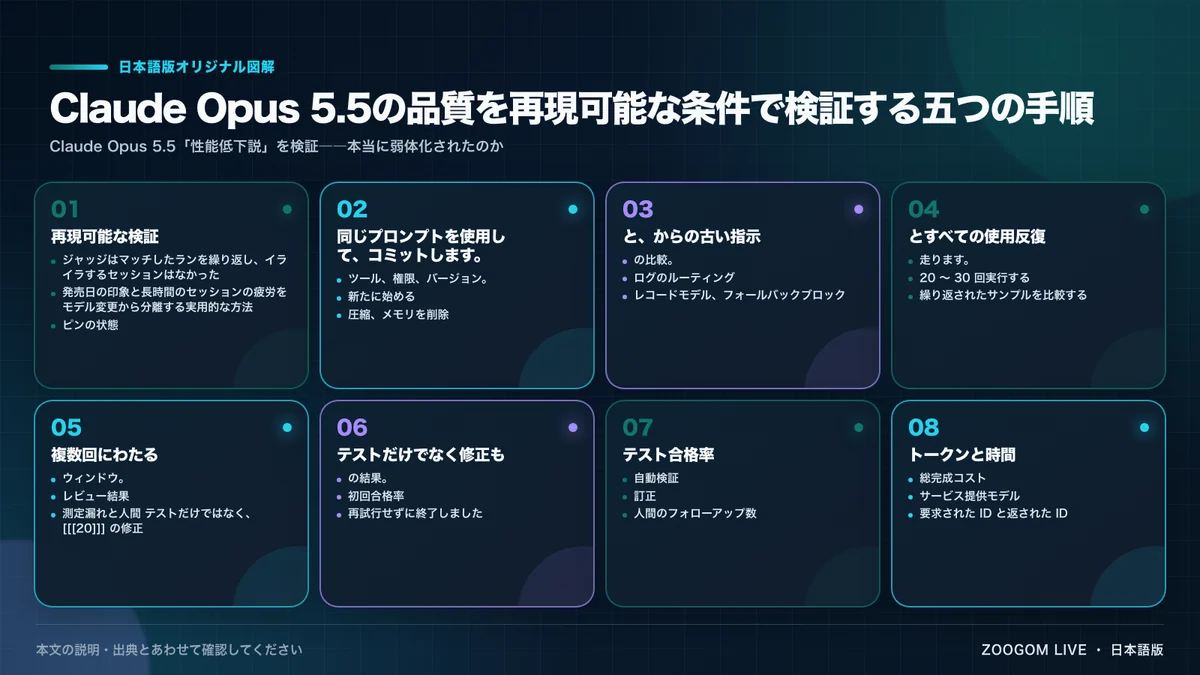
性能低下を感じた場合は、まず問題が起きた会話を残したまま、次の手順で条件を切り分けたい。
- 同じ依頼を新しい会話で実行する。
- 選択したモデルと、応答に表示されたモデルがともにOpus 5.5か確認する。
- 自動モデル切り替えの通知と、Claude Codeのモデル設定を確認する。
effortと出力上限を明示し、Claude Codeのバージョン、ツール、権限、リポジトリの状態を固定する。- メモリ、ファイル、検索結果などに安全性分類の対象となりうる内容が含まれていないか調べる。
さらに強い検証を行うなら、正解やテスト条件がある課題を10件以上用意し、同一条件で20~30回試す。日時、レスポンスID、要求したモデル、実際に回答したモデルを記録し、初回成功率、テスト通過率、見落とし、追加修正回数、トークン量、完了時間を比較する。
API利用者はmodel、fallbackブロック、usage.iterationsを保存する。一般向けアプリでは同じ詳細ログを取得しにくいため、表示モデル、切り替え通知、新規会話での比較、画面記録が手掛かりになる。
現時点の結論
2026年9月27日時点で、公開資料から確認できる範囲は次の通りだ。
- 確認済み: 一部のOpus 5.5へのリクエストは、安全性分類の結果によってOpus 5またはOpus 4.8へfallbackする場合がある。
- 確認済み: Opus 5.5の
effortの初期値はmediumで、Opus 5のhighとは異なる。 - 確認済み: thinkingの表示方法と、モデル切り替え時の推論コンテキストの扱いが変わった。
- 確認済み: X、GitHub、Reddit、Hacker Newsには、品質低下の体験談や将来の弱体化を懸念する投稿がある。
- 未確認: Anthropicが公開後にOpus 5.5の重み、量子化品質、提供時の計算量を広範に引き下げたという主張。
したがって、すべての利用者報告を誤りとして退けるのも、体感だけを根拠にモデル自体が弱体化されたと断定するのも適切ではない。まず実際に回答したモデルとeffortを確認し、新しい会話で条件をそろえて再試行する。それでも一貫した低下が続くなら、レスポンスIDと実行条件を添えた報告が、次の検証に最も役立つ。
出典と利用について
- Anthropic, Claude Opus 5.5公開発表
- Anthropic, Opus 5またはOpus 5.5との会話でモデルが切り替わる理由
- Claude Platform, 拒否とfallback
- Claude Platform, Opus 5.5の変更点
- Anthropic, 2025年の品質問題に関する事後検証
- GitHub, Claude Code Issue #96205
- Reddit, Opus 5.5 nerfed?
- Reddit, Dear Anthropic please do not nerf
- Hacker News, Claude Opus 5.5公開時の議論
- Anthropic公式X、Opus 5.5公開投稿
AnthropicおよびClaudeの名称と商標は、それぞれの権利者に帰属する。Zoogom.comはAnthropicから後援、承認を受けた公式サイトではない。本記事は公式文書、単独の利用者報告、コミュニティ上の反応を異なる証拠として扱い、Xのスクリーンショット、公式チャート、第三者の写真を転載していない。