GPT-6 AstraとClaude Opus 5.5、1回の指示でゲームを作るならどちらか
自然な言葉でゲームの内容を一度だけ指示したとき、どのAIモデルがより遊べる作品を完成させるのか。2026年9月時点で比較の中心となるのは、OpenAIの最上位モデルとして紹介されているGPT-6 Astraと、AnthropicのClaude Opus 5.5だ。
公開されている同一プロンプト実験では、Claude Opus 5.5が機能や演出の多いゲームを作り、第一印象の豊かさで優位と評価された。一方、GPT-6 Astraには、コードを書くだけでなく、ブラウザやゲームエンジン上で動かし、画面を確認しながら問題を直す一連の作業に強みがある。
ただし、これは単純な勝敗ではない。初回から多くの要素を盛り込むモデルは、魅力的なデモを作りやすい反面、時間や出力トークンも多く使う。逆に、範囲を絞って早く完成させるモデルでは、望む品質に届くまで追加の指示が必要になる可能性がある。
要点
- 同じ指示で2種類のゲームを作った個人の公開実験では、Opus 5.5の成果物が両方とも高く評価された。
- 2作品の合計制作時間はOpus 5.5が92分、Astraが51分だった。
- API定価による合計費用はOpus 5.5が20.65ドル、Astraが13.97ドルだったが、作品ごとに安いモデルは異なった。
- Opus 5.5は、明示されていない操作、演出、音楽などを積極的に追加した。
- Astraは、実行、画面確認、テスト、修正を連続して行うエージェント型の開発に重点を置いている。
- 実験ではClaude CodeとCodexという異なる環境が使われており、モデルだけの厳密な比較ではない。
「1回の指示でゲームを作る」とは
ここでいうゲーム制作は、チャット画面にHTMLコードを表示させるだけの作業ではない。AIエージェントは指示を読み解き、操作方法やゲーム状態を設計し、複数のファイルを生成し、実際に起動してエラーを探し、遊べる状態へ整える必要がある。
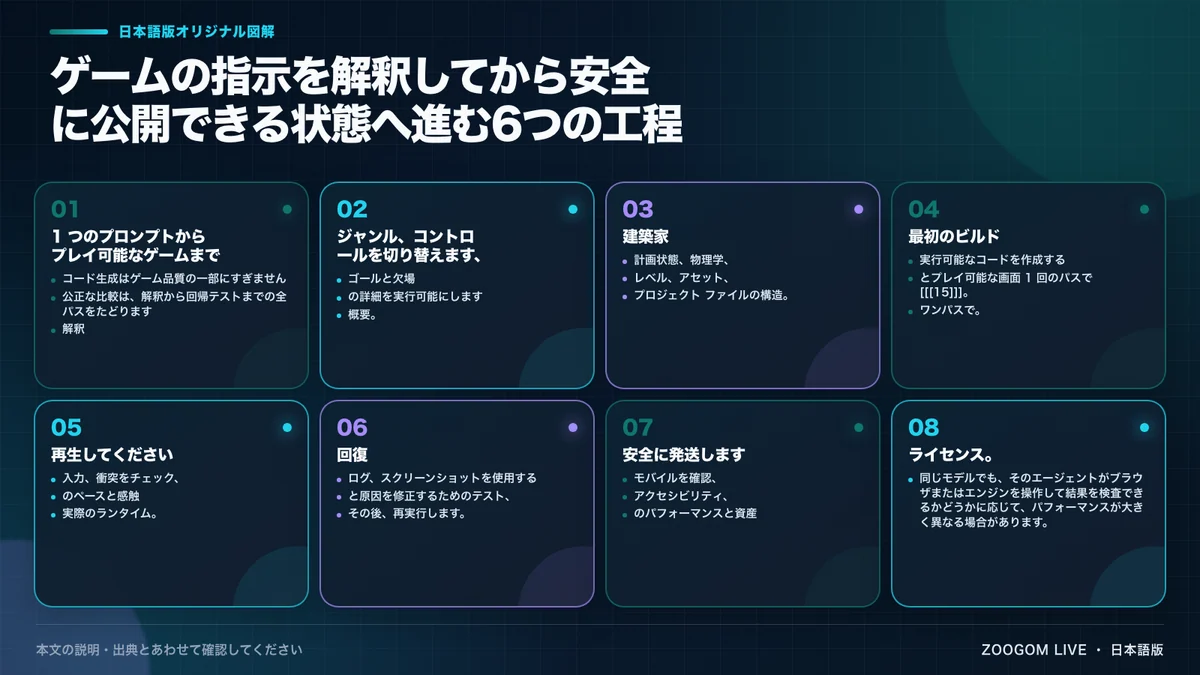
評価すべき点も、コードの行数だけではない。最初の起動に成功するか、操作に気持ちよさがあるか、ルールに奥行きがあるか、アニメーションやサウンドが機能しているかといったゲーム固有の品質が重要になる。さらに、ブラウザでの検証、修正後の不具合、スマートフォンでの操作、使用素材のライセンスまで確認しなければ、公開可能な作品とは言いにくい。
同じモデルでも、ターミナル、ブラウザ、ゲームエンジンにどこまでアクセスできるかで結果は変わる。そのため、今回の比較はモデル単体ではなく、モデルと実行環境を組み合わせた事例として読む必要がある。
同じプロンプトで2本のゲームを制作
直接的な比較材料となるのが、2026年9月25日に公開されたMoe Luekerによる同一プロンプト実験だ。各モデルには空のフォルダーと独立したGitリポジトリが与えられ、同じ指示が入力された。途中で修正を求める追加プロンプトは使われていない。
課題は、飛行区間を含むランナーゲームと、複数の仕組みが連動する穏やかな雰囲気の島づくりゲームだった。
ランナーゲームでOpus 5.5が実装したのは、ジャンプだけではない。ダイブ、ブレーキ、ダッシュ、チェックポイント、キノコによる加速、グライダー、スイング操作、オリジナルのBGMまで盛り込んだ。Astraも独自のグラフィック、奥行きを感じさせる背景、上昇できる滑空区間を用意したが、仕組みの数はOpusより少なかった。実験者が数えたゲーム部分のコードは、Opusが2,405行、Astraが358行だった。
島づくりゲームでも傾向は似ていた。Opusは建物の配置に応じたボーナス、夜になると明かりがつく家、歩き回る住民、航行するボート、沖合のクジラなどを追加した。Astraの作品は整理されていたものの、建設と画面表現はより簡素だった。実験者は2回ともOpusの作品を上位に選んでいる。
これは作品の豊かさに関する実験者の評価であり、すべてのゲームジャンルに当てはまる公式な順位ではない。
高機能な初回ビルドには時間もかかる
実験で示された費用は、ClaudeやCodexのサブスクリプション料金ではない。ローカルに残った制作ターンの使用量を、APIの定価に当てはめた換算値である。追加修正に使うプロンプトは計算に含まれていない。
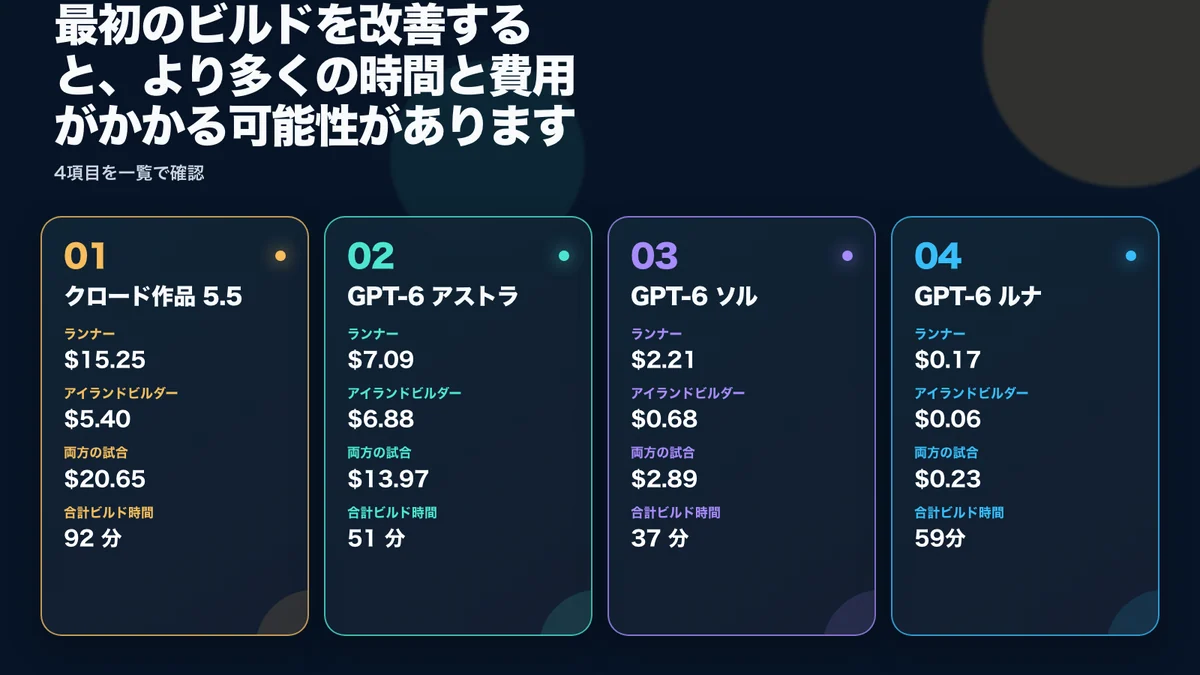
ランナーゲームでは、Opusの出力が約25万6,000トークン、Astraは約3万6,000トークンだった。Opusの出力量は7倍を超え、費用は15.25ドル、制作時間は62分となった。Astraは7.09ドル、24分だった。
島づくりゲームでは、出力量の差が約3倍まで縮まり、費用の関係が逆転した。Opusは5.40ドル、Astraは6.88ドルだった。2作品の合計では、Opusが20.65ドルで92分、Astraが13.97ドルで51分となる。
ここで注目すべきなのは、1トークンの価格ではなく、目的の状態まで完成させるための総費用だ。Opusのようにモデル自身が機能を広げれば、最初から見栄えのする作品になりやすいが、コード量や検証対象も増える。Astraが小さな範囲で仕上げた場合、最初の費用は抑えられても、要求水準によっては後から追加作業が発生する。
この実験だけで絶対的な順位を決められない理由
同一の指示と分離された作業フォルダーが使われた点は比較として有用だが、厳密に統制された研究ではない。
Opus 5.5はClaude Code、GPT-6各モデルはCodexで動作した。ランナーゲームではLunaだけがmax、その他のモデルがxhighの推論設定だった。島づくりゲームではLunaを除いてhighが使われている。システム指示、ツールの扱い、コンテキスト管理、標準的なテスト行動は実行環境によって異なる。
対象も2Dブラウザゲームの2作品に限られる。Unityの3D物理、Godotのシーン構造、オンラインゲームの同期、モバイル端末のメモリー最適化でも同じ結果になるとは確認されていない。今回の結果は具体的な実制作例として価値がある一方、ゲーム開発全般を代表する大規模ベンチマークではない。
コーディング評価から読み取れること
Anthropicが公開したClaude Opus 5.5の公式情報では、Terminal-Bench 4.0のスコアはOpus 5.5が66.4%、GPT-6 Astraが57.9%とされている。長時間にわたるターミナル中心の作業で、Opusが強いことを示す材料だ。
ただし、同じAnthropicの表でも、AutomationBenchはAstraが41.4%、Opusが40.0%だった。科学研究型のターミナル評価でも、Astraが64.6%、Opusが58.7%となっている。ベンダー自身が掲載した数値を見ても、すべての評価で一方が勝っているわけではない。
Artificial Analysisによる独立比較では、Intelligence IndexがOpus 5.5のhigh設定で54、Astraのmax設定で53だった。Terminal-Bench 4.0は両モデルとも59.6%で並んでいる。
こうした数値は、両モデルが高度なコーディング能力を持つことを補強する。しかし、ジャンプの感触、画面演出の統一感、何度も遊びたくなるルールといったゲームの面白さを直接測るものではない。
Astraは実行後の検証ループに強み
OpenAIによるGPT-6 Astraの紹介では、ウェブサイトの作成、フロントエンドの品質確認、ソフトウェアのインストールとテスト、画面上で発見した問題の修正といったコンピューター操作が強調されている。Lovableによる初期評価では、推論強度を高くすると、新しいビルドでの反復やブラウザテストが増えたと説明されている。
OpenAI Developersのゲーム制作事例では、名前を付けたテストシーン、Playwrightによるスクリーンショット、実際の操作経路、状態変化の記録が組み合わされた。地形などの数値が正しいだけで終わらせず、ブラウザ上でシェーダーのコンパイル、GPUへのデータ転送、動きや画面遷移まで再確認する方法だ。
Playcoのゲーム試作事例では、UnityとGodot内でシーンを変更し、プレイと検証を繰り返す流れが紹介されている。Playcoによると、Astraは同じグレーボックスを土台にテーマの異なる3つのプロトタイプを作り、多くが最初から動作した。手作業による修正も従来モデルに比べて50%減ったという。
ただし、これはOpenAIが掲載した顧客事例であり、第三者による対照実験ではない。Astraが目指す開発フローを示す資料としては参考になるが、一般的な性能差としてそのまま断定することはできない。
Opus 5.5が初回から豊かに作り込む理由
Claude Opus 5.5のモデル資料は、同モデルを長時間のエージェント型コーディングや知識作業に向けたものと説明している。コンテキストウィンドウは100万トークン、最大出力は12万8,000トークンで、適応型の推論が常時有効になっている。標準のeffort設定はmediumだ。
公開実験で特徴的だったのは、最低限の要求を満たしたところで停止せず、ゲームらしさにつながる仕組みを自ら補った点だ。操作の種類、報酬、時間による雰囲気の変化、動くオブジェクト、音楽まで一体として組み立てている。
これは、1回の指示で見せられるデモを作りたい場合には魅力的だ。一方、依頼していない機能が増えれば、テストや保守の負担も大きくなる。華やかな試作品と、仕様を絞った製品コードは同じ目標ではない。
日本の利用者が選ぶときの目安
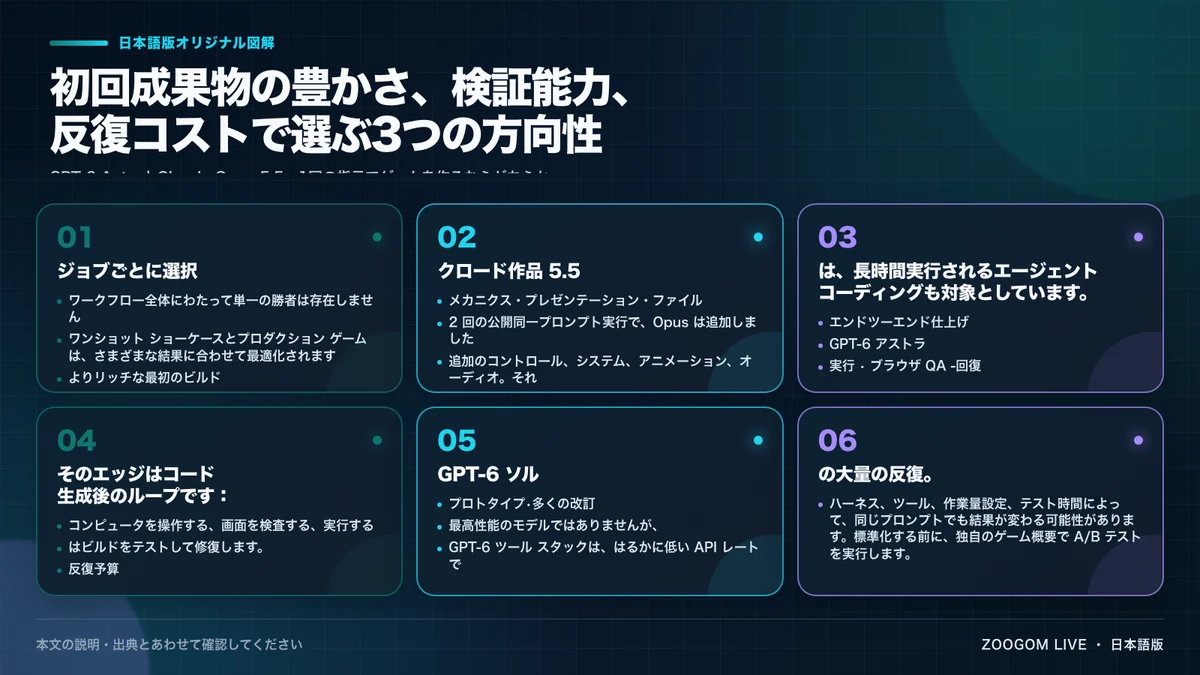
- 一度の指示で印象的なデモを作りたい場合: 今回の公開実験ではOpus 5.5が有利だった。細かな指示がなくても、ゲームの仕組み、演出、サウンドを補う傾向が結果に表れている。
- ブラウザやゲームエンジンでテストを繰り返す場合: Astraが有力な候補になる。ただし、ゲームを実行して画面やテスト結果をモデルへ返せる環境が必要だ。
- 多数のアイデアを試作してから選ぶ場合: GPT-6 Solは現実的な選択肢だ。同じ実験では最高評価の作品ではなかったが、2作品の合計は2.89ドル、37分だった。
- 単純なミニゲームを数多く生成する場合: Lunaも候補になるが、複雑な作品を最初から最後まで単独で担当させるより、案出しや小規模な修正に向く。
日本から利用する場合でも、API料金とChatGPT、Codex、Claudeの各サブスクリプション上限は分けて考える必要がある。定額プランでは、ドル換算の費用より、一定時間内の利用上限、週ごとの制限、処理中断、再試行の回数が実際の生産性を左右することもある。
実用的な結論
用途が異なるなら、1つのモデルに全工程を任せる必要はない。たとえば、Opus 5.5でゲームの仕組みや演出を含む初期版を作り、Astraでブラウザテストと不具合修正を進める方法が考えられる。費用を抑えたい場合は、Opusで詳しい設計と合格条件をまとめ、Solで複数の案を実装し、最終候補だけをAstraまたはOpusで検証する構成も取り得る。
最も豊かな初回成果物を重視するなら、現在の直接的な公開事例はClaude Opus 5.5を支持している。実行、観察、テスト、修正まで一貫して回したいなら、GPT-6 Astraに明確な強みがある。多くの企画を低い反復コストで試したいなら、GPT-6 Solが現実的だ。
最終的には、自分のゲーム仕様を使って比べるのが確実である。初回起動の成功率、完成までの追加プロンプト数、修正で生じた不具合、プレイテスト時間、総トークン数、人が直した時間を記録すれば、見栄えだけでは分からない実用上の差が見えてくる。
公開前には人によるプレイ確認も欠かせない。モバイル入力、フレームの安定性、セーブデータ、アクセシビリティ、外部パッケージの安全性、音楽・画像・フォントのライセンスは、ゲームが起動しただけでは保証されない。生成に使ったツールとプロンプト、採用した素材、人が行った修正を記録し、既存のキャラクターや画面デザインに過度に似ていないかも確認する必要がある。
出典と利用について
- Moe LuekerによるClaude Opus 5.5とGPT-6 Astraの同一プロンプトゲーム比較
- OpenAIによるGPT-6 Astraの紹介
- OpenAI DevelopersによるAstraを使ったゲーム制作事例
- OpenAIが公開したPlaycoのゲーム試作事例
- AnthropicによるClaude Opus 5.5の公式情報
- Claude PlatformのOpus 5.5モデル資料
- Artificial AnalysisによるOpus 5.5とGPT-6 Astraの独立比較
- OpenAIによるGPT-6 SolおよびLunaの発表とAPI料金
OpenAI、GPT、Codex、Anthropic、Claudeおよび関連する製品名は、それぞれの権利者に帰属する名称または商標である。本記事は両社から資金提供や承認を受けたものではない。公式仕様、ベンダーが公開した顧客事例、第三者による測定、個人が実施した同一プロンプト実験を区別して構成しており、第三者のゲーム画面、公式製品のユーザーインターフェース、SNS投稿画面、外部写真は転載していない。