Claude Opus 5.5を検証:コーディング性能、料金、GPT-6との違い
Claude Opus 5.5が2026年9月22日に正式公開された。発売前には製品名や価格、公開時期をめぐる未確認情報が流れていたが、現在はAnthropicの公式発表、API資料、第三者による測定結果を分けて確認できる。
先に結論を示すと、Opus 5.5は、あらゆる評価で他モデルを上回る「万能の1位」ではない。一方で、長時間動くコーディングエージェントや専門的な知識業務では高い性能を示し、前世代よりAPI単価とプロンプトキャッシュの読み出し料金も下がった。最大の推論強度は高得点につながるものの、トークン消費と待ち時間も増える。実務では標準のmediumを起点にするのが現実的だ。
発売前情報を公式確認済みの内容と分けた記事は、韓国語版の検証記事と英語版の検証記事にまとめられている。本稿では、公開後に確認できる仕様と測定値だけを扱う。
要点
- 入力料金は100万トークン当たり4ドル、出力料金は20ドルで、Opus 5よりそれぞれ20%安い。
- 公式評価では、ターミナルを使うエージェント型コーディングと専門業務で強い。
- Artificial Analysisの最大effort測定では、公開日時点でIntelligence Index 58を記録した。
- ただし最大effortは出力トークンを大量に使い、必ずしも費用対効果が最も高い設定ではない。
- AutomationBenchや科学系ターミナル課題では、GPT-6 Astraが上回った評価もある。
- 導入時はモデルIDだけでなく、推論設定、ツール選択、ストリーミング表示などの互換性確認が必要になる。
基本仕様とAPI料金
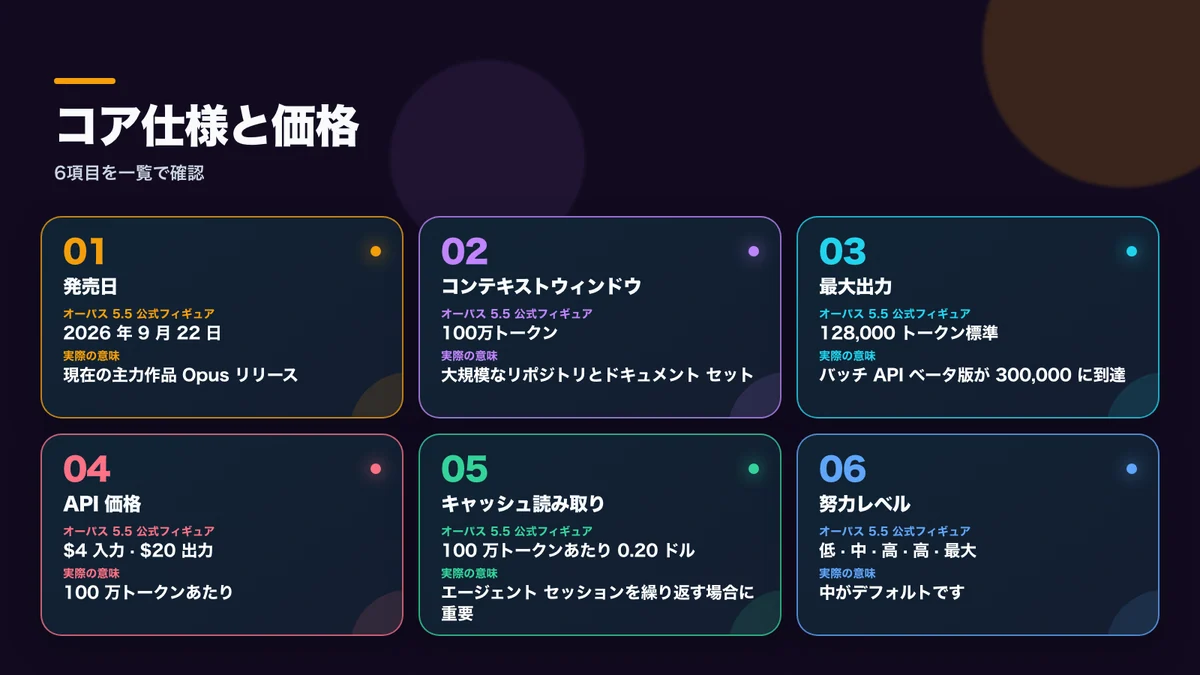
Claude Platformのモデル資料によると、コンテキストウィンドウは100万トークン、通常の最大出力は12万8,000トークン。Batch APIには最大30万トークン出力のベータ枠がある。信頼できる知識の基準時点と学習データの基準時点は、いずれも2026年6月とされている。
公式API価格は入力100万トークン当たり4ドル、出力100万トークン当たり20ドル。Opus 5の5ドル、25ドルから20%引き下げられた。キャッシュ書き込みは5分保持が5ドル、1時間保持が8ドル、読み出しは0.20ドル。Batch APIでは入力2ドル、出力10ドルになる。
Anthropicは、単価の引き下げに加えて一般的な処理で使うトークンと計算量も減り、標準設定におけるタスク単位の費用はOpus 5より40%低いと説明している。キャッシュ読み出し料金は0.50ドルから0.20ドルへ60%下がった。大きなリポジトリや長い会話履歴を何度も参照するエージェントでは、この差が基本の入力単価以上に効く可能性がある。
日本からAPIを利用する場合も請求の基準はドルであり、実際の円支出は為替、税、カード会社の海外決済手数料などに左右される。Claudeの個人・法人向けサブスクリプションとAPI利用料は別の仕組みなので、定額プランへの加入だけでAPI呼び出しが無料になるわけではない。
公式ベンチマークが示す強みと限界
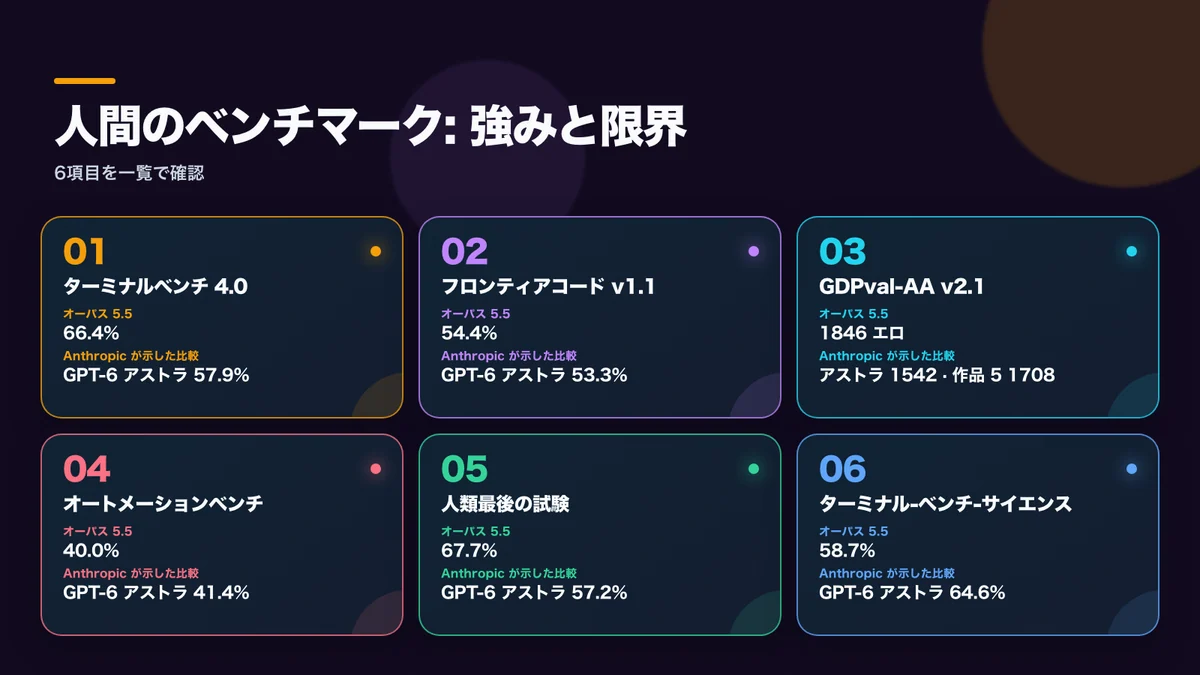
Anthropicの公表値では、Opus 5.5はターミナルを操作するエージェント型コーディング、実際にマージできる変更の作成、44職種を対象とした専門知識業務で強さを示した。Opus 5との比較では、Terminal-Bench 4.0が52.3%から66.4%へ、GDPval-AAが1708 Eloから1846 Eloへ上昇している。
ただし、同じ公式資料にも競合モデルが上回った項目がある。ビジネスアプリの自動操作を測るAutomationBenchでは、GPT-6 Astraが41.4%、Opus 5.5が40.0%。科学研究型のターミナル課題でも、Astraの64.6%に対してOpus 5.5は58.7%だった。リポジトリ作業、アプリ自動化、科学課題、業務文書作成では、それぞれ求められる能力が異なる。
比較時の推論設定も一律ではない。Opus 5.5の多くの結果はmax、Terminal-Benchはxhighで測定され、Astra側にも評価ごとの高い推論設定が使われている。したがって、数ポイントの差を日常利用における確実な優劣とみなすのは難しい。Anthropic自身も、最上位モデル間の体感差はベンチマークの点差ほど大きくない場合があるとしている。
独立測定では最高点と大量のトークン消費が同時に見える
Artificial Analysisの独立評価では、Opus 5.5のmaxがIntelligence Index 58を記録し、測定時点で最も高い公開初日のスコアとなった。10項目のうち、Humanity’s Last Exam、SciCode、GDPval-AA、AA-Briefcase、AA-Omniscience、AutomationBench-AAを含む6項目で首位だった。
専門的な成果物を評価するAA-Briefcaseは1822 Eloで、Claude Fable 5.1を143ポイント上回った。Terminal-Bench 4.0は59.6%で、同じ独立測定におけるGPT-6 Astraとほぼ同水準だった。公式結果と測定方法は異なるものの、コーディングと専門業務が強みだという大きな方向性は一致している。
一方、最大effortの性能向上には負担が伴う。Intelligence Indexの1タスク当たり出力トークン数は、Opus 5.5 maxが約11万9,000、Opus 5 maxが約7万3,000、Fable 5.1が約7万8,000、GPT-6 Astra maxが約2万7,000だった。Opus 5.5はOpus 5の約1.6倍を出力したことになる。単価低下によってタスク当たり費用はOpus 5に近い水準に収まったが、処理時間や長い出力も運用上のコストである。
同じ測定では、mediumが51点で1タスク当たり約1.34ドル、xhighが56点で約3.46ドルだった。評価内容や提供条件は今後変わり得るが、すべてをmaxで処理するより、難しい仕事だけ推論強度を上げるほうが合理的だと読み取れる。
GPT-6 Astra、Solとの比較
同じ評価機関による比較では、Opus 5.5 highのIntelligence Indexが54、GPT-6 Astra maxが53だった。Opus 5.5は出力速度と加重平均トークン価格で有利とされる一方、Astraは一部の自動化・科学系課題で強く、設定によっては最初の出力が始まるまでの時間も短かった。
GPT-6 Sol maxとの比較では、Opus 5.5 highが54対48、Terminal-Bench 4.0が57%対44%で上回った。ただしSolはトークン単価が低く、出力も速かった。複雑なコード変更や重要な分析をOpusに任せ、分類や抽出など大量の定型処理をSolのような高速モデルへ振り分ける設計には合理性がある。
詳しい比較条件は、Artificial AnalysisのOpus 5.5とGPT-6 Astraの比較およびOpus 5.5とGPT-6 Solの比較で確認できる。
effortはどこまで上げるべきか
- low: 分類、短い修正、自動検証できる反復作業
- medium: 一般的なコーディング、調査、文章作成、ツール利用
- high: 複数ファイルの変更、難しいデバッグ、重要な分析
- xhigh: 長時間のエージェント実行、大規模移行、精密な検証
- max: 失敗の損失が大きく、時間や費用より最高性能を優先する限定的な処理
Opus 5.5では適応型推論が常に有効で、完全には停止できない。簡単な依頼までmaxにすると、品質の小さな改善に対してトークン消費や待ち時間が大きく増える場合がある。まずmediumで社内評価を行い、不合格率や人の修正時間が明確に減る作業だけhigh以上へ引き上げるのが安全だ。
長時間コーディングと移行時の注意点
Anthropicは、20万行規模のコードベースを監査・修正する試験でOpus 5.5が3時間以内に完了し、Opus 5は20時間以上かかったうえ、2.5倍のトークンを使ったとしている。また、HAProxyをCからRustへ移行する社内試験では、Fable 5.1より2.5時間早く終わり、費用は51%少なかったという。
これらはAnthropicや初期評価者による事例であり、すべての開発環境で再現される保証はない。実際の試験では、完成の有無だけでなく、回帰テストの通過率、変更ファイル数、取り消したコミット、人が直した時間、再試行を含む総費用まで記録したい。
Opus 5.5の変更・移行資料には、既存システムで確認すべき点も示されている。
- 従来のthinking有効・無効設定ではなく、
effortを使用する。 - 古い方式で特定ツールを強制するとエラーになる場合があり、自動選択と厳格なツールスキーマへの移行が必要になる。
- 保存されたthinkingブロックはモデルと会話にひもづくため、過去の会話を編集する統合機能は検証が必要。
- Claude APIとGoogle Cloudでコンピューター操作を使う場合は、
computer_toolset_20260801が必要。 - ツール呼び出し間のテキストが空に見えることがあり、進捗表示側で
thinking.displayの扱いを確認する必要がある。
モデルIDの変更だけでは移行は完了しない。拒否応答、代替モデルへの切り替え、キャッシュ、ツール定義、ストリーミング画面を含めてテストする必要がある。
安全性に関する主張は外部監査と分けて読む
Opus 5.5は、Dario AmodeiがWe Must Pace the Frontierを公表した後に登場したAnthropicの主要モデルである。同文書の「ペースを調整する」という考え方は、開発の全面停止ではなく、安全性、アラインメント、解釈可能性、第三者検証が能力向上に追いつくよう条件を設けるものと説明されている。
Anthropicによれば、Frontier DesignとMETRが公開前の外部評価に参加した。さらに、重要な行動の実行前に危険性を判定する分類器、監査可能なサンドボックス、Life Sciences Verification Program、Cyber Verification Programを安全対策として挙げている。
ただし、これはAnthropicの安全性に関する説明を支える材料であり、評価範囲、期間、未解決事項、公開を延期できる権限まで開示された完全な独立監査と同じではない。公式発表で確認できる対策と、その有効性に関する外部検証は区別して受け止めるべきだ。
実用的な結論:全面置換より業務別の振り分け
Opus 5.5が向いているのは、大規模なコード変更、複数ツールを使う長時間エージェント、専門調査、複雑な財務・法務文書の整理など、失敗後の手戻りが大きい仕事だ。反対に、短い要約、問い合わせ文案、単純な抽出、正解を機械的に確認できる大量分類では、より安価で速いモデルのほうが適する場合がある。
日本語の敬語、国内の制度名、和英混在資料、日本独自の文書形式について、英語中心の公開ベンチマークと同じ優位性が保たれるとは限らない。導入前には、機密情報を除いた実データで、正確性、根拠の提示、見落とし率、検収時間を測る必要がある。
実務上の出発点はmediumでよい。高い品質が必要なコーディングや分析だけhigh以上へ上げ、定型処理は高速なモデルに任せる。比較すべきなのはランキングではなく、API料金、再試行、人の確認、待ち時間を合わせた「完成結果1件当たりの総費用」である。
出典と利用について
- 一次出典:Anthropic, Claude Opus 5.5
- Claude Platform, Opus 5.5モデル仕様
- Claude Platform, Opus 5.5の変更点と移行案内
- Artificial Analysis, Claude Opus 5.5独立評価
- Artificial Analysis, Opus 5.5とGPT-6 Astraの比較
- Artificial Analysis, Opus 5.5とGPT-6 Solの比較
- Dario Amodei, We Must Pace the Frontier
Anthropic、Claude、OpenAI、GPTに関する名称と商標は、それぞれの権利者に帰属する。本稿は各社の協賛、承認、監修を受けた公式コンテンツではない。Anthropicが公表した数値とArtificial Analysisによる独立測定を区別し、資料中の事実と留保をもとに独自の構成と表現で解説した。公式チャート、製品画面、第三者の写真は使用していない。