Perplexity Portable Computerを解説:24GB VRAMで動かすローカルAIエージェント
Perplexityの「Portable Computer」は、デスクトップPCでチャットボットを動かすだけの製品ではない。AIエージェントの実行基盤や作業計画機能、ローカルモデル、サンドボックスを対応するWindowsまたはLinuxマシン上に配置し、必要な工程だけをクラウドへ引き渡す仕組みだ。
たとえば、大量のローカルファイルを調べて変更案を作る処理は手元のGPUで行い、最新の情報をウェブで確認する工程だけを外部サービスに任せる、といった使い分けが想定される。クラウドへの引き渡しには利用者の承認が必要とされており、処理場所を作業単位で分けることが製品の中心的な考え方になっている。
ただし、「ローカル優先」は「常にオフライン」と同じではない。ウェブ検索、外部モデルによる推論、接続したアプリの操作を許可すれば、質問やファイルの一部などが端末の外へ送られる可能性がある。また、ローカルモデルの処理にトークン単位の料金がかからないとしても、サブスクリプション、対応PC、電力、保守、人による確認の費用までなくなるわけではない。
要点
- Portable Computerは、ローカル実行を基本としながら、承認した工程をクラウドへ引き渡せるAIエージェント環境である。
- 導入には、WindowsまたはLinuxの対応システムと24GB以上のVRAMが必要で、現在の対応一覧にmacOSは含まれていない。
- 評価すべきなのはモデルの回答品質だけではない。送信データ、コネクターの権限、サンドボックスの範囲、消費電力、誤動作からの復旧方法まで確認する必要がある。
ローカルとクラウドのどちらで動くのか
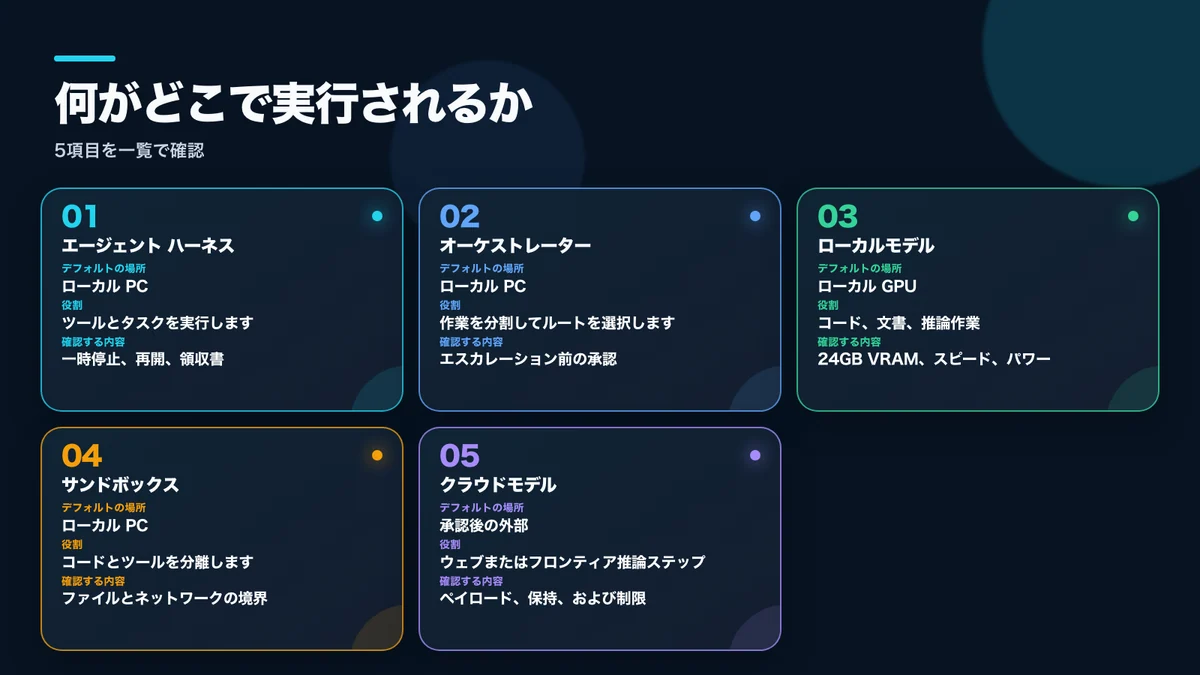
PerplexityによるPortable Computerの公式製品案内では、エージェントの実行基盤、オーケストレーター、プランナー、ローカルモデル、サンドボックスが端末上で動くと説明されている。ローカルモデルとして案内されているのは、PPLX 27Bおよび対応環境で利用できるQwenモデルだ。
一方、ウェブへのアクセスや、より高度なクラウドモデルによる推論が必要になった場合は、その工程を15種類を超えるモデルのいずれかへ引き渡せる。クラウド側の結果はローカルの作業へ戻され、エージェントが処理を続ける。
重要なのは、会話や作業全体を一括してクラウドへ送るのではなく、個別の工程ごとに処理場所を選べる点だ。大規模なコードベースの調査や文書整理を端末内で繰り返し、最新ドキュメントの確認だけを外部で行う、といった構成が可能になる。
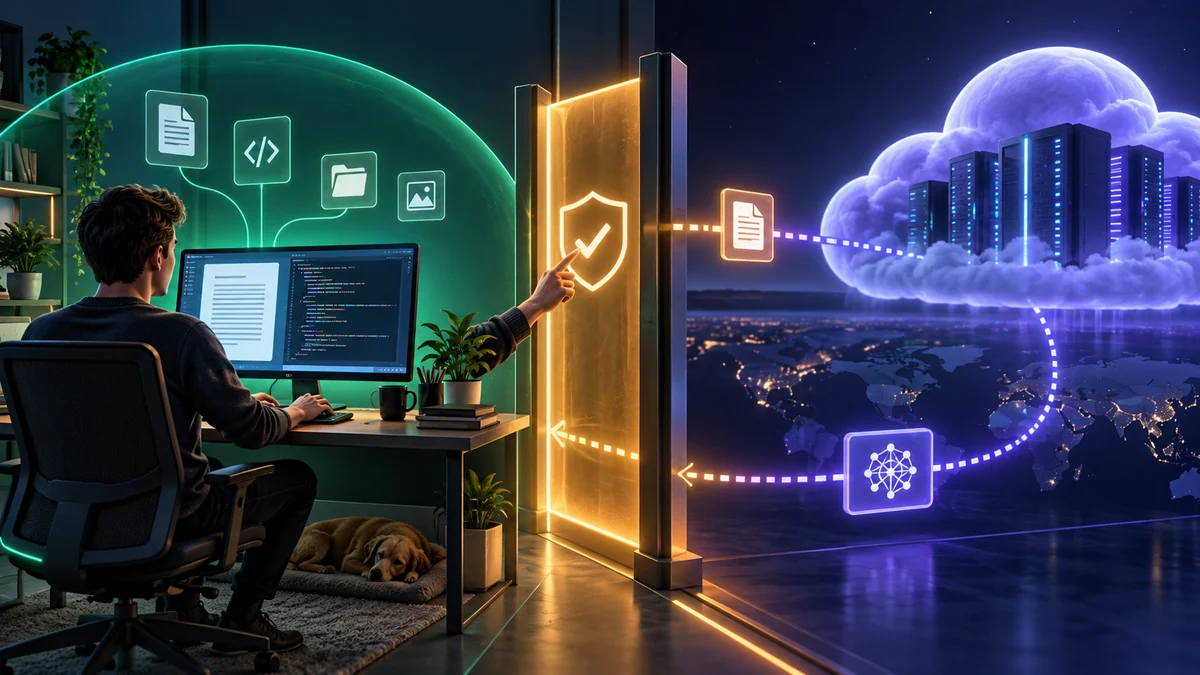
もっとも、この利点は承認画面の具体性に左右される。クラウドへ送られるものが質問文だけなのか、ファイルの抜粋、過去の会話、ツールの実行結果まで含むのかを利用者が把握できなければ、データ境界を適切に判断するのは難しい。機密性の高い作業では、単なる許可ボタンの有無だけでなく、送信内容と送信先を確認できるかが重要になる。
24GB以上のVRAMが必要
Perplexityが示している対応ハードウェアは、NVIDIA DGX Spark、対応するNVIDIA RTX GPU、またはAMD Ryzen AI Maxを備えたシステムで、少なくとも24GBのVRAMが必要とされる。
ここでいう24GBは、一般的なPCのシステムメモリーが24GBあればよいという意味ではない。対応するローカルモデルを処理できるGPU側のメモリー要件として理解する必要がある。購入前には、搭載メモリーの合計だけでなく、対象ハードウェアが公式の対応範囲に入っているかを確認したい。
利用可能なモデルも環境によって異なる。DGX SparkではPPLX 27BとQwen 3.8 27Bが案内されている。Windowsでは、対応するRTXまたはRyzen AI Max環境にローカル推論をセットアップできる。LinuxのRTX搭載PCで現在利用できるのはPPLX 27Bで、Qwen 3.8 27BはLinuxのRTX環境には提供されていない。また、一度に動かせるローカルモデルは1つに限られる。
NVIDIA Nemotron 3.5 Lightningについては、今後対応する予定のモデルとして記載されている。現時点で利用できる機能と同じように扱い、PCの購入判断や業務計画へ組み込むのは避けるべきだろう。
ハードウェアを評価するときは、短時間のベンチマーク結果だけでは不十分だ。エージェントが大規模なリポジトリーや多数の文書を処理すると、GPUを長時間使う場合がある。冷却性能、ファンの音、ドライバーの安定性、スリープからの復帰、モデル保存用のストレージ、遠隔接続後も処理を継続できるかといった点が、実際の使い勝手を左右する。
「トークン単位の料金なし」の範囲
Perplexityは、ローカルモデルが処理した作業にはトークン単位の料金が発生しないとしている。手元のハードウェアで推論するため、ローカル処理量に応じて外部APIの利用料が積み上がらないという意味だ。
そのため、リポジトリー全体の変換、大量ファイルの分類、長い文書群の整理などを繰り返す用途では、処理費用を見通しやすくなる可能性がある。一方、総費用には次の要素が残る。
- Portable Computerを利用できるProまたはMaxの契約
- 24GB以上のVRAMを備えた対応ハードウェア
- 電力、冷却、ローカルストレージ
- ドライバー、モデル、セキュリティーの更新と管理
- 承認したクラウドサービスに設定される利用上限や料金
- 出力を検証し、誤った変更を修正するための作業時間
すでに対応GPUを保有し、大量のローカル処理を継続的に行う利用者や組織なら、利点を得やすい可能性がある。反対に、短い質問をときどき行う程度で、新しいワークステーションを購入しなければならない場合は、クラウドだけを利用する方が運用は単純になり得る。
コネクターは便利だが、権限も広げる
公式ページでは、Gmail、Outlook、Slack、GitHubとのコネクターが紹介されている。受信内容を読み、リポジトリーを調査し、要約を作ってチャンネルへ投稿するといった複数の工程を、一つのエージェント実行につなげられる。
便利になる一方、読み取りと書き込みの両方を許可すると、誤操作の影響も大きくなる。最初は読み取り専用のアカウント、複製したリポジトリー、やり直しやすいファイルを使うのが現実的だ。
特に、メッセージ送信、ブランチへのプッシュ、ファイル削除、予定の作成、アカウント設定の変更など、外部の状態を変える操作には個別の確認を残したい。「今回だけ許可」と継続的な許可の違い、予約実行でも同じ権限が使われるのか、処理記録に何が残るのかも確認項目になる。
サンドボックスがあるからといって、自動的にすべての操作が安全になるわけではない。アクセス可能なフォルダー、外部ネットワークの接続先、シェルコマンド、環境変数や認証情報、子プロセスの権限など、実際の設定範囲を確かめる必要がある。重要な文書やソースコードは別途バックアップし、大規模な変更は差分を人が確認してから反映する運用が望ましい。
日本語環境で試すときの進め方
国内で導入を検討するなら、まず機密性の低い実務から代表的な作業を3つほど選ぶと比較しやすい。大量ファイルの分類、未知のコードベースの説明、失敗したテストの原因候補の整理などが例になる。処理時間だけでなく、VRAM使用量、消費電力、誤りの種類、人が確認するのに要した時間も記録する。
次に、クラウドへの引き渡しをすべて拒否した状態で、どこまで作業を完了できるかを確認する。その後、ウェブ検索だけ、特定のクラウドモデルだけという順序で許可すれば、各ルートから得られる効果と、端末外へデータを出す必要性を分けて評価できる。
コネクターの検証は最後に行い、メール送信やSlackへの投稿より先に、読み取り専用のGitHubリポジトリーなどから始める方が影響を抑えやすい。
日本語の処理品質も独立して確かめたい。長い文書の中で日付、金額、固有名詞を正確に維持できるか、日本語のファイル名や文字コードを扱えるか、要約によって重要な留保が消えていないかを見る。英語での性能が高くても、日本語を含む実際の業務で同じ精度が得られるとは限らない。
実用的な結論
Portable Computerが向いているのは、大量のコードや文書をローカルで処理したい開発者や組織、対応GPUをすでに保有している利用者、そしてクラウドへ送る工程を細かく管理したいチームだ。
一方、Macだけを使う環境、軽量ノートPCやシンクライアントが中心の組織、ワークステーションを管理する担当者がいないチーム、すべての処理を完全なオフライン環境で終える必要がある業務には、現時点で制約が大きい。
導入判断では、「ローカルAI」という名称より、承認時に送信内容を具体的に確認できるか、異常時に安全に停止できるか、端末外へ出たデータを後から追跡できるか、ローカルモデルの品質がハードウェア費用に見合うかを重視したい。まずは非機密データと読み取り専用権限で試し、ローカル処理、クラウド連携、外部操作を段階的に有効にするのが実用的な進め方になる。
出典と利用について
本記事は、Perplexityが公開している機能と要件を資料として、内容を独自の構成と表現で整理したものです。性能、費用、セキュリティー上の効果は利用環境によって変わるため、導入前に実機と実データに近い条件で検証する必要があります。公式の製品画面やロゴ、第三者の著作物は転載していません。