Claude Opus 5.5はナーフされたのか 10月データ検証
9月30日から10月2日にかけて、日本語圏のXでもClaude Opus 5.5の仕事品質が急に落ちた、指示の取りこぼしが増えたという投稿が見られるようになった。日々同じ制作・開発フローで使う人の体感は、調査を始める重要な手掛かりだ。ただし、体感した失敗と「AnthropicがOpus 5.5そのものを一律に弱くした」という原因説明は、まだ同じ証拠ではない。
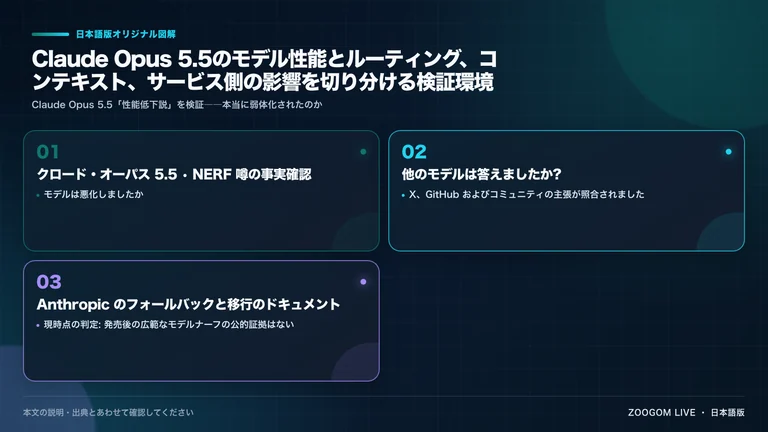
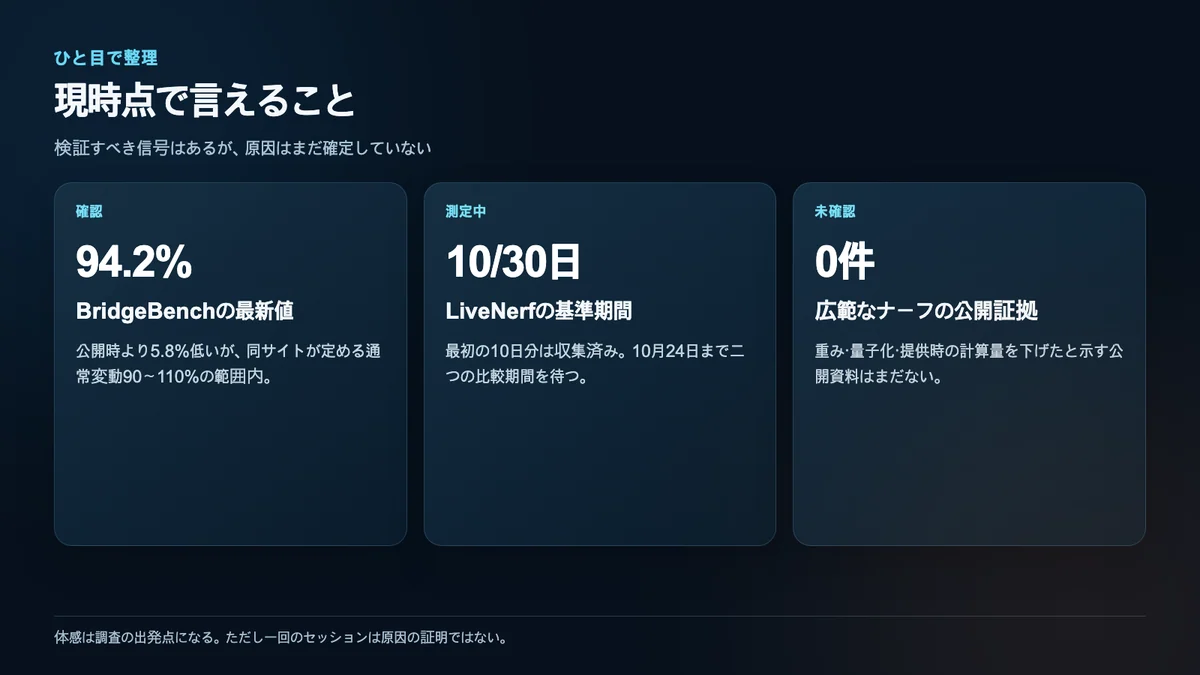
10月3日時点の結論は慎重だ。検証すべき信号はある。BridgeBenchも前回から下がった。しかし最新94.2%は同サービスが定める通常変動の中で、LiveNerfは比較前の基準期間を終えた段階にすぎない。重み・量子化・全体的な推論計算を公開後に下げたと証明する公開資料は見つからない。本稿は9月27日の記事を置き換えない新しいデータ更新であり、筆者が同一環境で独自の性能試験を行ったとは主張しない。
まず結論を三つに分ける
- 観測されたこと: 9月末から品質低下の体感報告が増え、BridgeBenchは10月2日に公開時比94.2%を示した。
- 測定中のこと: LiveNerfは最初の10日分を集めた。変化を判定するには、その後の10日区間を二つ待つ必要がある。
- まだ示されていないこと: Opus 5.5の基盤モデル、量子化品質または全利用者向け計算量を下げたという公開証拠はない。
したがって、現時点で「ナーフ確定」と言うのも、報告をすべて思い込みとして退けるのも早い。日本の利用者が今できることは、問題が起きた長い会話を残し、空の会話と比較し、モデル表示・effort・Claude Codeの版・日時をそろえて再現性を高めることだ。
ナーフという言葉に混ざる四つの原因
最も強い意味のナーフは、同じ名前の裏で重みや量子化を別のものにするモデル変更だ。次に、effortの初期値や出力上限を変える推論条件の変更がある。三つ目は安全判定や製品方針によるルーティング・fallback。四つ目はCLI、ツール、権限、会話要約、キャッシュ、障害といったモデル外の実行環境だ。
どれも短い回答、見落とし、計画の忘却、ツール失敗として現れうる。利用者の損失は原因に関係なく本物だが、改善策は原因ごとに違う。モデルIDだけでなく、実際に応答したモデル、effort、会話長、ツール、地域、時刻を記録しないと、どの層を直すべきか判断できない。
公開から11日間の流れ
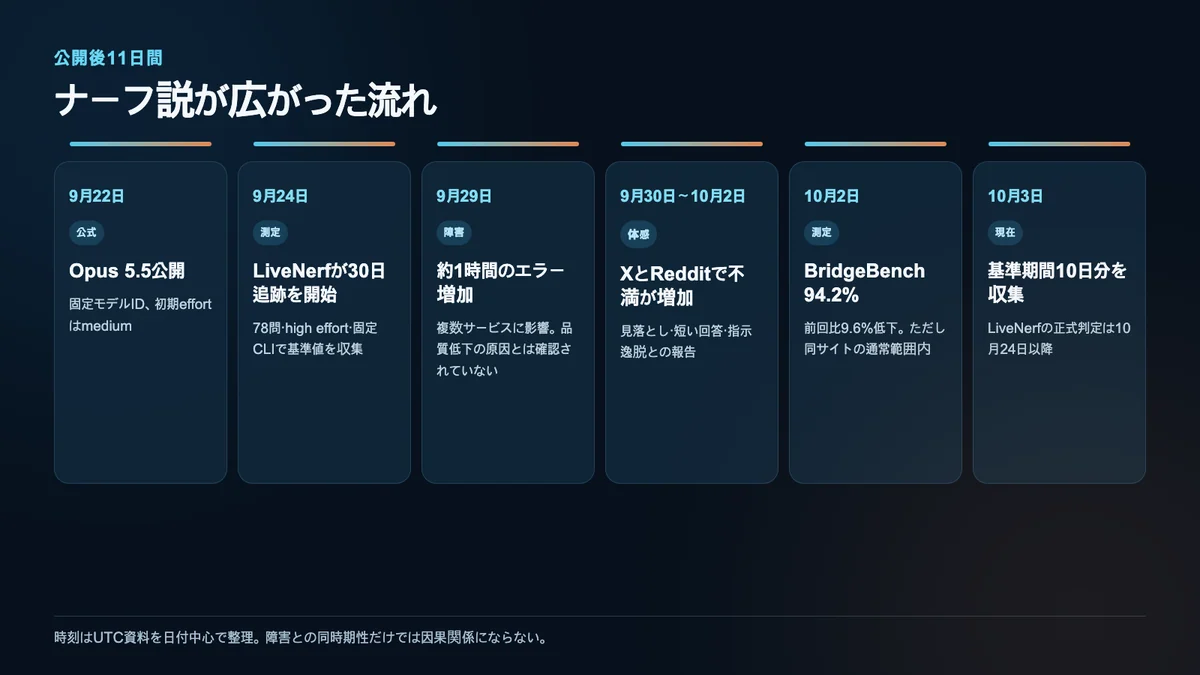
AnthropicのOpus 5.5公式発表によれば公開日は9月22日。LiveNerfは9月24日に日次測定を始めた。9月29日には複数のClaudeサービスで約1時間エラーが増え、9月30日以降にXとRedditの不満が目立った。10月2日にBridgeBenchが94.2%を掲示し、10月3日にLiveNerfの基準期間10日分がそろった。
順番が近いことは因果関係ではない。Claude公式ステータスは9月29日の障害を確認できる一次記録だが、その障害が翌日以降の回答品質を継続的に下げたとは記していない。10月2日と3日に別の障害が載っていないことも、定性的な品質問題が一切なかった保証にはならない。日時は仮説を絞るために使い、原因の証明とは分けて読む必要がある。
LiveNerfが固定した78問
LiveNerfの公開リポジトリは、公開直後から同じ物差しを保とうとする試みだ。GPQA Diamond、MMLU-Pro、競技数学、AIME 2025・2026の2,336問を各4回調べ、いつも正解またはいつも不正解の問題を外した。残った「正解することも失敗することもある」78問は、MMLU-Pro 59問、GPQA 12問、競技数学4問、AIME 3問で構成される。
主要パネルは明示的なhigh effortで毎日一回実行される。Claude Code 2.1.280とハーネスのハッシュを固定し、空の作業フォルダ、短い固定システム指示、一ターンを使う。ツール、MCP、設定、hook、メモリ、CLAUDE.mdは読み込まない。採点はexact matchで、変化しうる別のLLM審査員を使わない。Opus 5を対照群に置き、両モデルが同時に動けば環境側の変化を疑う。
10日間で主要パネルは78×10の780サンプルになった。リポジトリにある「一日90サンプル」は対照群を含む全呼び出しの範囲で、780は主要パネルだけの数だ。数字の母集団をそろえれば矛盾しない。
10日分は結果ではなく基準値
1〜10日目は公開時の基準、11〜20日目が第一比較期間、21〜30日目が第二比較期間だ。事前登録ルールでは、二つの比較期間で99%区間がともにゼロをまたがず、変化が3ポイント以上で、対照群には同じ動きが出ないことを求める。最初に正式な判定が可能になるのは10月24日ごろである。
公開週がモデルの「真の通常状態」とは限らない。新しい配信基盤、容量の偏り、公開直後の不具合で最初の週が悪い可能性もある。LiveNerfは低下だけでなく改善も同じ規則で報告する。基準値を見てすでに下がったと判断すると、比較する前に結論を入れることになる。
小さな変化を見逃す可能性
設計上の最小検出可能差は10日区間あたり約7.5ポイントだ。2〜5ポイント程度の実在する変化は捉えられない場合がある。検証時にOpus 5へ置き換えた試験も、得られたサンプルでは99%基準でOpus 5.5と区別できなかった。同系列の小さな差を何でも見抜ける装置ではない。
問題自体にも限界がある。78問と後に除外した2問を報告目的で監査すると、誤った可能性のある解答キーが8件、曖昧な問題が30件あった。結果を見て都合よく削除せず、あらかじめ定めた感度分析で影響を見る方針だ。研究上は誠実だが、パネルの曖昧さまで消えるわけではない。
さらに測定対象は、一台・一地点のMax契約からheadless Claude Codeで提供されるOpus 5.5である。API、通常のclaude.ai、長い日本語会話、ウェブ検索、MCP、実リポジトリでの複数ターン作業を直接測っていない。購読版利用者の報告に近い一方、Claude全体へ一般化してはいけない。
BridgeBench 94.2%の正しい読み方
BridgeBenchのOpus 5.5履歴は、10月1日に103.8%、10月2日に94.2%を示した。前回から9.6ポイント下がり、公開時より5.8%低い。監視対象にするには十分な動きだ。しかし同ページは90〜110%を通常変動と定めている。94.2%だけを切り取り「同サイトがナーフを確認」と言うのは、判定ラベルを逆にする。
BridgeBenchの方法説明によれば、powerは課題性能だけでなくトークンと費用を組み合わせた独自指標だ。掲載された0.6・0.2・0.2の重みは説明用であり、実際の課題、カテゴリ、重みは非公開である。公開された試験も4回だけなので、外部から同じ条件で再実行したり、どの構成要素が変化を作ったか分解したりすることは難しい。
BridgeMindのX投稿も94.2%を伝えながら、通常変動内という条件を残している。現状は警戒シグナルであり、原因や広範囲な弱体化を確定する判決ではない。
65・94.2%・780は別の単位
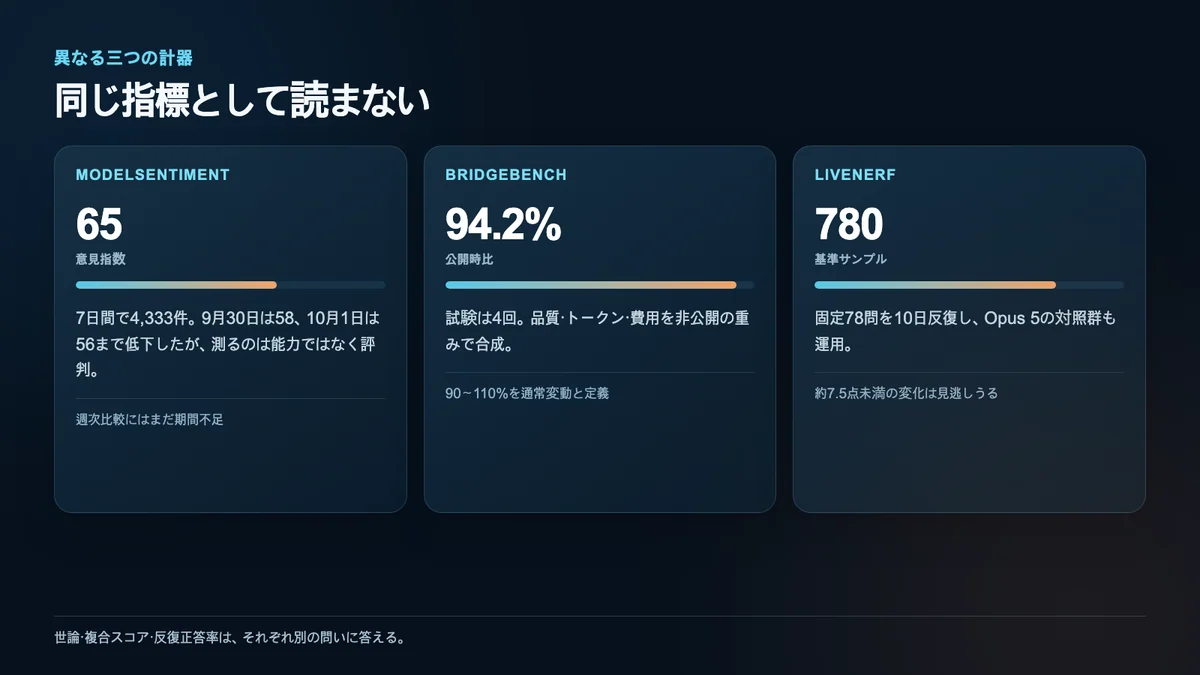
ModelSentimentのOpus 5.5ページは、10月3日08:16 UTC時点で直近7日間の意見4,333件、スレッド1,301件から指数65、区間62〜68を表示した。日別では9月30日に58、10月1日に56まで下がり、進行中の10月3日は73だった。公開後一週間のため、前週との比較はまだできない。
この指数が測るのはReddit上の評判であり、正答率やコードのテスト通過率ではない。不満が集中した日や試すべき失敗類型を探す役には立つが、話題性やコミュニティ構成にも動かされる。BridgeBench 94.2%は非公開重みの複合値、LiveNerf 780は基準サンプル数だ。同じグラフの縦軸に並べられる数値ではない。
日本語Xの二つの投稿から分かること
iwashi86氏のX投稿は10月1日、LiveNerfが同一問題を固定し、公開直後を基準に長期追跡する考え方を日本語で紹介した。重要なのは、当時はまだ結論ではなく測定設計を説明する段階だった点だ。方法の理解を広げる投稿であり、ナーフを判定した投稿ではない。
mecaota氏のX投稿は9月30日、仕事で使った際の品質が突然落ちたという体感を報告した。これは日本の実務利用でどの時期に違和感が生じたかを示す直接的な一次報告だ。一方で、再現用入力、実際の応答モデル、effort、CLI版、複数回の対照結果までは含まれない。無視すべき投稿でも、全体変更を証明するログでもない。
日本語圏では翻訳・要約・長い敬語文・国内サービスの仕様理解など、英語の多肢選択問題と異なる負荷が中心になる。LiveNerfが安定しても日本語ワークフロー固有の回帰が残る可能性はある。だからこそ、Xの体感を採点可能な日本語課題へ変える作業が必要になる。
Redditの混在した反応をどう使うか
LiveNerf Day 8のRedditスレッドは、当時の公開議論へ進むための文脈リンクとしてのみ残した。今回、原文を安定して取得できなかったため、このスレッドを数値、判定、原文表現の比較根拠には使っていない。基準期間と判定時期は公開されたLiveNerfリポジトリで確認し、コミュニティ報告は検証すべき症状であってモデル変更の証明ではないと扱う。
コミュニティ投稿の役割は、日時、製品面、失敗の型を集めることだ。短くなった、要件を一つ落とす、ファイルを戻す、長い会話で計画を忘れる、といった症状を別々のテストに落とせる。多数の異なる症状を「頭が悪くなった」の一語に集約すると、後の検証が難しくなる。
固定モデルIDが意味する範囲
ClaudeのモデルIDとバージョン方針では、Claude 4.6以降の日付なしIDは、そのIDの存続期間中に固定された基盤モデル版を示す。過去の可変な便宜的aliasとは扱いが違う。claude-opus-5-5の同一IDの裏で別の基盤モデルへ密かに差し替えたという強い主張には、この公式保証に反する具体的な証拠が必要になる。
ただし固定されるのは基盤モデルの識別であって、製品全体ではない。安全分類、fallback、アプリのsystem指示、負荷分散、Claude Code、ツール権限、コンテキスト処理、障害は別の層だ。IDが固定されていても利用者向け結果が変化する余地はある。「広範なモデル交換は未確認」と「特定経路の品質問題はありうる」は両立する。
effortの初期値は比較条件を変える
Opus 5.5の変更点では、初期effortがmediumとされ、adaptive thinkingは常時有効である。Opus 5の初期値はhighだった。両方で設定を省略した比較は、モデル名以外も変えている。
ツールの間に出る進行情報がthinking側に移るなど表示も変わった。クライアント設定によっては、処理が続いていても以前より沈黙して見える。出力上限が小さいと、思考と最終回答の配分も影響を受けうる。medium、high、xhighのどれか、出力上限、ツール選択を明示し、回答の長さと課題成功率を別に採点する必要がある。
fallbackとナーフは同じではない
Anthropicのモデル切り替え説明は、特定の安全分類でClaudeアプリやClaude Codeの要求がOpus 5またはOpus 4.8へ切り替わる場合を案内している。公式画面では切り替えと応答モデルを表示する想定で、APIのfallbackは標準で自動適用されるものではない。
これはOpus 5.5自体の重み低下ではない。しかし通知を見落としたり、その後も切り替え先モデルで会話を続けたりすれば、利用者の感覚は突然のナーフに近い。最新入力だけでなくファイル、メモリ、検索結果が判定材料になる場合もある。選択したモデル名だけでなく、各応答に表示されたモデルと通知を残すべきだ。
長い会話は公開直後の新規会話と違う
有料Claudeのコンテキスト説明は、対応環境で最大100万トークンと、限界付近での自動要約を説明している。長いClaude Codeセッションには、廃止した要件、失敗したツール出力、古いパス、圧縮された判断が残る。画面上の一文が同じでも、モデルへ渡る入力全体は同じではない。
問題の会話を保存し、同じコミットで空の会話を作って比べる。新規会話だけ成功するなら品質問題は現実だが、原因候補はコンテキスト管理へ寄る。新規会話でも設定を固定して繰り返し失敗するなら、より広い提供経路の回帰を疑う材料になる。会話を消して最初からやり直す前に、両方を比較可能な形で残すことが大切だ。
日本の利用環境で行う6段階テスト
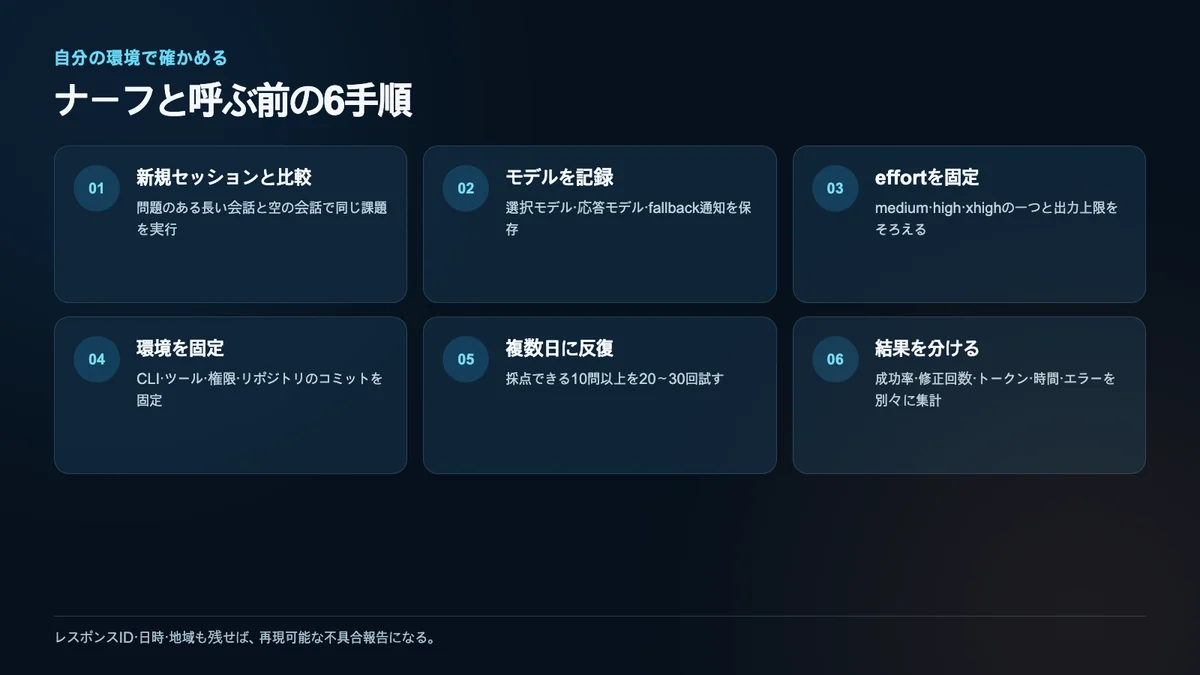
- 失敗した長い会話を保持し、空の会話で同じ課題を実行する。
- 選択モデル、実際の応答モデル、fallback通知を記録する。
- effortを一つに固定し、出力上限も統一する。
- Claude Code、ツール、権限、MCP、リポジトリのコミットを固定する。
- 正解またはテストがある日本語課題を10件以上用意し、複数日に20〜30回試す。
- 成功率、手直し回数、要件漏れ、トークン、所要時間、明示的エラーを別々に集計する。
日時はUTCだけでなくJSTも残す。応答ID、契約種別、地域、アプリ版を添えると、海外の報告との時間対応を確認しやすい。機密文書を公開する必要はないが、入力構造、期待結果、失敗条件を匿名化した最小再現例は支援窓口の調査価値を大きく高める。
今後どの証拠で判定が変わるか
10月24日以降、LiveNerfの二つの比較期間が同方向に事前登録基準を超え、Opus 5対照群が安定していれば、購読版Claude Code経路で測定可能な変化があったという強い証拠になる。日本語の固定課題、APIの固定ID、複数地域でも同じ傾向が再現すれば適用範囲は広がる。Anthropicの障害分析が出れば、モデル外の原因へ帰属できる可能性もある。
反対にLiveNerfが基準内に残り、BridgeBenchも90〜110%の間を動くなら、広範な一律ナーフより、ワークロード、会話状態、routing、ハーネスを絞って調べるべきだ。null結果は個々の体験を否定しない。小さな変化を見逃す力の限界と、実務的な日本語エージェント作業を測っていない範囲があるからだ。
10月3日時点の最終判定
体感急落の報告は調査に値し、測定可能な揺れも一つある。しかし、Claude Opus 5.5全体がナーフされたとの主張はまだ立証されていない。BridgeBench 94.2%は同サイトの通常範囲内、ModelSentiment 65は世論、LiveNerf 780サンプルはこれからの比較に使う基準値である。
今は「確定ナーフ」ではなく「原因未確定の回帰調査中」と表現するのが正確だ。自分の環境を固定して失敗を再現可能にし、10月下旬の判定を待つ。本稿の結論は2026年10月3日のスナップショットであり、新しい反復データが出れば更新すべきものだ。
出典と編集上の告知
- 公開情報: Anthropic, Claude Opus 5.5
- バージョン方針: Claude Platform, model IDs and versions
- 変更点: Claude Platform, what’s new in Opus 5.5
- モデル切り替え: Anthropic Help Center, why Claude switched models
- コンテキスト: Anthropic Help Center, paid-plan context window
- 障害履歴: Claude Status
- 反復測定: LiveNerf
- 複合指標: BridgeBench, Claude Opus 5.5
- 測定方法: BridgeBench, how Nerf Bench works
- 意見指数: ModelSentiment, Claude Opus 5.5
- コミュニティ文脈リンク(判定は非依存): Reddit, LiveNerf Day 8 update
- 当日更新: BridgeMindのX投稿
- 日本語の方法紹介: iwashi86氏のX投稿
- 日本語の体感報告: mecaota氏のX投稿
AnthropicおよびClaudeの名称・商標は各権利者に帰属する。ZoogomはAnthropic、LiveNerf、BridgeBench、ModelSentimentの公式サイトではなく、協賛・承認も受けていない。リンクは検証経路として示し、投稿画面、プロフィール画像、原文表現、表、チャート、UIは複製していない。取得できなかったRedditリンクは、結論が依存しないコミュニティ文脈に限って分類した。本文と画像は公開事実を証拠の種類ごとに再構成した独自の編集物である。